

他们复刻人脑双记忆通路,造出能长效记住上下文的类脑AI芯片
从大脑皮层快慢信息处理机制获得启发,提出双重记忆路径类脑网络并设计配套芯片。该芯片将记忆与计算分离,共享低速记忆模块仅占参数5%–10%,使长时程任务准确率提升至90%以上,语音识别能效比同类方案高5倍。
你对手机说“帮我设一个明天早上6点的闹钟”,它听懂了,乖乖设好。紧接着你又说“改成7点半吧”——如果这个设备用的是普通AI,它大概率会懵掉:啥改成7点半?改什么?因为它压根不记得你刚才说过“闹钟”,它只听到了孤零零的一句“改成7点半”。
这个场景恰恰暴露了当前AI在处理连续信息时的一个软肋:要么目光短浅,只抓眼前那一句话;要么就得拼命烧算力,强行把上下文硬塞进去。而且,一旦涉及声音、手势、动作这类随时间流动的信息,问题就更刺眼了。
帝国理工学院博士后孙鹏飞和苏黎世联邦理工博士后苏哲,带着他们的合作者,从人类大脑皮层里找到了一个解法。两人在瑞士苏黎世联邦理工和苏黎世大学神经信息所相识,随即联手探索这个课题。他们发现,大脑在处理信息时,并不是靠一个统一的速度来干活。
图 | 左起;孙鹏飞、苏哲(来源:资料图)
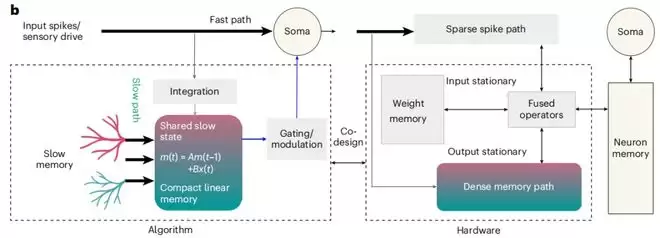
具体来说:前额叶皮层处理信息较慢,所以能扛起整合长期上下文的重任;初级感官皮层处理信息较快,负责捕捉当下的刺激。正是这种快慢节奏的搭配,让大脑既能及时响应,又能记住上下文。
他们把这种机制做成了一个名为“双重记忆路径”的类脑网络,并设计了一款配套芯片。在处理语音识别任务时,这颗芯片的能效比此前最好的方案高出5倍之多。说白了,他们等于把一项从大脑“偷师”的技术,推到了可以装进芯片的程度,让AI不需要太长的上下文也能听明白你在说什么。
(来源:《自然·机器智能》)
孙鹏飞目前在帝国理工学院继续博士后研究,苏哲则加入了美国波士顿的一家芯片公司。近日,他们的成果发表在《自然·机器智能》上。
就像开头那个例子,当下的AI在处理时间信息时存在一个“Bug”。处理一张图片它很厉害——比如著名的看猫实验,给AI看一万张猫的照片,它就学会了认猫。但处理一段声音或视频就完全不一样了:声音是一秒一秒流过来的,上一秒的声音可能影响下一秒的理解,AI必须记住“刚才发生了什么”,才能理解“现在到底发生了什么”。
(来源:《自然·机器智能》)
孙鹏飞和苏哲从大脑里找到了灵感。人类大脑皮层不同区域的神经元有不同的时间常数——有些区域处理信息快,对当下的刺激反应迅速;有些区域处理得慢,能整合过去几秒甚至更长时间的信息。正是这种快慢分区,让大脑既能及时响应环境变化,又能保持对上下文的感知。
他们在类脑网络的每一层里都加了一个共享的小型慢速记忆模块。这个模块用一个很低维度的状态向量来概括过去一段时间的信息——低维度意味着体积很小,只需占用很少的存储和计算资源。这个状态向量能通过网络内部的连接反馈给该层的所有神经元,给它们提供“刚才到底发生了什么”的上下文。
这个思路也体现了两位博士对AI系统的理解:神经网络模块应当是异构的,对应的部署硬件也应是异构融合的。为了进一步提升能效,他们还主张将记忆与计算相分离——记忆模块专注存储和维持上下文,计算模块专注处理当前输入,两者各自独立优化,避免相互干扰和资源争抢,整体架构更精简高效。
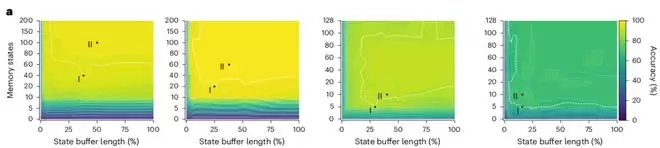
这个记忆模块的大小只占整个网络参数的5%–10%,但效果相当出色。在那些需要处理长时程信息的基准测试里,这套网络的准确率从10%提升到了90%以上。在顺序MNIST数据集上,它更是达到了99%的准确率,比此前最好的同类模型高了将近30%。
这个架构还有另一个关键优势:由于记忆模块是共享的,它的开销不会随着神经元数量线性增长——网络规模越大,这个优势就越明显。在参数量相同的情况下,双重记忆路径网络在准确率上明显优于传统的循环网络和延时网络。
算法设计好了,硬件怎么办?类脑计算一直有个尴尬:算法上的创新往往不考虑硬件能不能跑得动。一些论文固然能发出来,但人们会发现那些精巧的设计在芯片上要么太耗电,要么太占面积,最终只能停留在仿真阶段。
孙鹏飞和苏哲从一开始就在考虑硬件实现问题。设计算法时,他们就在思考:这个记忆模块在芯片上怎么存?怎么读?怎么算?苏哲博士期间研究的就是类脑芯片设计,正是这个背景让他成了算法和硬件之间的“翻译官”。
基于此,他们在算法层面做了几件事来降低硬件开销:
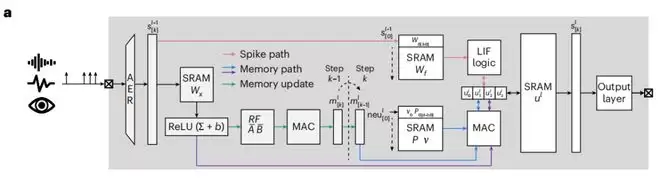
首先,既然记忆模块很小,那就把它放在芯片的片上存储里,无需频繁访问外部内存;
其次,记忆更新和记忆读取可以并行处理,不用花时间排队等待;
再次,让稀疏的脉冲计算和密集的矩阵计算分别采用不同的数据流优化策略,各自进行优化。
这些设计选择也反映在了芯片架构上。他们研发的芯片采用了近存计算架构,把计算单元和存储单元放得很近,减少了数据搬运的距离。芯片内部有四条并行的计算路径,分别负责处理脉冲积分、记忆读取、记忆更新和输出——这四条路径可以同时工作,不用互相等待。
他们把芯片在22纳米工艺上完成后布局仿真,结果显示:这套方案在处理语音识别任务时,能效比同类最好的设计高出5倍以上,吞吐量高出4倍,面积效率也比循环网络架构高出了1倍——原因在于省去了存储循环权重矩阵的空间。
这些数字意味着什么?对于需要长时间连续工作的设备,比如智能手表、AR眼镜和助听器,能效提升5倍就能让电池寿命延长数倍。对于需要实时响应的场景,比如语音助手和手势控制,吞吐量提升4倍意味着更短的延迟和更流畅的体验。
这个芯片架构还有一个优势:不依赖于底层物理实现。既可以像文章介绍的那样,直接在特定工艺下实现优化策略以达到效率最大化,也可以把整套优化策略放在编译器层次实现,再映射到传统计算芯片上。
(来源:《自然·机器智能》)
但这篇论文的意义不只在于能效。它其实展示了一种更根本的思路:算法的设计从一开始就要考虑硬件的限制,而硬件的设计也要适配算法的特点——两者是互相塑造的关系。
硬件的限制乍一看是个麻烦,但反过来可以推动智能的产生。我们的大脑本身就是在各种约束下进化出来的——能量预算只有20瓦左右,却能完成超级计算机都做不到的事。可以说,正是因为能量有限,大脑才进化出了一些高效的编码方式。
据了解,这项研究还在继续。孙鹏飞未来会继续探索“将时间作为一种计算资源”,研究轴突延迟、系统级异构网络融合及其与异构硬件的适配。苏哲在新公司里也在继续研究异构AI系统,类脑计算是其中一个重要方向。目前,该工作已引起多家美国芯片公司的兴趣。
同时,这篇论文的全部代码和硬件设计已经开源,其他同行可以在此基础上继续改进,也可以集成到更大的系统里。这一做法在类脑计算领域并不常见——之前大多数工作只公开算法,硬件设计往往留在实验室。对于个人未来发展,孙鹏飞和苏哲对学术圈和工业界都持开放态度,渴望与优秀的同行共事,也并不排斥可能的创业机会。
参考资料:
相关论文 https://www.nature.com/articles/s42256-026-01255-3
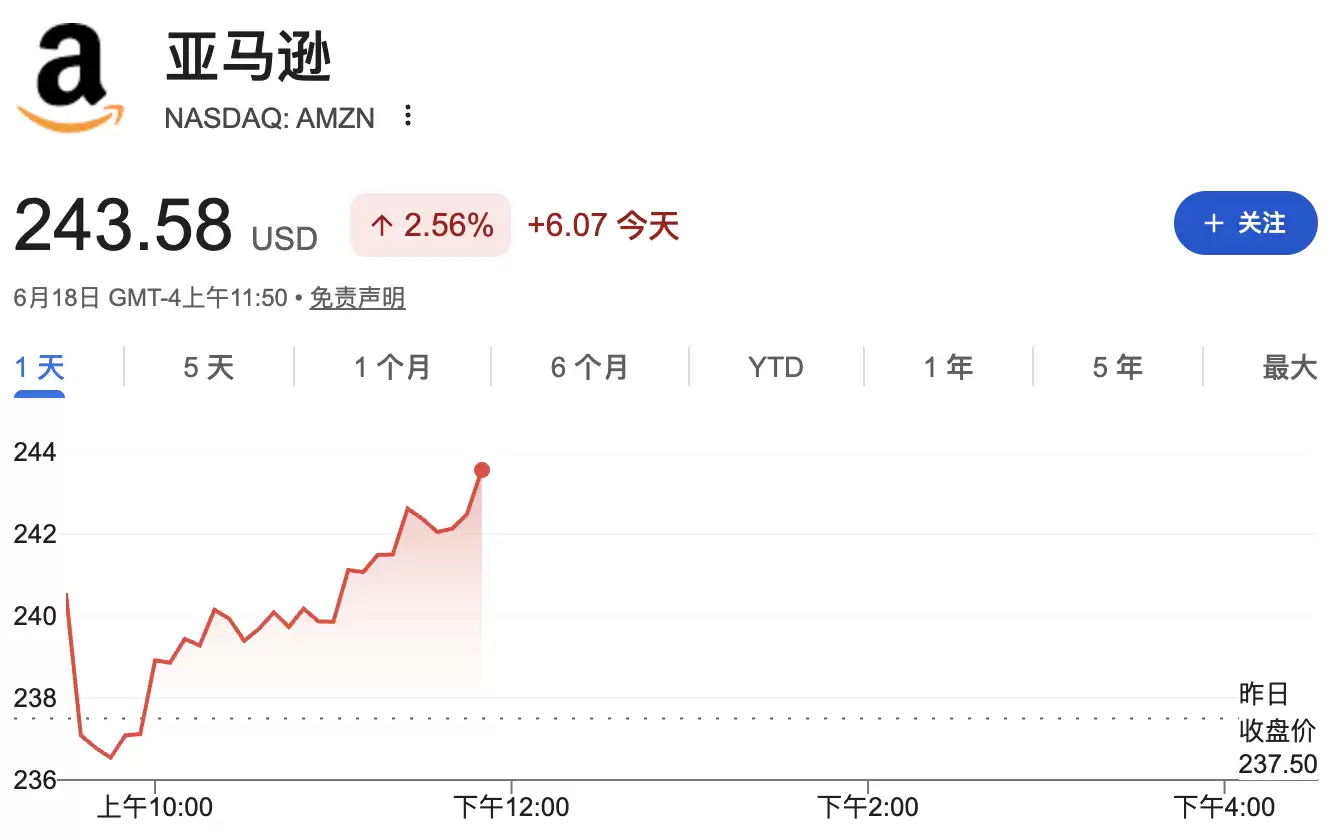
亚马逊计划将自研AI芯片Trainium对外销售,直接挑战英伟达市场主导地位。第三代芯片已售罄,第四代明年发布,累计收入承诺超2250亿美元。欧洲主权计算需求驱动战略转向,同时自研处理器Graviton已向Meta供应。
诺基亚与英伟达合作开发AI6G网络,推动AI芯片从数据中心向电信基础设施渗透。6G算力需求增长,GPU等AI芯片成为核心组件,国产AI芯片企业迎来国产替代窗口,寒武纪、海光信息等持续突破。
近日,高通宣布微软和Meta将采用其人工智能芯片。微软选用基于平价内存的高带宽计算芯片,Meta选用自研处理器DragonflyC1000芯片。另有未具名云厂商正合作开发定制化芯片,意图冲击英伟达市场,挑战其主导地位。
高通公司向微软和Meta供应其最新一代AI芯片。微软采用了高带宽计算架构,使用了普通内存替代昂贵的HBM(高带宽内存);Meta则选用了自研CPUDragonflyC1000;此外还有两家尚未公开的超大规模云厂商正在等待其定制化芯片。
瑞芯微推出面向具身智能的旗舰AIoT芯片RK3588,采用新思科技全流程EDA工具与IP,实现高性能与低功耗突破。该芯片已在服务机器人、工业自动化等领域成功落地,推动端侧AI芯片创新,为具身智能提供强大算力支持。
高通宣布向微软和Meta供应AI芯片,微软将采用基于平价普通内存的高带宽计算架构,以提升AI推理效率并降低成本;Meta则搭载自研CPUDragonflyC1000,该产品计划2028年下半年量产。此外,高通还为另外两家云厂商开发定制AI芯片。
Meta出租算力并非需求见顶,而是以旧养新的现金流管理。高端算力依然紧缺,全球云业务backlog创新高,算力出租价格高企。A股芯片板块调整源于情绪压制,算力需求扩张与国产替代基本面未变。
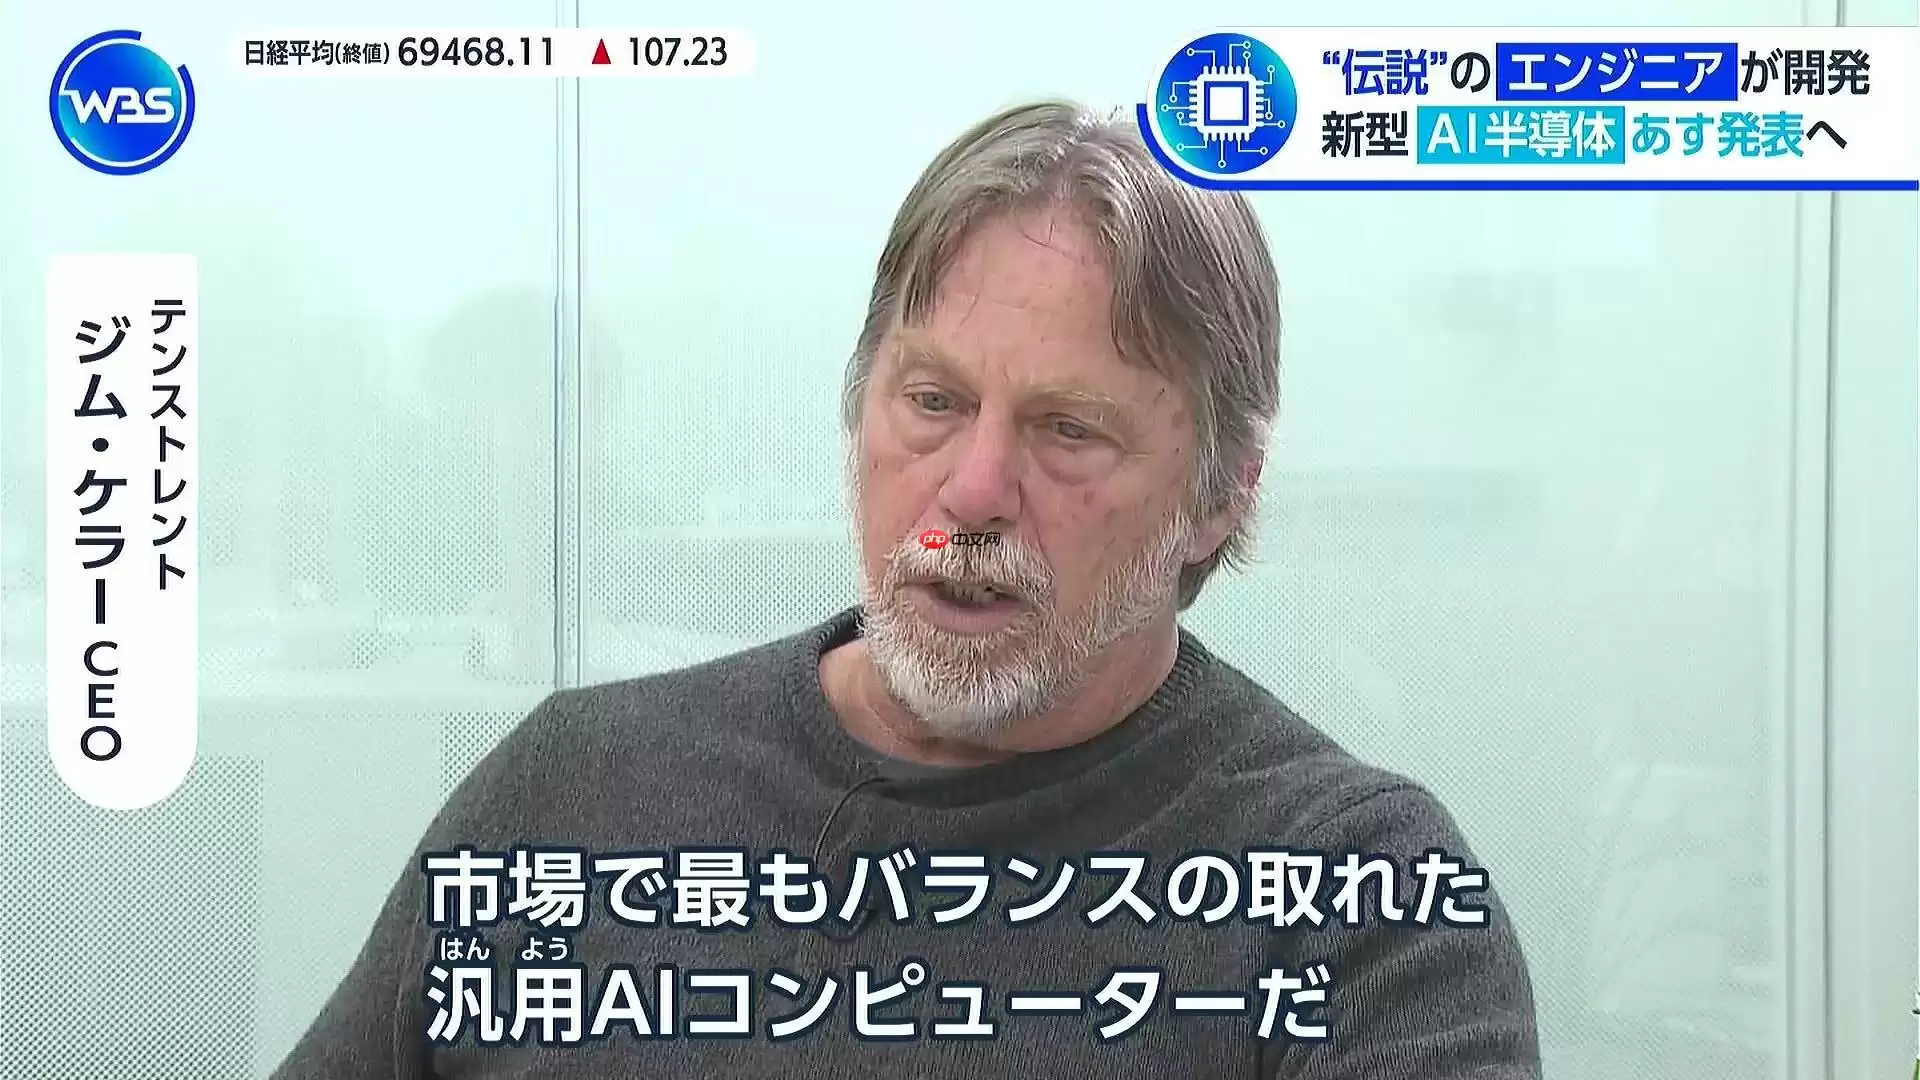
美国芯片公司Tenstorrent研发的“黑洞”AI计算平台已正式登陆日本商用市场,单套系统标价11万美元,仅为英伟达同级别DGX服务器报价的20%,且实测性能宣称达到四倍,性价比极高。该平台采用RISC-V架构,可大幅降低AI推理成本,助力日本企业加速AI部署。
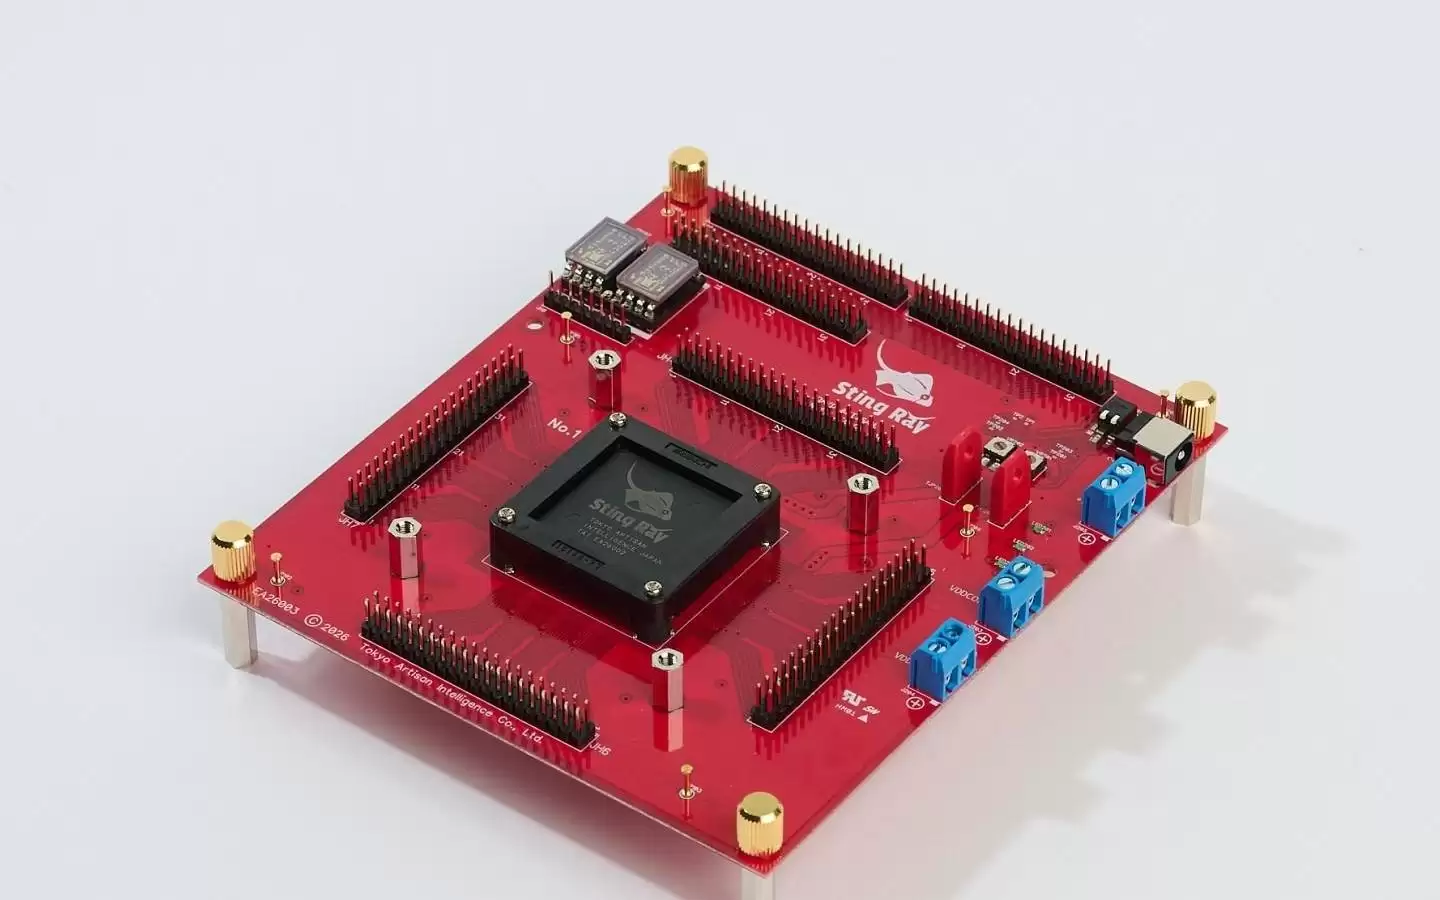
日本芯片初创TAI完成40nm边缘物理AI芯片原型StingRay验证,可灵活适配多AI模型,面向基础设施、工业控制及机器人。下一代芯片MantaRay计划2027年量产。
人工智能芯片企业Cerebras计划2026年底前启用欧洲首批数据中心,随后推进法国和北欧部署,2027年底欧洲总算力达200兆瓦,部分用于支持OpenAI工作负载。此举旨在就近提供低延迟、高性能AI推理算力,满足欧洲本地化需求。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



