

AI改了画面却没改声音?浙大团队首次将一句话编辑视频延伸到音频维度
Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
针对自然语言指令驱动的联合音视频编辑缺乏数据集与评测基准的现状,浙江大学与腾讯团队提出JAVEdit-100k数据集、JAVEditBench评测基准及基线模型。该工作填补充了任务空白,在6项指标中获5项第一,音视频同步性相比最强级联方案提升26%。
自然语言指令驱动的视频编辑,这确实是当前生成式AI里一个很热门的方向。不过有趣的是,现有工作几乎都在纯视觉维度打转——像InsViE-1M、Ditto-1M、OpenVE-3M这些主流大规模数据集,压根没考虑音频编辑。即便是少数尝试把音视频一起编辑的工作,比如A VED、A VI-Edit,也依赖“source-target prompt”或者“掩码+编辑后描述”这类受限范式,跟真实场景中用户直接甩一句自然语言指令就能干活的需求,差距还真不小。
那么问题来了?评测体系同样跟不上趟。视频编辑的benchmark完全忽略了音频维度,音频生成的benchmark又不评测指令一致性,两边各说各话,没有统一标准。
技术层面的挑战更直接:联合音视频编辑要求跨模态的时空与语义严格同步。通常得把多个专用模型级联起来,但这样做,跨阶段的误差就像滚雪球一样越滚越大。当然,有人尝试过“human-in-the-loop”的流水线来缓解,可问题是,这种方法想保证质量的同时大规模扩展,几乎不可能。
针对这些痛点,浙江大学、腾讯团队及其合作者拿出了三样东西:JA VEdit-100k数据集、配套的评测基准JA VEditBench,以及基线模型JA VEdit。
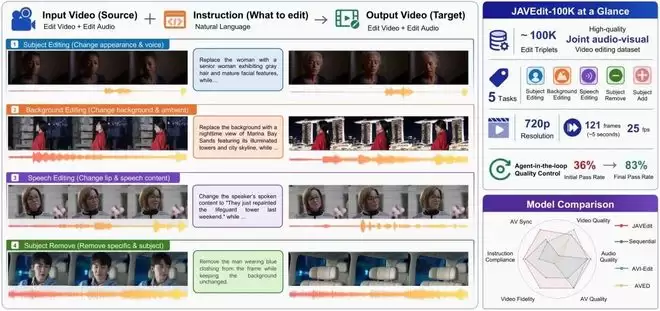
图|JA VEdit 整体概览。
结果很能说明问题:JA VEdit在JA VEditBench的6项指标中拿下了5项第一,音视频同步性相比最强级联方案,直接提升了26%。
论文链接:https://arxiv.org/pdf/2606.03168
代码:https://github.com/RyanChenYN/JA VEdit
数据集:https://huggingface.co/datasets/Coraxor/JA VEdit-100k
研究团队明确指出,这项工作填补了“自然语言指令驱动+联合音视频编辑”这一任务形态在数据集与评测两个维度的空白,是该领域首个大规模高质量资源。那个Agent-in-the-loop质控框架,能把人工介入大幅减少——合格率从36%一路拉到83%,为未来更大规模的多模态编辑数据构建,提供了一套可复用的自动化范式。
实验结果还揭示了一个更深层的生态问题:音频基础模型,眼下成了多模态生态圈的“木桶短板”。团队直言,领域亟需一个能统一支持多种参考-条件音频编辑能力的音频基础模型。
研究方法
数据构造流水线
按照论文描述,源视频要经过预处理→指令生成→类别专用编辑→Agent-in-the-loop质控四阶段,最终产出大约100K高质量联合音视频编辑三元组。
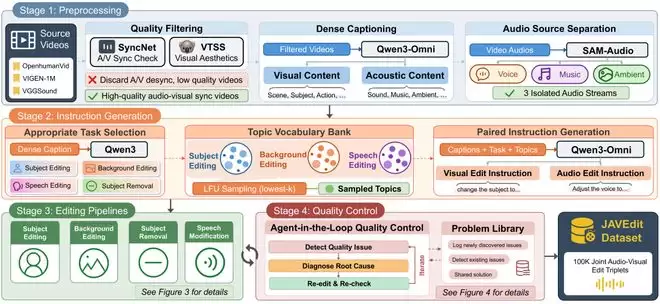
图|JA VEdit-100k 数据构造流水线。
预处理阶段,素材从OpenHumanVid、VIDGEN-1M、VGGSound三个开源源头汇聚。先用LatentSync SyncNet过滤口型与音轨错位的片段,再用Koala-36M VTSS做视觉美学筛选。接着调用Qwen3-Omni生成视觉、声学、时序三类dense caption,最后通过SAM-Audio把每条音频拆乘人声、音乐、环境音三路独立流。
指令生成阶段,由Qwen3-235B先判定每条视频适合哪些编辑任务,再结合人工修订的Topic Vocabulary Bank,用least-frequently-used采样避免主题失衡。最后同时产出语义自洽的视觉+音频成对指令,保证跨模态指令能彼此呼应。
类别专用编辑阶段,针对5类任务设计了4条专用管线:Subject Editing由HunyuanImage-3.0 Instruct接Wan2.2-Animate完成视觉换主体,DreamVoice做声音克隆;Background Editing走HunyuanImage-3.0 Instruct+FFP-300K路线,HunyuanVideo-Foley配合SAM-Audio重建环境音;Subject Removal双路并择优(MiniMax-Remover+SAM3与HunyuanImage+FFP-300K);Speech Editing用Qwen3-TTS零样本克隆后交LatentSync对齐嘴型;Subject Addition则直接复用高质量Subject Removal的数据对并反转输入输出。
最后是Agent-in-the-loop质控阶段,对候选数据闭环运行“检测→记录→修复→复检”,把容易级联放大的局部失误就地拦截。
Agent-in-the-loop 质控框架
质控按三级分类处理:L1系统级,针对模板或逻辑层面的批量缺陷,直接改代码并重跑全批;L2模块级,单个模块参数失当,仅调该模块重跑;L3实例级,对偶发瑕疵,在预算内重试或过滤。经过3轮迭代,1K子集的合格率从36%直接提升到83%。
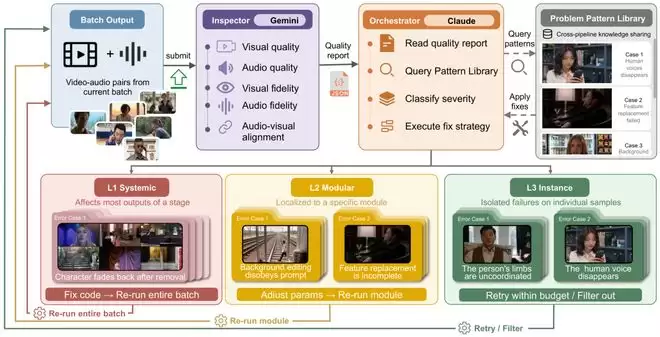
图|JA VEdit Agent-in-the-loop 质控框架。Inspector(Gemini)对小批量数据做高保真审查并产出结构化质量报告;Orchestrator(Claude)负责分类失败、改写流水线代码、调参、协调重试,并把验证有效的修复方案存入 Problem Pattern Library 供跨管线复用。
评测基准 JA VEditBench
现有的视频编辑benchmark全部只评测视觉流,没有任何机制能衡量音频轨道是否被正确修改。研究团队为此构建了JA VEditBench:人工精选150条多样性源视频,人工审核全部编辑指令,并设计了跨5维的6项指标——用VTSS、UTMOSv2、SyncNet覆盖信号层面的视觉质量、音频质量与音视频同步;用Qwen3-Omni覆盖语义层面的Instruction Compliance、Video Fidelity与整体A V Quality。经5名专业标注员在60条视频上的两两偏好实验验证,这6项指标与人类偏好的Spearman相关系数均达到ρ ≥ 0.80。
基线模型 JA VEdit
JA VEdit将LTX-2.3改造为参考条件去噪模型:参考视频、音频与目标在序列维拼接,参考位置赋σ=0、目标位置赋σ>0,二者在RoPE中共享坐标系以建立精确的时空对应。仅在目标位置计算loss,并用LoRA(rank=128)作用于注意力与FFN,在JA VEdit-100k上微调。
研究结果
数据集规模
最终JA VEdit-100k包含103K条高质量编辑三元组,5类任务分布均衡,Speech Editing覆盖32个主题域,统一规格1280×720、121帧、25FPS。
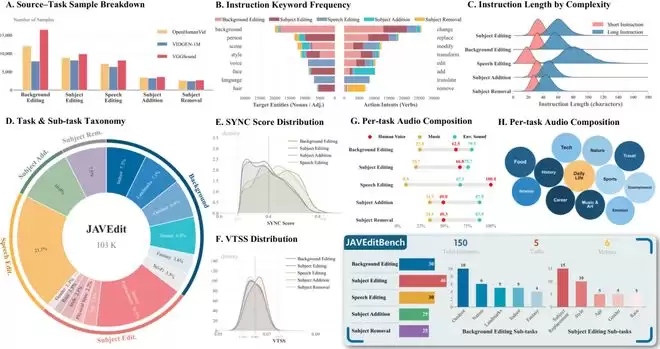
图|JA VEdit-100k 与 JA VEditBench 统计分布。涵盖任务分布、关键词频率、指令长度、SyncNet/VTSS 分布、按任务音频组成、Speech Editing 主题分布等均衡性证据。
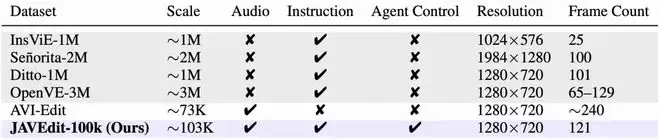
表|JA VEdit-100k 与已有视频编辑数据集对比。JA VEdit-100k 是唯一同时具备「音频 + 指令 + 智能体质控」三项能力的数据集。
定量比较
JA VEdit在6项指标中拿下5项第一:相对A VED与A VI-Edit,在Instruction Compliance与A V Quality上大幅领先;相对最强级联方案,在A V Sync上取得26%的相对增益。A VI-Edit仅在Visual Quality上略胜,这得益于其显式分割掩膜对编辑区域的强约束。
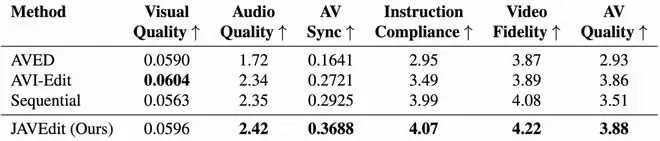
表|JA VEditBench 定量比较。数值越高越好;Sequential = Kiwi-Edit + HunyuanVideo-Foley 级联。
定性比较
A VED与A VI-Edit经常出现过度平滑或语义错位;Sequential视觉上还行,但配音错位明显。相比之下,JA VEdit在视觉一致性、指令忠实度与跨模态时序同步性上整体最稳定。
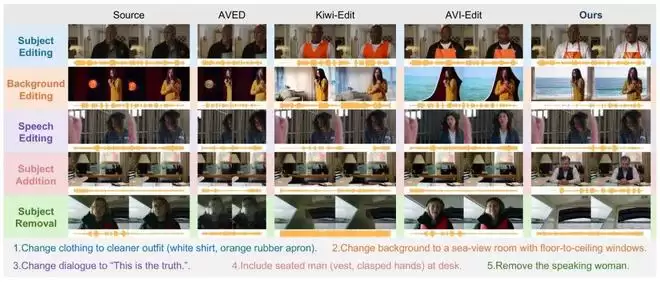
图|JA VEditBench 定性比较。
消融实验
5K→15K→100K,性能持续提升;同规模下移除Agent QC,6项指标全面下滑。这清楚地说明,数量与质量不可互相替代。
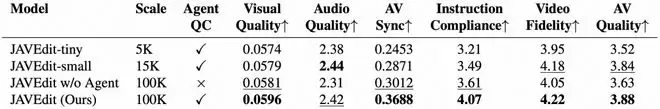
表|消融实验。
不足与未来方向
当前工作仍存在三点局限值得后续深入。
第一,数据集聚焦人物中心场景,开放域泛化能力有待验证,未来需要扩展到更广泛的环境音、场景与主体类别。
第二,复杂指令的成功率仍受底层基础模型能力上界的限制,对接更强的视频与音频生成基础模型是提升上限的直接路径。
第三,当前模型主要由文本指令驱动,引入参考图作为额外条件,将支持“以图指示外观/风格”的更直观编辑范式,进一步降低使用门槛并提升可控性。
实验同时揭示了一个更深层的生态问题:现有音频大模型对参考-条件下的生成与编辑支持相当有限。没有任何单一模型能同时胜任“保持节奏的仅音色编辑”与“保持音色的仅内容编辑”这两类截然相反的需求。必须警惕的是,领域亟需一个能统一支持多种参考-条件音频编辑能力的音频基础模型。
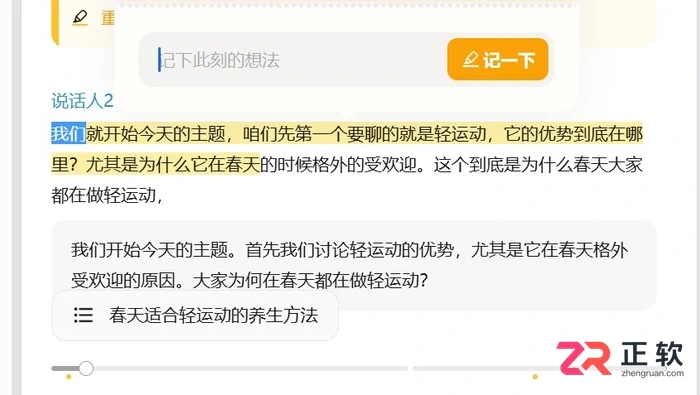
录音中点工具栏的记一下即可打点,也可直接输入短文字做书签,转写后在文稿里点标记跳回对应录音,配合标签和AI纪要快速整理。
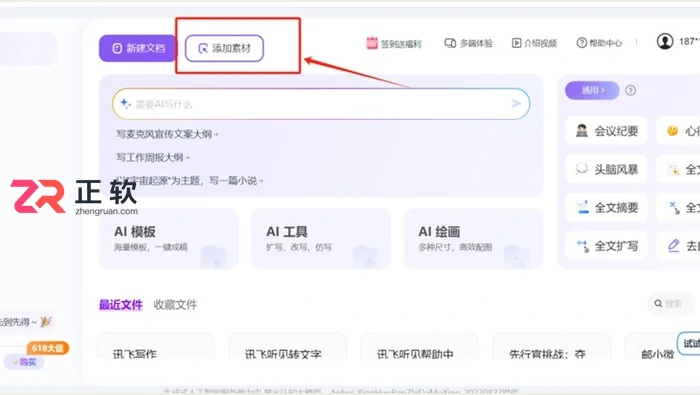
在文稿页进AI写作,把录音稿作为素材勾选进去,选职场或公众号模板生成初稿,再用扩写、缩写、改写逐段打磨,最后导出Word。
蛙蛙写作完成小说后,直接投稿容易遗漏平台规则、章节顺序和版本差异。本文讲发布条件、章节导出、投稿预览及线上线下版本管理,让最终提交内容更完整。
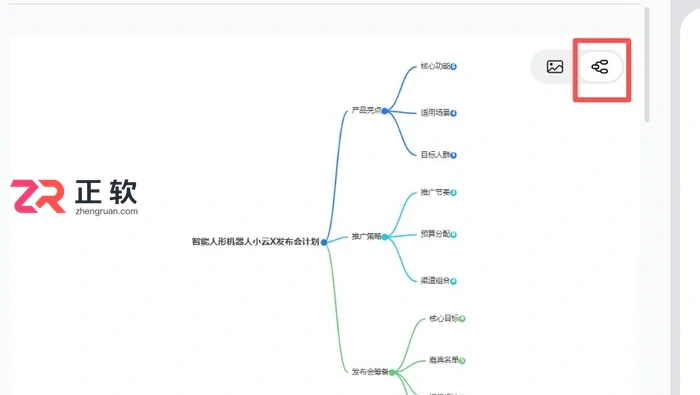
打开转写稿进AI纪要,切到思维导图视图即可自动生成层级节点树,节点可改可拖;它挂在AI纪要下面,不在导出或设置里。
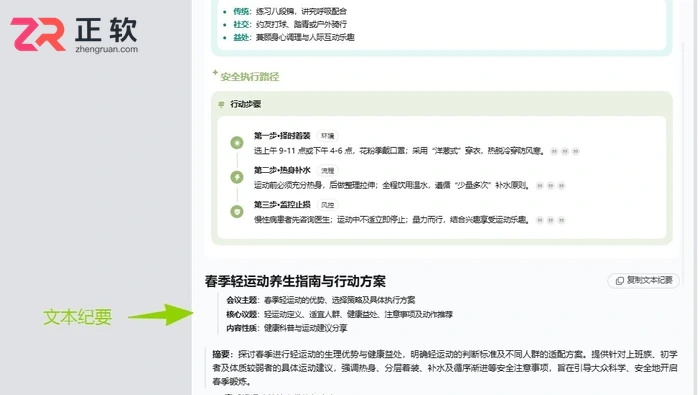
打开转写稿点顶部AI纪要,自动生成摘要、章节要点和待办,每条可点回原文定位;右上角导出选Word或PDF,导出范围记得勾上原文。
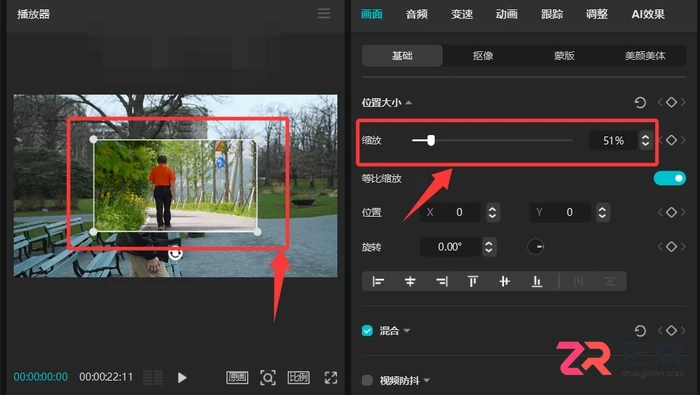
选中视频段,右侧属性栏最右的「AI 效果」里选超清画质,挑强度后云端处理;锐化和特效补不回分辨率,源文件压缩过重时效果有限。




基本都是 Chromium 单核,在「关于」里能看到具体内核版本;单核更轻快,但只支持老 IE 的站点需另找办法。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



