

人工智能多模态技术在苹果研发中的最新进展
译者|布加迪审校|重楼如果我告诉你,在最近热议的多模态AI背后,苹果正在悄然酝酿一场革命,你会作何感想?苹果的一群研究人员一直在系统地研究如何构建功能最强大的多模态模型,揭露了质疑传统智慧的重要见解。现在他们让我们有机会一窥底层的细节。他们的研究工作可能会改变我们对待多模态项目的视角。但要理解其中的原因,你需要搞清楚其研究方法和发现结果的细节。以下是本人对苹果研究论文的解读。本人在这篇文章中将介绍以下内容:他们测试的架构方面的具体取舍以及真正最重要的方面。他们如何以一种非常有意识的方式混合数据来实现最先进
译者 | 布加迪
审校 | 重楼
如果我告诉你,在最近热议的多模态AI背后,苹果正在悄然酝酿一场革命,你会作何感想?苹果的一群研究人员一直在系统地研究如何构建功能最强大的多模态模型,揭露了质疑传统智慧的重要见解。现在他们让我们有机会一窥底层的细节。
他们的研究工作可能会改变我们对待多模态项目的视角。但要理解其中的原因,你需要搞清楚其研究方法和发现结果的细节。以下是本人对苹果研究论文的解读。
本人在这篇文章中将介绍以下内容:
- 他们测试的架构方面的具体取舍以及真正最重要的方面。
- 他们如何以一种非常有意识的方式混合数据来实现最先进的小样本(few-shot)学习。
- 为什么他们的扩展定律和训练方法对于任何建立多模态模型的人都至关重要。
- 证明苹果模型的出色功能的具体例子,从多图像推理到OCR。
- 本人对这项研究工作的潜在影响所持的看法,以及它提出的一些开放性问题。
本文将给出严谨的技术解读和通俗易懂的主旨概述。最后,你对这项开创性的研究以及它如何改变AI未来会有一番清晰的认识。
引言
多模态AI已经取得了快速发展,Flamingo、EMu2和MoLLa等模型展示了结合视觉和语言理解的潜力。然而,许多这些模型并没有深入地揭示其架构选择和训练过程背后的基本原理。
苹果的MM1论文介绍了一系列多模态AI模型,深入解释了如何构建结合视觉和语言理解的高性能系统。通过广泛的消融研究和系统实验,该团队发现了构建高性能多模态模型方面的关键见解。他们的发现结果揭示了不同架构选择、数据混合策略和扩展方法的相对重要性。
通过分享最先进的小样本学习的“配方”,论文作者们使更广泛的研究社区能够在他们的研究工作基础上更有作为。从长远来看,这里的开创性技术可以推动将视觉和语言理解深度整合的新一代基础模型。
本人在本文中将逐步介绍论文的关键部分,涵盖他们的方法、结果、讨论和结论;也将解释技术细节,同时提供浅显的解读,主要围绕主旨及其意义。在此过程中,本人将分享自己的分析,并着重介绍这项研究工作提出的一些开放式问题。
技术解释
论文作者着手研究如何构建高性能的多模态语言模型(MLLM)。他们系统地分析了两个关键因素:1)架构组件,比如图像编码器和视觉语言连接器;2)预训练中的数据选择。
为了有效地评估设计方面的选择,他们使用拥有12亿参数LLM的基本配置。他们通过每次修改一个组件,面对VQA和字幕任务评估零样本和小样本性能的影响来进行消融。
就架构而言,他们测试不同的预训练图像编码器(不同的目标、数据和分辨率)和视觉语言连接器。就视觉语言连接器而言,他们测试了平均池化、注意力池化和一个叫做C-Abstractor的卷积ResNet块。令人惊讶的是,特定的连接器架构对性能几乎没有影响。就预训练数据而言,他们结合使用带字幕的图像、交错的图像-文本文档和纯文本数据。
结果
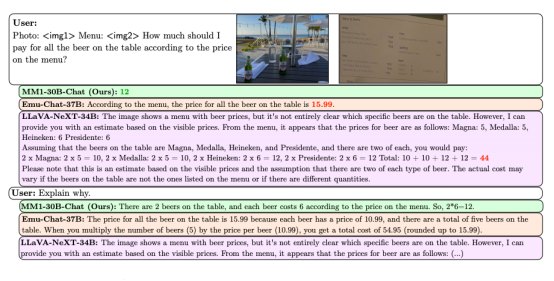
图1. MM1可以跨图像执行指令和推理。来自VILA的示例和图像。在思维链的提示下,VILA正确回答
与Flamingo、IDEFICS、EMu2相比,最终的MM1系列可扩展至300亿个参数,在关键基准测试中获得了SOTA小样本测试结果。
至于架构方面,研究人员发现(按重要性排序):
- 图像分辨率具有最大的影响,从224px到336px有约3%的提升。
- 图像编码器大小和预训练数据也很重要,从ViT-L到ViT-H提升幅度小于1%。
- 视觉语言连接器设计选择的影响可以忽略不计。
至于预训练数据方面:
- 交错数据对于小样本和纯文本性能至关重要,可以提升10%以上。
- 字幕数据改善零样本最明显。
- 合成字幕帮助小样本(+2-4%)。
- 仔细混合模态(5:5:1比例的字幕,交错和文本)效果最好。
与Flamingo、IDEFICS、EMu2相比,最终的MM1模型可以扩展到300亿参数,在关键基准测试中获得了SOTA小样本结果。
论文作者证明了他们在监督式微调(SFT)后获得的训练前见解。MM1表现出令人信服的特性,比如多图像推理、OCR和上下文小样本学习。
有意架构和数据选择的MM1配方在扩展后带来了高性能。论文作者希望这些见解能够适用于具体实现之外的更广泛环境。
浅显的解释
要点是,苹果的研究人员做了一系列实验,以查明构建能理解图像和文本的AI模型的最佳方法。
他们测试了不同的模型组件,比如编码图像的部分和连接图像和文本的部分。他们发现有些方面很重要(图像分辨率和编码器大小/数据),而其他方面其实不重要(连接器设计)。
在训练模型时,他们还尝试混合不同类型的数据。比如加有字幕的图形、文本和图片混合在一起的文档以及纯文本。关键似乎要有多样性——这有助于模型处理不同的情况,比如描述图像或回答问题。
当他们把这一切结合在一起,使模型变得非常大(300亿参数)时,它最擅长从仅仅几个例子中学习。它拥有一些出色的功能,比如针对多个图像进行推理、读取图像中的文本,甚至解释自己的输出。
简而言之,秘密武器是有意地处理模型组件和训练数据。通过分享这一秘诀,这些研究人员正在为新一代功能强大的多模态AI系统铺平道路。
批判性分析
不妨考虑一下MM1研究工作的几处注意事项和限制:
- 评估基准:论文作者特别指出,当前的评估集以字幕为中心。为此优化的模型可能无法推广到其他多模态任务。我们需要更多样化的基准。
- 扩展定律:将超参数外推到更大的规模有风险。可能会出现小规模测试中并未出现的稳定性问题。在训练大模型时,需要仔细监控。
- 合成数据:虽然合成字幕有帮助,但生成的数据有限制。过度优化可能会导致奇怪的失效模式。使用须谨慎。
- 偏见/公平性:没有分析输出或训练数据中的社会偏见。为了负责任的部署,这需要仔细审查,尤其是针对从网上抓取的数据。
- 硬件访问:消融使用了一个有12亿参数的型号,但最终系统是300亿参数。在算力有限的情况下,获得的见解可能不太适用。我们还需要研究“小模型”设计。
论文作者确实承认有改进的余地,比如扩展视觉编码器、改进视觉语言桥接和迭代评估套件。
除了研究人员承认的局限性外,本人认为关于MM1方法还有一些更深层次的问题值得讨论。比如说,严重依赖从网上抓取的数据让人们对训练集的代表性和潜在偏见引发担忧。同样值得考虑的是,这里确定的特定架构选择和扩展定律是否可以推广到视觉和语言之外的其他模态,或者扩大到更开放的生成式任务。在这个领域参与这些更广泛的辩论将加强这项研究工作的影响。
结论
我们能从苹果的MM1论文中学到什么呢?
首先,这篇论文为训练高性能的多模态模型提供了更清晰的路线图。如果深思熟虑架构和数据选择,并认真扩展,我就能发掘出色的小样本学习和推理能力。
其次,论文提出了该领域的关键的开放性问题。我们如何建立全面测试多模态技能的基准?对于通用模型来说,数据模式和任务的正确组合是什么?在保持性能的情况下,我们又可以将模型尺寸做得多小?
三是,论文为基础多模态模型方面的开放研究确立了新标准。通过详细介绍训练过程和释放消融,作者使业界能够复制和扩展他们的研究工作。这对加快整个行业的进展至关重要。
展望未来,MM1论文有望成为多模态AI研究领域的一块重要里程碑。通过为模型设计和训练提供严谨的经验基础,论文为该领域的未来发展奠定了基础。虽然它是否会带来类似于GPT-4的变革性影响还有待观察,但本文给人的见解可以指导研究人员继续推动多模态系统的最高性能。当然,实现这个潜力将需要持续的努力来利用和扩展这些发现结果,同时也竭力解决上面强调的局限性和开放性问题。
就本人而言,我很期待看到这方面会带来怎样的发展。
原文标题:Apple is working on multimodal AI. Here's what they've uncovered so far,作者:Mike Young
想了解Claude怎么收费?本文梳理了Claude Free、Pro及Team版的最新月费价格、消息限额与高级功能权益,并对比了不同层级的性价比,助你快速找到适合的AI办公伙伴。

本文详细解析Sora在国内的使用现状,指出目前官方未对公众开放注册,提醒用户警惕虚假链接,并提供关注官方动态及替代方案的实用建议。
南京邮电大学“光擎智算”团队联合南京大学,攻克GaN基Micro-LED器件技术,成功搭建实验室级光计算验证系统。团队自主研发的5×5 Micro-LED光电计算阵列芯片已进入流片封装阶段,实现了图像识别等算力任务验证,推动光计算技术从理论走向工程落地。

苹果与铠侠签署为期3-5年的NAND闪存长期供应协议,且可能不设价格上限。此举旨在应对AI数据中心需求激增导致的芯片供应紧张,从单纯压价转向确保稳定供货。
一项研究揭示大语言模型在文本嵌入任务中表现平庸的根源:反嵌入矩阵边缘频谱引入高频词偏见。提出的EmbedFilter方法通过滤除该噪声,在MTEB49项任务上显著提升性能,且无需重新训练,兼容多种基线方法。
2026年世界人工智能大会将于7月17日至20日举办,超过300款人工智能新品全球首发,1400多位嘉宾参会,近140场论坛,展览面积超过10万平方米,促成意向合作金额达162亿元,并且推出首个自主举办的国际顶级人工智能学术会议。
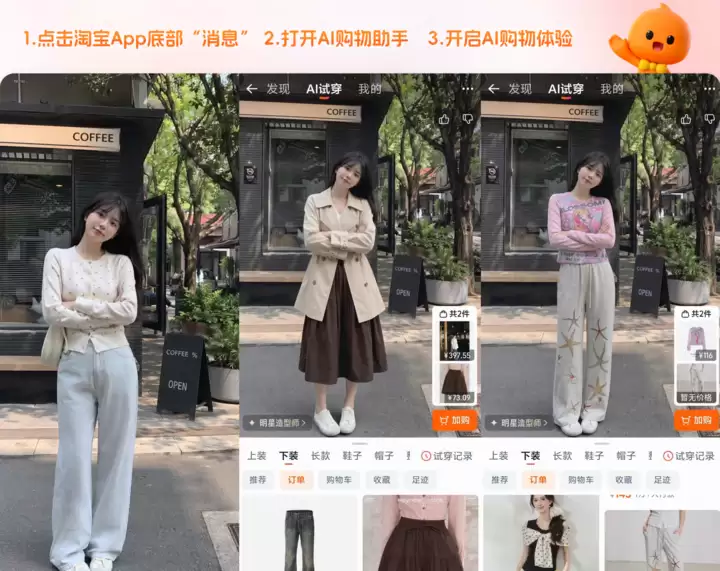
618”期间,AI全面渗透电商,超百万商家使用AI工具提升效率。政策补贴拉动绿色智能家电及汽车消费,市场回暖。供应链升级实现仓配一体化,时效大幅提升,多链协同激活内需活力。
AI生成作品虽完美却缺乏“活人感”,这一悖论贯穿艺术史。《红楼梦》中已批判套路化创作。真正活人感源于创作者内化形式美规律后的即兴发挥与平衡,而非单纯拒绝美化。能否尊重生活细节、容忍碰撞,决定作品是否鲜活,这也是艺术的根本功用。
商务部等8部门发布《关于加快“人工智能+消费”发展的实施意见》,围绕服务消费和商品消费两大领域,明确居家、养老、文旅、教育等场景的AI应用方向,推广智能家居、养老机器人等产品,并适度超前布局城市智能设施。
商汤与香港科技园合作共建国产AI算力中心,目标2030年前实现超40000P算力规模,首阶段预计今年完成。该中心配备国产GPU集群,支撑模型训练与推理,服务本地及国际客户。商汤临港AIDC已有4.04万P算力运营经验。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



