

k8s以及云原生相关概念近年来一直比较火热,阿丸最近搞了个相关项目,小结一下。本文将重点分享阿里开源项目otter适配k8s部署的改造过程,其中的改造过程和技巧应该适用于将大多数开源项目改造到k8s进行部署。 1.背景 otter是阿里开源的分布式数据库同步系统,基于数据库增量日志解析,并准实时同步
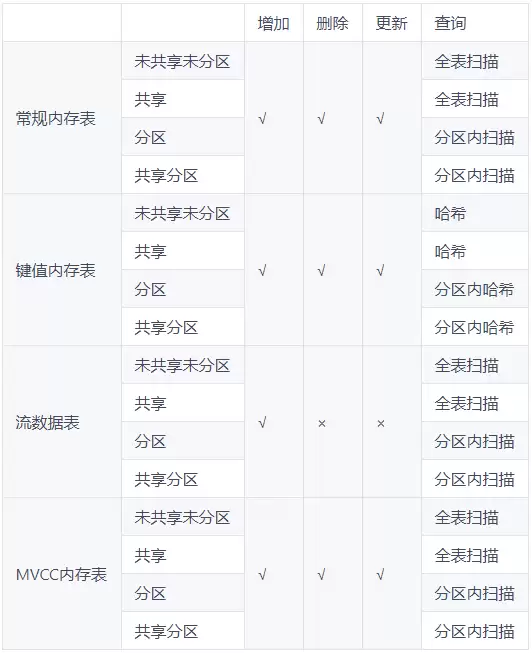
内存表是DolphinDB数据库的重要组成部分。内存表不仅可以直接用于存储数据,实现高速数据读写,而且可以缓存计算引擎的中间结果,加速计算过程。本教程主要介绍DolphinDB内存表的分类、使用场景以及各种内存表在数据操作以及表结构(schema)操作上的异同。 1. 内存表类别根据不同的使用场景以
混沌工程随着云原生的发展逐渐进入大家的视野,通过混沌工程可以很好地发现和解决在云原生化过程中的高可用问题。阿里巴巴在 2019 年开源了底层的混沌工程工具- chaosblade,今年年初再次开源混沌工程控制台 chaosblade-box,ChaosBlade 品牌进一步升级。本文主要围绕云原生面
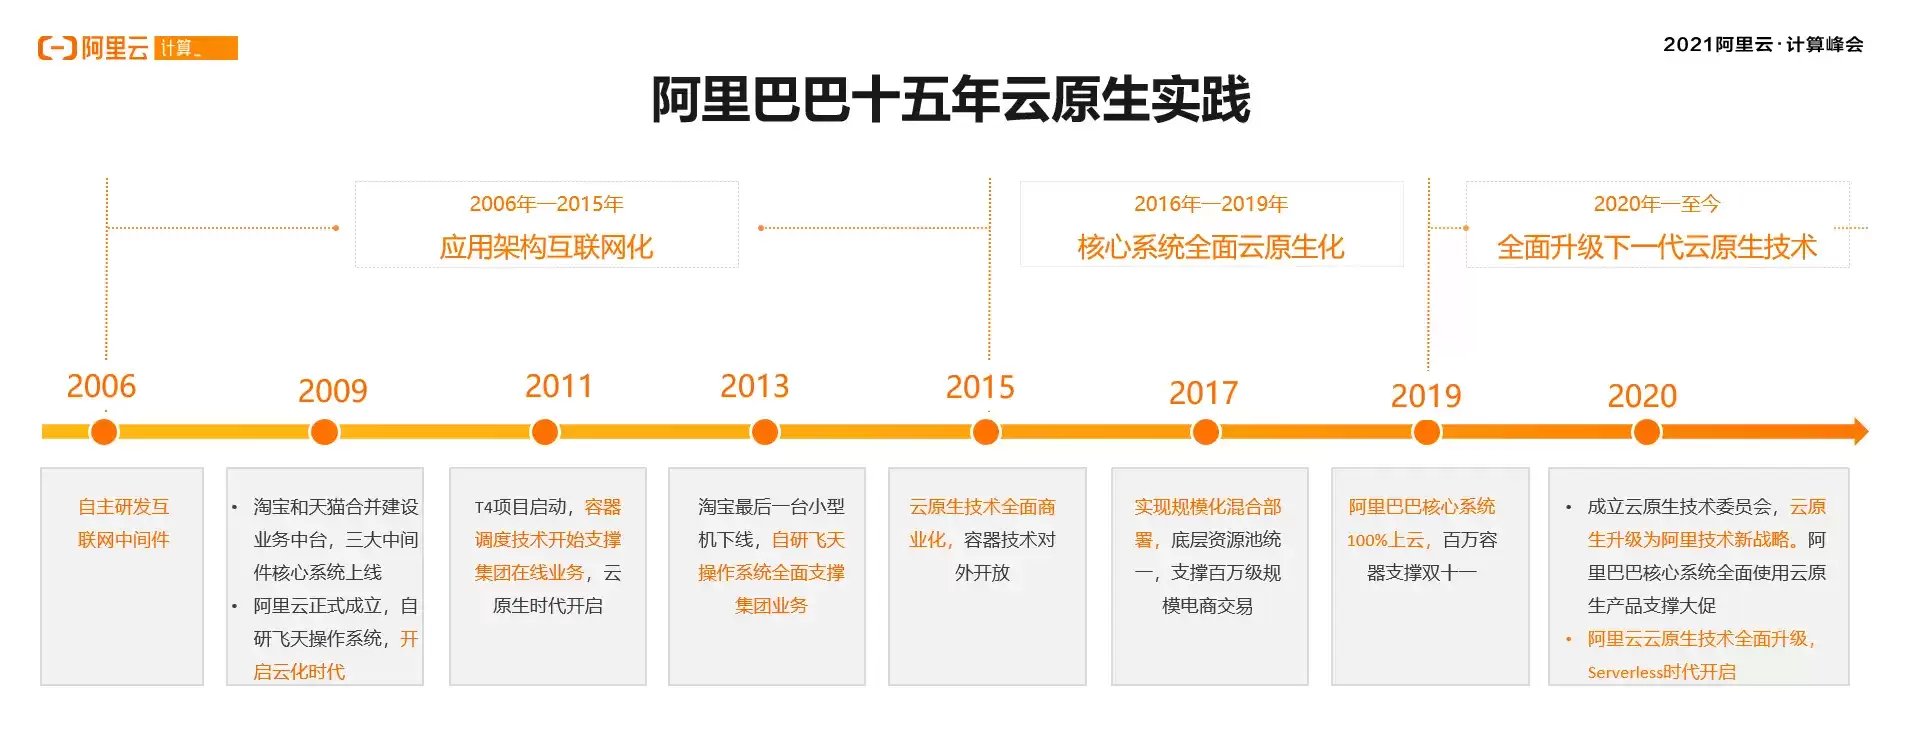
今天,数字化成为企业的核心竞争力,千行百业都在拥抱云计算,拥抱云原生。2020年我们认为是云原生的落地元年,那么2021年将是云原生加速推动企业数字创新的关键节点。在3月29日阿里云计算峰会上,阿里巴巴研究员、阿里云智能云原生应用平台负责人丁宇(叔同)发表了《云原生,企业数字创新的最短路径》主题演讲
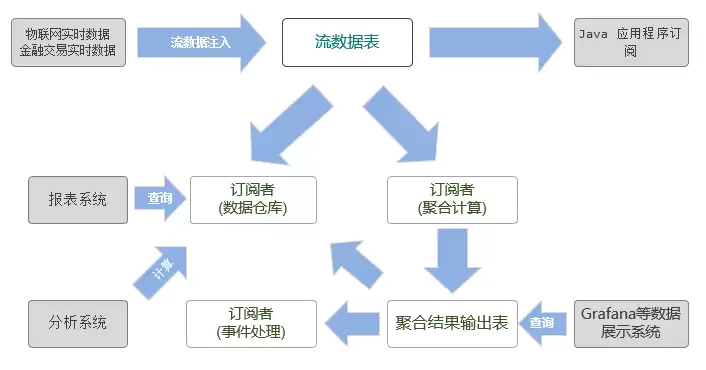
实时流处理一般是将业务系统产生的数据进行实时收集,交由流处理框架进行数据清洗,统计,入库,并可以通过可视化的方式对统计结果进行实时的展示。传统的面向静态数据表的计算引擎无法胜任流数据领域的分析和计算任务。在金融交易、物联网、互联网/移动互联网等应用场景中,复杂的业务需求对大数据处理的实时性提出了更高
一、什么是FlinkXFlinkX是一款基于Flink的分布式离线/实时数据同步插件,可实现多种异构数据源高效的数据同步,其由袋鼠云于2016年初步研发完成,目前有稳定的研发团队持续维护,已在Github上开源(开源地址详见文章末尾),并维护该开源社区。目前已完成批流统一,离线计算与流计算的数据同步
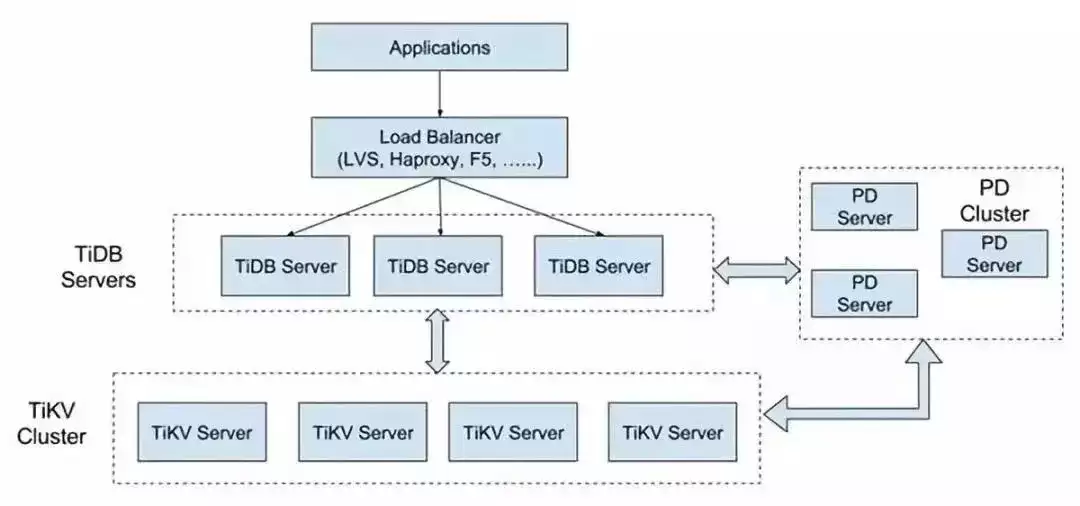
随着互联网的发展,业务越来越庞大,客户群体也越来越多,所要存储的数据也越来越多,慢慢的就出现了分库分表的中间件。比如cobar,TDDL,atlas,sharding-jdbc,mycat等,都是非常优秀的产品,解决了各种问题,但是引入了中间件肯定就会增加各方面的维护成本等这篇带大家了解一款替代分库
简介 对任何企业及应用来说,数据模型都是应用的基石之一。在设计数据模型时,除了需要考虑业务数据的要求之外,还应该思考一些有可能会影响应用程序设计的问题。比如,是否需要数据库表行级的安全机制?是否需要使用软删除?是否需要 CRUD API,如果需要的话,谁来干这个枯燥的活? 事实上,JPA 已经是 J
前言大家都知道,NodeJS作为后端开发语言和运行环境,在高并发支持和开发效率方面有口皆碑,但大多用于数据CRUD管理、中间层聚合和中间层代理等工具场景,很少深入到业务领域的核心。不少采用NodeJS开发的最小可用产品(MVP)最终都要另起炉灶重构,这也是其中一个原因。深究起来,NodeJS作为业务
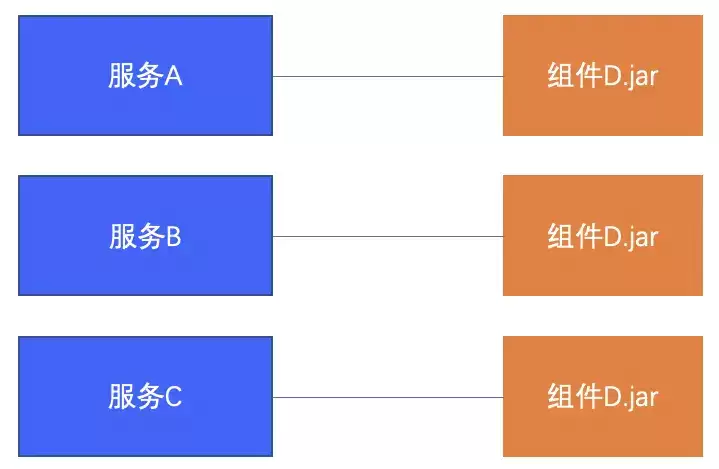
随着业务系统的复杂性越来越高,系统之间的调用也越来越多,在微服务拆分和迭代过程中,是不断的拆分出新的独立的服务还是封装独立的组件以jar包依赖的方式提供服务是我们经常需要面对的问题,本文将详细探讨这两种不同的方式区别、各自的优劣势及适用的场景,希望能够对大家有所启发。一、组件化&服务化定义随着公司互





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。
