

编程开发
遍历Map时禁止直接调用put()或remove(),否则会引发ConcurrentModificationException或数据不一致。唯一允许的修改是通过Map.Entry.setValue()更新值。安全方案包括使用setValue()、先收集待修改项再批量操作、采用ConcurrentHashMap的replaceAll(),或通过流生成新的Map
通过数组构建状态机转移表,将当前状态与输入事件映射为二维表格,查表驱动状态流转。在LED模式切换中,利用转移表控制off、blink、on三种模式,通过动作函数更新变量,无需条件分支,代码轻量可维护。
Java常量池本身不会直接崩溃,但滥用intern()向池中强制入池大量唯一字符串会导致内存溢出:JDK1.6触发永久代OOM,JDK1.7+耗尽堆内存。循环中调用intern()并强引用字符串是典型风险模式。应优先复用字面量或用Map显式缓存,避免在循环内调用intern()。
使用with块绑定临时文件生命周期(NamedTemporaryFile自动清理),或atexit注册删除函数,或局部变量配合try/finally显式删除。需避免mktemp竞态、析构延迟及误用shutil.rmtree。
ArkTS的@provide是UI层装饰器,用于组件树内响应式状态共享,不能实现跨模块异常处理器注册。跨模块异常处理器需通过包扫描、自动配置声明及@Bean注册完成。应区分UI状态变量与运行时注入变量,避免架构错位。
将百万级元素存入ArrayList本身不直接触发GC,但默认扩容机制导致约20次数组复制与废弃,加剧Eden区压力,提高YoungGC频率,甚至诱发FullGC。预设容量或调用ensureCapacity可消除扩容,使YoungGC次数下降80%以上,FullGC几乎消失。配合固定堆大小与ZGC或G1GC收集器,可进一步稳定内存水位。
synchronized锁的是对象而非变量,锁信息存储在对象头的MarkWord标记位中。通过JOL工具可观察锁升级过程:无锁态(001)、偏向锁(101)、轻量级锁(00)、重量级锁(10)的标记位切换。变量需封装在对象中,通过锁住该对象间接保护其状态。
静态块在类加载时执行,此时Spring容器未启动、无事务上下文,且缺少错误重试与环境感知能力,不适合用于数据库Schema同步。应采用Flyway或Liquibase等专业工具在应用启动早期可控执行,或通过@PostConstruct方法在容器就绪后校验结构,配合标准发布流程实现自动化管理。
在Java中动态注入当前用户上下文,推荐通过构造方法显式传入用户对象,清晰且可测试。可配合Spring的请求作用域Bean自动注入,避免使用实例初始化块或全局单例。进阶场景可结合工厂模式实现条件化注入。
模块化强封装通过将单例类置于未导出未打开的私有模块包中,并配合JVM禁用非法反射,可有效提升反射攻击门槛。结合枚举实现的双重防护与运行时模块上下文校验,能彻底阻断反射破坏单例。
原子类的getAndUpdate()方法基于CAS循环与函数式接口UnaryOperator,实现基于当前值的原子更新并返回旧值。适用于条件更新、状态机跃迁等复杂业务,强调函数需幂等、无副作用,避免长耗时。与updateAndGet()返回新值、accumulateAndGet()接收二元操作相区别。
PathMatcher的glob语法不支持{env}等变量名匹配。可先用glob粗筛候选路径,再通过正则提取变量值;或直接采用regex方案配合完整路径正则匹配,后者更精准但需注意性能。
介绍使用PythonKubernetes客户端库操作集群的方法,涵盖库安装、配置文件加载、集群连接,以及Pod、Deployment、Service、ConfigMap、Secret和自定义资源等资源的创建与管理,实现自动化部署与运维。
很多 Python 初学者学完基础语法之后,都会很自然地遇到一个问题: 怎么能把网页里那些看起来零零散散的内容,给“薅”下来,变成自己能处理的数据呢? 比如: 抓取文章标题 提取商品名称和价格 收集招聘信息 批量整理博客链接 分析网页中的表格和列表 这时候,BeautifulSoup 往往就是最适合
基于Python的python-docx库可程序化操作Word文档,实现批量生成与格式统一。该库支持创建和修改段落、设置对齐与缩进,精细控制Run级的字体、颜色、加粗等属性。能创建表格、合并单元格、动态增删行,插入图片并调整尺寸,以及通过底层API添加超链接。整个流程覆盖从环境安装到复杂排版,显著提升办公自动化效率。
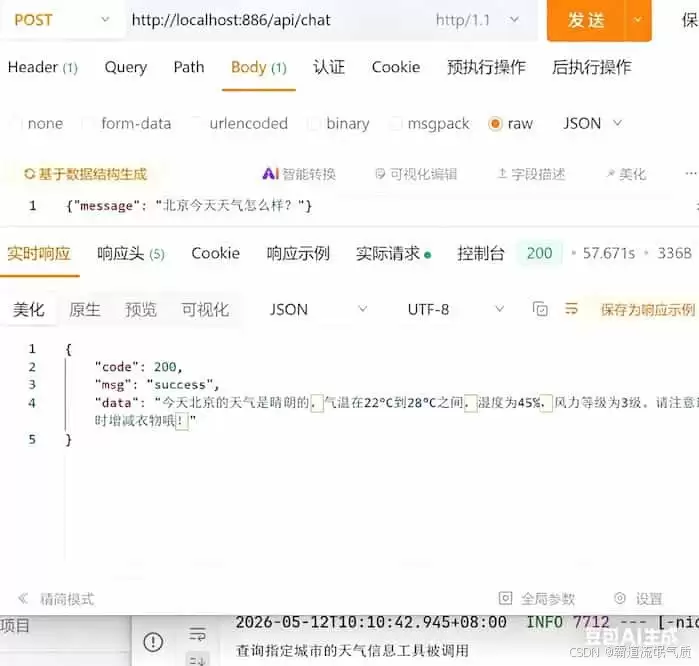
基于SpringAI与Ollama实现本地大模型工具调用,通过@Tool注解定义工具方法并注册至ChatClient,模型自动决策调用外部工具获取实时信息或执行计算。需使用支持函数调用的模型如qwen2.5:7b,SpringAI自动生成JSONSchema,日志调试可观察调用过程。
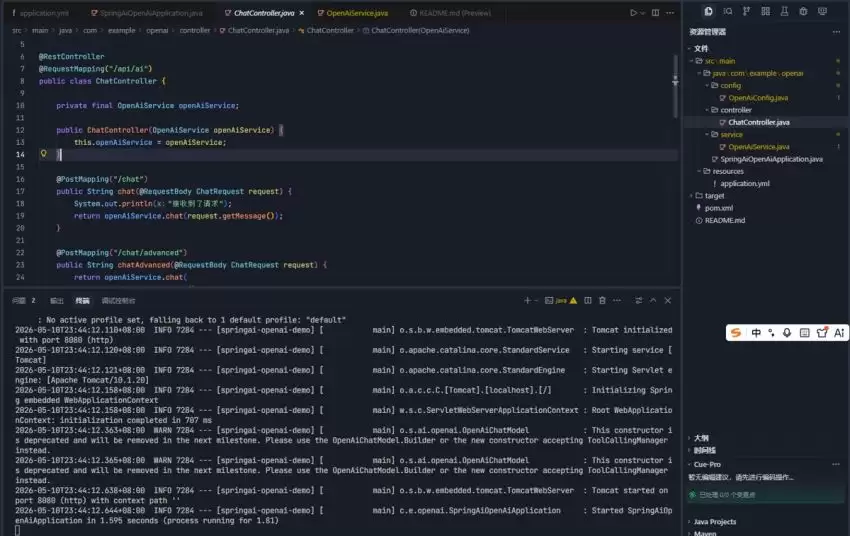
SpringAI框架对接大模型时常见易错点包括访问地址错误、鉴权失败、模型类型不匹配及依赖版本不兼容。解决需规范配置BaseURL与APIKey,显式指定模型名称,统一依赖版本,先调通接口再开发,从而快速定位异常并落地业务功能。
在Ubuntu上调教Ja va内存,说白了就是跟JVM(Ja va虚拟机)的参数打交道——堆内存、非堆内存、垃圾回收这些都得安排明白。下面一步步来,保证让你看完就能上手。 先来个全景图:整个过程分几步——确认环境、搞懂参数、选配置方式、验证效果、再根据监控调优。别急,一个一个说。 1. 查看当前Ja
说到Rust和Linux这对组合,整体上其实是挺搭的——Rust作为系统级编程语言,在系统编程、驱动开发这类底层场景里确实有两把刷子。不过,语言特性、生态成熟度加上Linux内核本身的特殊性,还是让两者之间出现了一些需要仔细琢磨的兼容性问题。 一、Linux内核中的Rust集成挑战 Rust想正式成
当一个系统级语言在Linux上跑起来,它的内存管理机制决定了它的下限。而Rust,恰恰是从设计思想层面就把内存安全写进了编译器里的那一类。我说它在Linux下的内存管理,核心逻辑其实没变——所有权、借用、生命周期、智能指针,这一套组合拳打下来,省去了GC的负担,又堵住了C/C++里那些令人头疼的指针
要说Rust在Linux系统编程中的硬实力,有几个关键优势确实值得深挖。从内存安全到性能表现,再到并发控制和开发体验,每个角度都藏着值得关注的细节。下面逐一拆解。内存安全:编译阶段就把高危错误挡在门外Rust的所有权系统和借用检查器可不是摆设——它们能在编译期强制约束内存访问,彻底绕开C/C++里那
Rust语言在Linux中的性能测试方法,其实是个不小的课题。从简单的代码微基准到高并发下的系统压测,再到持续集成中自动化的性能守护,每一步都有对应的工具和门道。下面就从最基础的说起。 一、基准测试(Benchmarking):量化代码性能 基准测试,说白了就是给代码掐秒表,看看一段逻辑到底跑多快。
IDEA无法识别Maven快照依赖的原因是项目模型缓存(外部构建系统)未更新。清除缓存只清除索引缓存,而快照版本时间戳变化导致重新加载失败,缓存卡在旧路径。手动修改库配置文件中的时间戳或触发一次成功的重新加载即可解决。


火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



Autodesk Maya 是面向影视、电视、动画和游戏行业的专业三维制作软件,集多边形与 NURBS 建模、角色绑定、关键帧和动作捕捉动画、Bifrost 特效模拟、材质开发及 Arnold 渲染于一体,


