

Python爬虫入门实例代码分析
爬虫技术基础概念爬虫:自动获取网络数据的程序。Web页面结构:HTML、CSS、JavaScript等。HTTP请求:客户端向服务器请求数据的方式。HTTP响应:服务器返回给客户端的数据。请求与响应使用Python的requests库发送HTTP请求。importrequestsurl="https://www.example.com"response=requests.get(url)获取响应内容html_content=response.textHTML解析与数据提取使用BeautifulSoup库解
爬虫技术基础概念
请求与响应
使用Python的requests库发送HTTP请求。
import requests

url = "https://www.example.com"
response = requests.get(url)
获取响应内容
html_content = response.text
HTML解析与数据提取
使用BeautifulSoup库解析HTML内容。
from bs4 import BeautifulSoup

soup = BeautifulSoup(html_content, "html.parser")
使用CSS选择器或其他方法提取数据。
title = soup.title.string
实战:爬取简书网站首页文章信息
发送请求,获取简书网站首页HTML内容。
import requests
from bs4 import BeautifulSoup

url = "https://www.jianshu.com"
response = requests.get(url)
html_content = response.text
存储数据
将数据存储为JSON格式。
import json

with open("jianshu_articles.json", "w", encoding="utf-8") as f:
    json.dump(article_info_list, f, ensure_ascii=False, indent=4)
测试与优化
1.遇到反爬虫策略时,可以使用User-Agent伪装成浏览器。
headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3"}
response = requests.get(url, headers=headers)
2.使用time.sleep()函数控制请求频率。
import time

time.sleep(10)
3.错误处理与异常捕获。
try:
    response = requests.get(url, headers=headers, timeout=5)
    response.raise_for_status()
except requests.exceptions.RequestException as e:
    print(f"Error: {e}")
网站爬虫完整代码:
import requests
from bs4 import BeautifulSoup
import json
import time

def fetch_jianshu_articles():
    url = "https://www.jianshu.com"
    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3"}

    try:
        response = requests.get(url, headers=headers, timeout=5)
        response.raise_for_status()
    except requests.exceptions.RequestException as e:
        print(f"Error: {e}")
        return

    html_content = response.text
    soup = BeautifulSoup(html_content, "html.parser")
    articles = soup.find_all("div", class_="content")
    article_info_list = []

    for article in articles:
        title = article.h3.text.strip()
        author = article.find("span", class_="name").text.strip()
        link = url + article.h3.a["href"]

        article_info = {"title": title, "author": author, "link": link}
        article_info_list.append(article_info)

    return article_info_list

def save_to_json(article_info_list, filename):
    with open(filename, "w", encoding="utf-8") as f:
        json.dump(article_info_list, f, ensure_ascii=False, indent=4)

if __name__ == "__main__":
    article_info_list = fetch_jianshu_articles()
    if article_info_list:
        save_to_json(article_info_list, "jianshu_articles.json")
        print("Jianshu articles saved to 'jianshu_articles.json'.")
    else:
        print("Failed to fetch Jianshu articles.")
补充
为了更好地理解这个实战项目,我们需要了解一些基础概念和原理,这将有助于掌握Python的网络编程和爬虫技术。以下是一些基本的网络爬虫概念:
HTTP协议:超文本传输协议(HTTP)是一种用于传输超媒体文档(如 HTML)的应用层协议。HTTP协议被用于从Web服务器传输或发布到Web浏览器或其他客户端的数据。
HTML、CSS 和 JavaScript:HTML 是用来描述网页的一种语言。CSS 是用来表现 HTML 结构的样式。JavaScript 是网页编程的一种脚本语言,主要用于实现网页上的动态效果和与用户的交互。
DOM:文档对象模型(DOM)是一种跨平台的编程接口,用于处理 HTML 和 XML 文档。DOM将文档视为树形结构,其中每个节点代表一个部分(如元素、属性或文本)。
URL:统一资源定位符(URL)是用于指定互联网资源位置的一种字符串。
请求头(Request Headers):在HTTP请求中,请求头包含了关于客户端的环境、浏览器等信息。常见的请求头字段有:User-Agent、Accept、Referer 等。
响应头(Response Headers):在HTTP响应中,响应头包含了关于服务器的信息、响应状态码等信息。常见的响应头字段有:Content-Type、Content-Length、Server 等。
网络爬虫策略:有些网站会采取一些策略来阻止爬虫抓取数据,如:封禁IP、限制访问速度、使用 JavaScript 动态加载数据等。在实际应用中,我们需要根据这些策略采取相应的应对措施,如:使用代理IP、限制爬虫抓取速度、使用浏览器模拟库(如 Selenium)等。
通过实测展示Claude Code在终端中如何理解自然语言指令、自动修改代码文件并处理复杂编程任务,帮助开发者评估其实际辅助能力。
本教程详细讲解如何使用Visual Studio创建WinForms项目,通过添加按钮和标签控件并编写点击事件代码,实现一个基础的计数器功能,适合C#初学者快速上手Windows窗体应用开发。
详解Cursor编辑器中自动补全功能的开启与优化设置,涵盖Tab触发机制、上下文窗口调整及模型切换,帮助开发者解决补全延迟、干扰大等问题,提升编码流畅度。
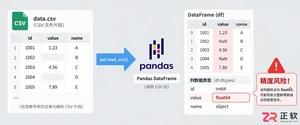
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
详细介绍在Visual Studio Code中安装Chinese (Simplified)语言包的方法,包括通过扩展市场搜索、安装及自动重启切换至简体中文界面的完整步骤,帮助开发者快速将编辑器本地化。
针对Cursor安装包默认锁定C盘且无路径选择界面的问题,提供通过手动移动文件并创建目录联结(Symbolic Link)的解决方案,实现将软件安装在其他磁盘分区。
详解Windows系统下Rust语言的安装步骤,重点解析rustup工具链管理机制,解决环境变量配置错误及MSVC链接器缺失问题,提供可复制的命令验证方法与常见报错的因果排查思路。
详解VS Code中Chat插件的安装与核心配置步骤,重点解决API连接失败、响应慢等常见问题,通过优化上下文设置提升代码生成质量,适合希望集成AI辅助工具的开发者阅读。
本教程通过实战案例详解UniApp开发流程,包括项目初始化、页面结构解析、数据绑定与事件处理,帮助初学者快速上手跨平台应用开发。
详细讲解2026年最新版Android Studio的下载与安装步骤,涵盖JDK环境检查、组件选择及初始配置,助您顺利开启安卓应用开发之旅。



Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。

Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。