

sklearn 中的两个半监督标签传播算法 LabelPropagation和LabelSpreading
标签传播算法是一种半监督机器学习算法,它将标签分配给以前未标记的数据点。要在机器学习中使用这种算法,只有一小部分示例具有标签或分类。在算法的建模、拟合和预测过程中,这些标签被传播到未标记的数据点。LabelPropagationLabelPropagation是一种在图中查找社区的快速算法。它只使用网络结构作为指导来检测这些连接,不需要预定义的目标函数或关于群体的先验信息。标签传播通过在网络中传播标签并基于标签传播过程形成连接来实现。接近的标签通常会被赋予相同的标签。单个标签可以在密集连接的节点组中占主导
标签传播算法是一种半监督机器学习算法,它将标签分配给以前未标记的数据点。要在机器学习中使用这种算法,只有一小部分示例具有标签或分类。在算法的建模、拟合和预测过程中,这些标签被传播到未标记的数据点。
LabelPropagation
LabelPropagation是一种在图中查找社区的快速算法。它只使用网络结构作为指导来检测这些连接,不需要预定义的目标函数或关于群体的先验信息。标签传播通过在网络中传播标签并基于标签传播过程形成连接来实现。
接近的标签通常会被赋予相同的标签。单个标签可以在密集连接的节点组中占主导地位,但在稀疏连接的区域中会遇到麻烦。标签将被限制在一个紧密连接的节点组中,当算法完成时,那些最终具有相同标签的节点可以被视为同一连接的一部分。该算法使用了图论,具体如下:-
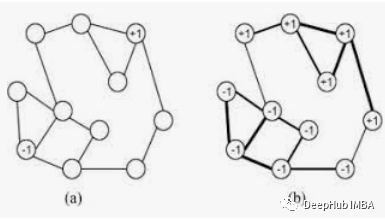
LabelPropagation算法以下列方式工作:-
- 每个节点都使用唯一的标签进行初始化。
- 这些标签通过网络传播。
- 在每次传播迭代中,每个节点都会将其标签更新为最大邻居数所属的标签。
- 当每个节点具有其邻居的多数标签时,标签传播算法达到收敛。
- 如果达到收敛或用户定义的最大迭代次数,则标签传播算法停止。
为了演示LabelPropagation算法的工作原理,们使用 Pima Indians 的数据集,创建程序时,我导入了运行它所需的库
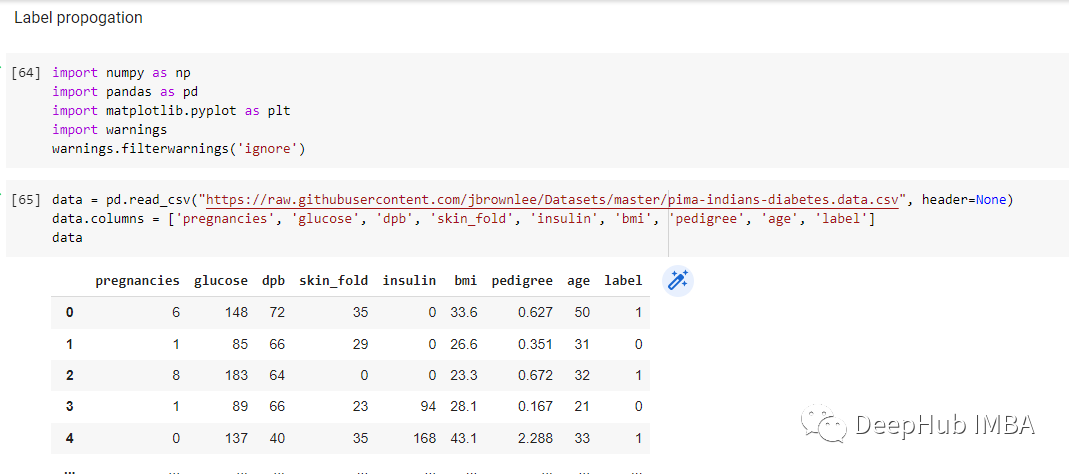
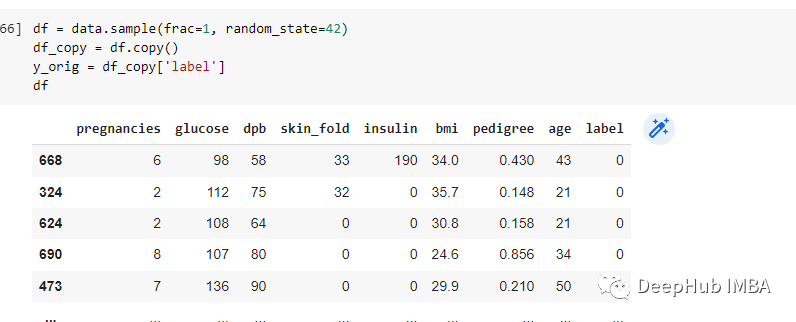
复制一份数据并且将lable列作为训练目标
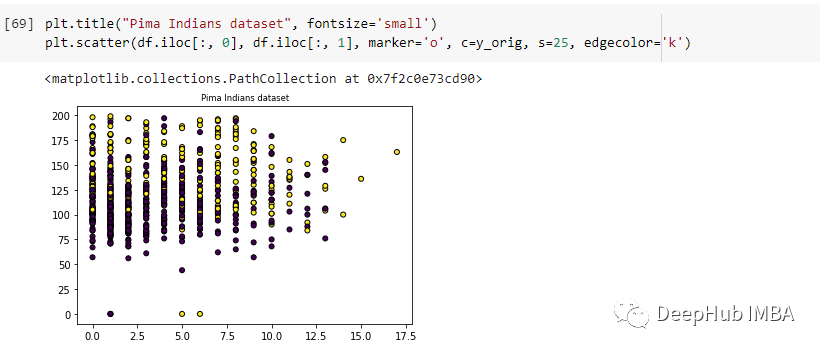
使用matplotlib可视化:
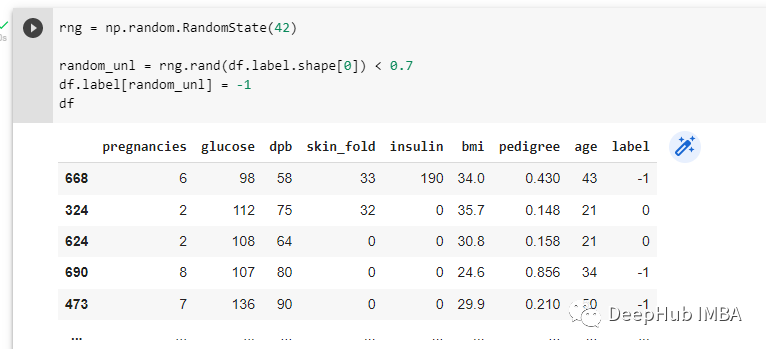
使用随机数生成器随机化数据集中70%的标签。然后随机标签被分配-1:-
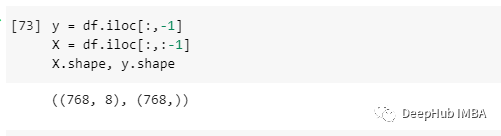
在对数据进行预处理之后,定义因变量和自变量,分别为y和X。y变量是最后一列,X变量是剩下的所有部分:-
使用sklearn的LabelPropagation数来标记所有未标记的数据点:-
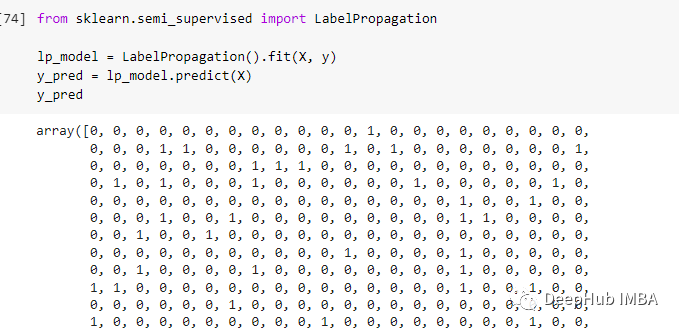
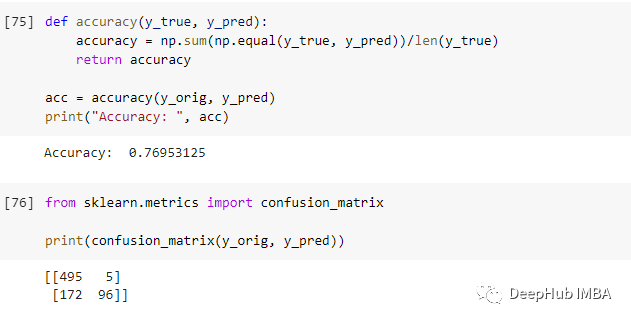
准确率为发现它是76.9%。
下面我们看看另外一个算法LabelSpreading。
LabelSpreading
LabelSpreading也是一种流行的半监督学习方法。创建一个连接训练数据集中样本的图,并通过图的边缘传播已知的标签来标记未标记的示例。
LabelSpreading是由 Dengyong Zhou 等人在他们 2003 年题为“Learning with Local and Global Consistency”的论文中提出的的。半监督学习的关键是一致性的先验假设,这意味着:附近的点可能具有相同的标签,并且同一结构上的点(通常称为簇流形)很可能具有相同的标签。
LabelSpreading可以认为是LabelPropagation的正则化形式。在图论中,拉普拉斯矩阵是图的矩阵表示,拉普拉斯矩阵的公式为:
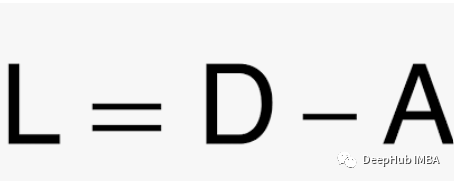
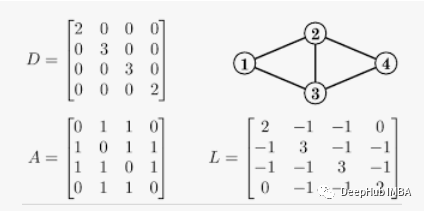
L是拉普拉斯矩阵,D是度矩阵,A是邻接矩阵。
下面是一个简单的无向图标记的例子和它拉普拉斯矩阵的结果
本文将使用sonar数据集演示如何使用sklearn的LabelSpreading函数。
这里的库比上面的多,所以简单解释一下:
- Numpy执行数值计算并创建Numpy数组
- Pandas处理数据
- Sklearn执行机器学习操作
- Matplotlib和seaborn来可视化数据,为可视化数据提供统计信息
- Warning,用于忽略程序执行期间出现的警告
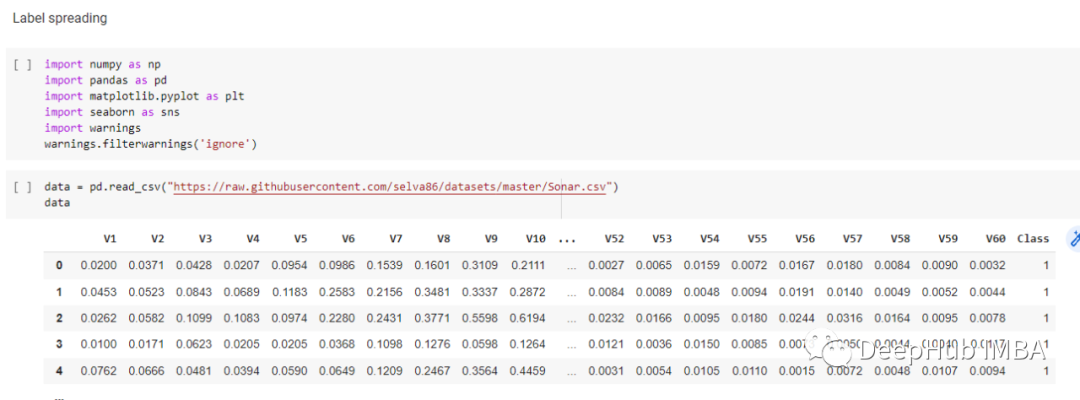
导入完成后使用pandas将读入数据集:
我使用seaborn创建了热图:-
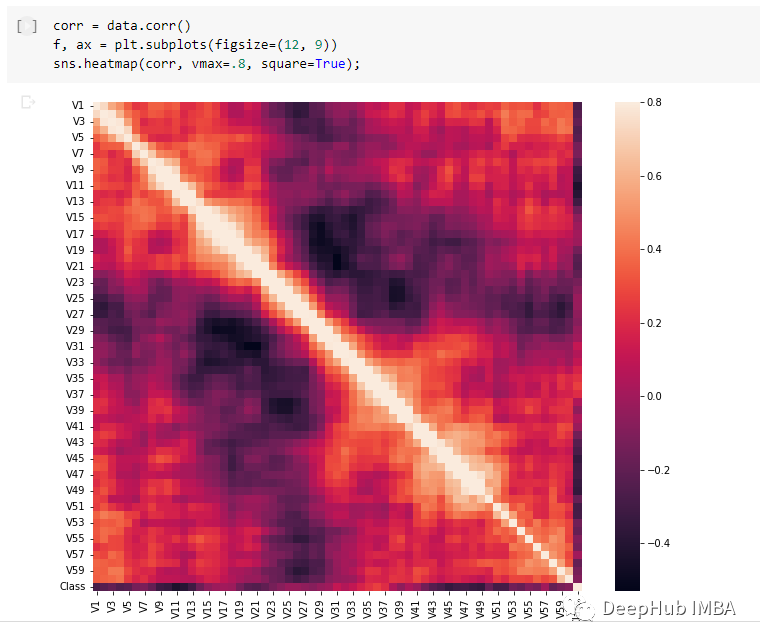
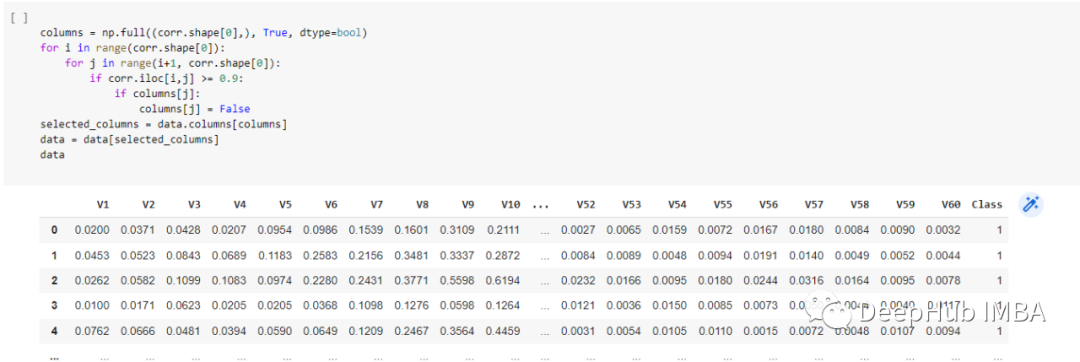
先做一个就简单的预处理,删除具有高度相关性的列,这样将列数从 61 减少到 58:
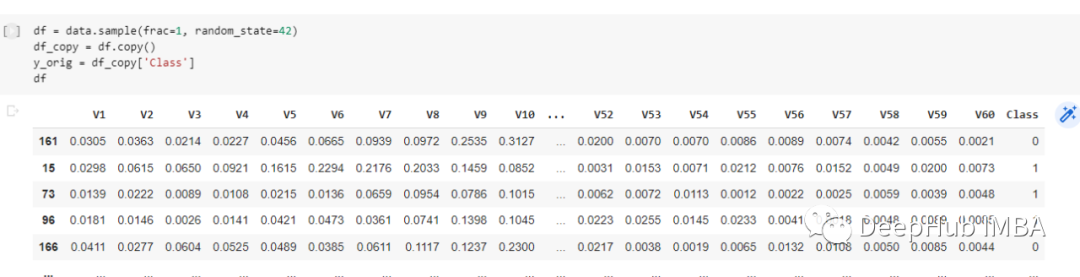
然后对数据进行打乱重排,这样在打乱的数据集中预测通常更准确,复制一个数据集的副本,并将 y_orig 定义为训练目标:
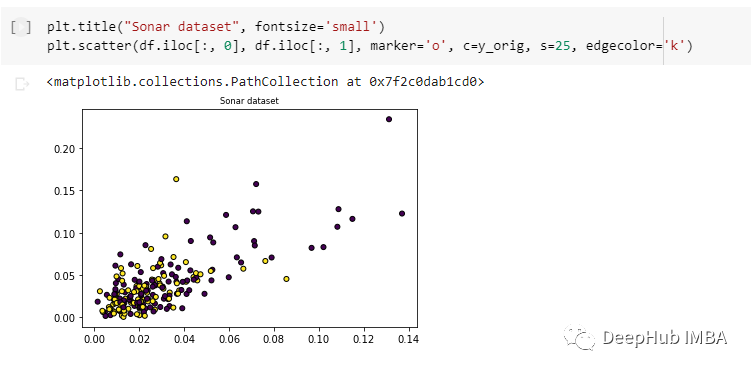
使用matplotlib来绘制数据点的2D散点图:-
使用随机数生成器随机化数据集中60%的标签。然后随机标签被分配-1:-
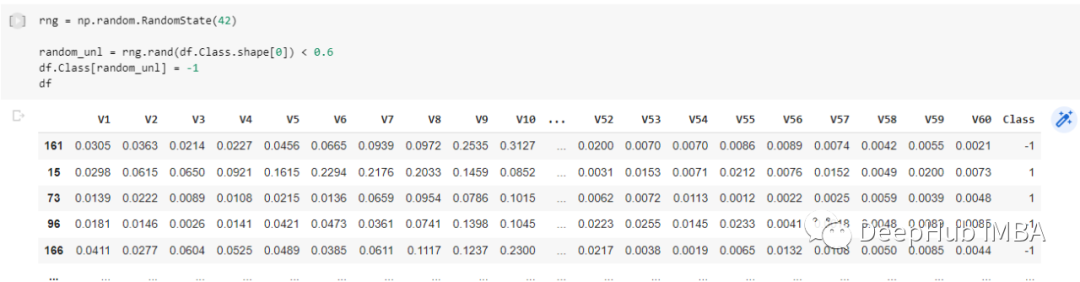
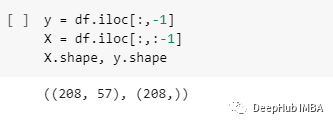
在对数据进行预处理之后,定义因变量和自变量,分别为y和X。y变量是最后一列,X变量是剩下的所有部分:-
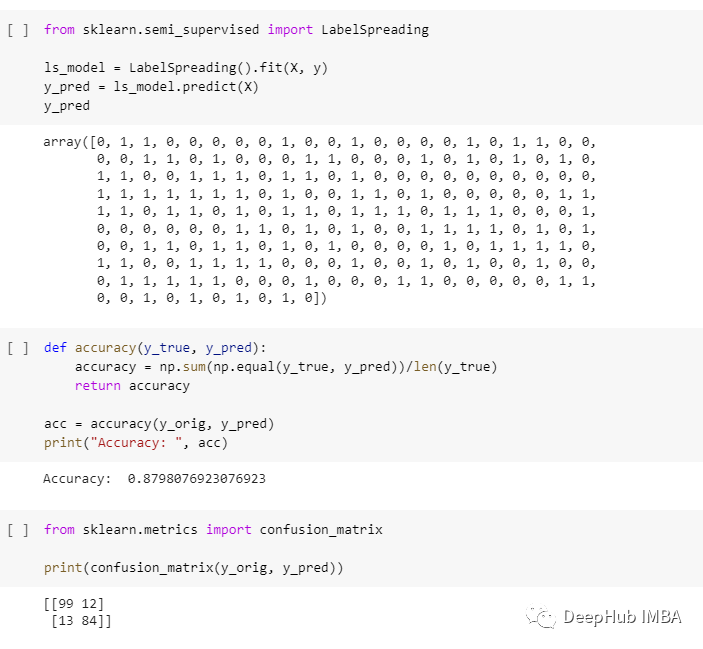
然后使用sklearn的LabelSpreading算法对未标记的行进行训练和预测。
使用这种方法,能够达到87.98%的准确率:-
简单对比
1、labelspreading中含有alpha=0.2,alpha称为夹紧系数,指的是采用其邻居的信息而不是其初始标签的相对量,若为0,表示保留初始标签信息,若为1,表示替换所有初始信息;设置alpha=0.2,意味着始终保留80%的原始标签信息;
2、labelpropagation使用从数据中构造的原始相似矩阵,不做修改;labelspreading最小化具有正则化特性的损失函数,对噪声更加稳健,迭代了原始图的修改版,并通过计算归一化拉普拉斯矩阵来标准化边权重。
3、同时LabelSpreading非常占用CPU,物理内存占用率还好;LabelPropagation 的CPU占用率还好,非常占用物理内存,高纬度数据可能会有一些问题。

机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。
6月29日,中科院计算机网络信息中心等单位发布“异算方舟”国产计算系统软件生态全栈平台。该平台针对算法供给不足、代码迁移困难、智能应用落地慢三大痛点,打造九衍枢算法库、无界BoundX代码转换大模型、Agent-HiReFlow自动化仿真智能体三大能力,提供从底层算法到代码适配再到智能应用的一体化解决方案。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科
熵基科技发布HuggingZKT算法商城,面向空间智能领域打造端云协同AI算法管理平台,覆盖算法训练、发布、订阅、升级等全生命周期,形成开放高效的算法服务体系,推动园区、楼宇等场景的AI能力敏捷调用,助力空间智能规模化应用迈入新阶段。

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
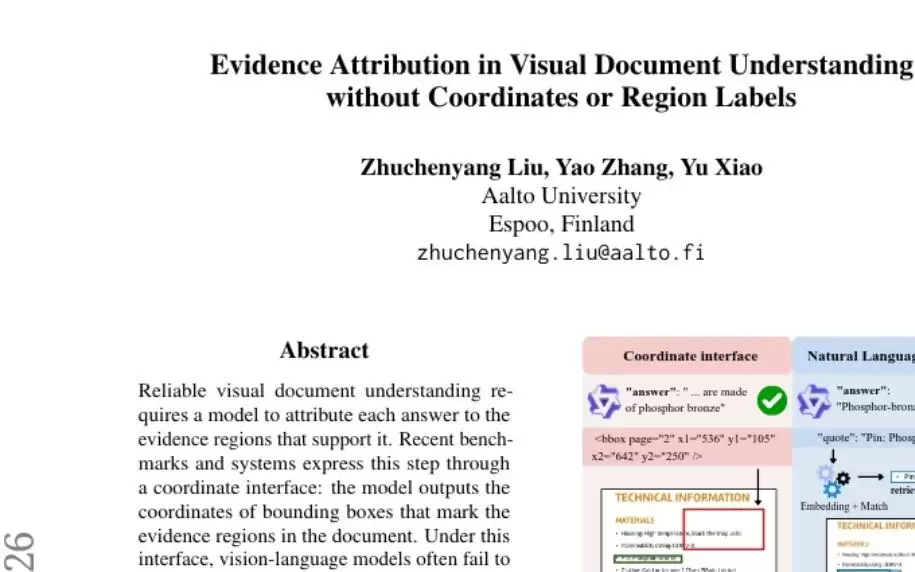
芬兰阿尔托大学提出用语言引用原文代替坐标定位,解决视觉文档理解中的归因幻觉问题。实验显示,该方法使归因幻觉率从97%降至28%,证据召回率从个位数提升至50%以上,且答案质量几乎不变。
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
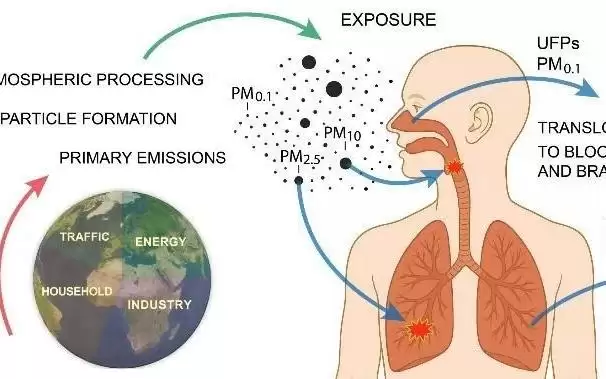
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
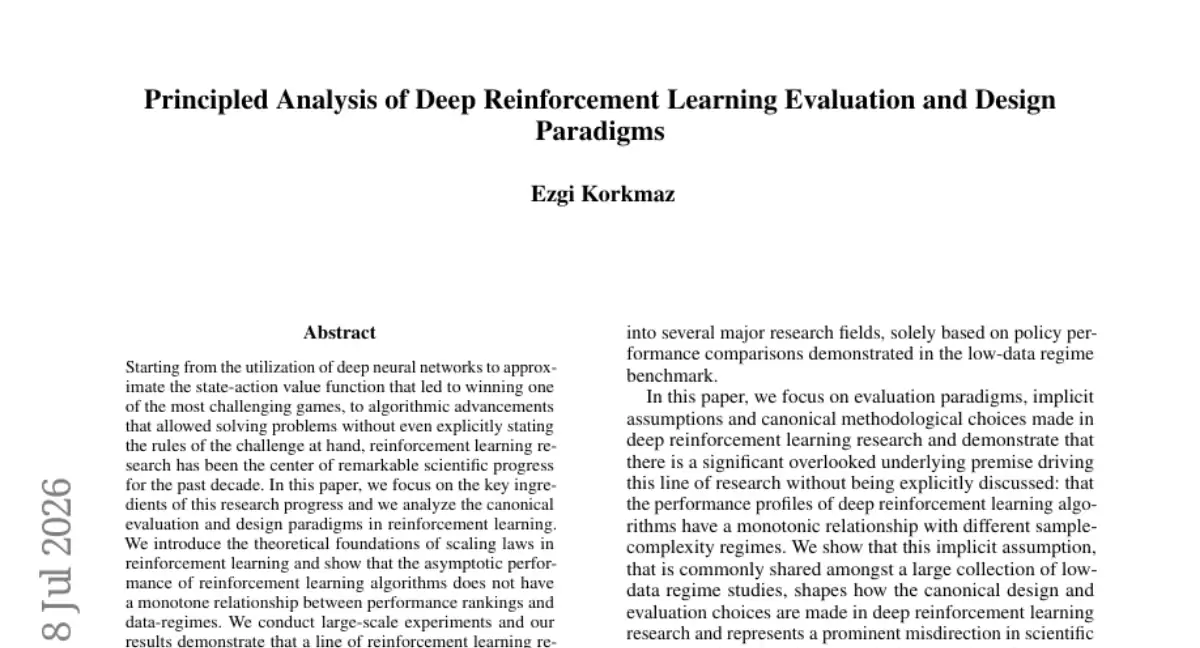
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



