

想学习人工智能,这个的数据集必须掌握,MNIST入门与实战
学习人工智能少不了需要一些数据集,比如进行鉴黄的人工智能少不了一些类似的图片。进行语音识别的人工智能,语料库是少不了的。对于初学人工智能的同学常常为数据集而发愁。今天我们就介绍一个非常简单,但很有用的数据集,这就是MNIST。这个数据集非常适合我们进行人工智能相关算法的学习和练习。MNIST数据集是美国国家标准与技术研究所(NationalInstituteofStandardsandTechnology,简称NIST)制作的一个非常简单的数据集。那么该数据集是什么内容呢?其实就是一些手写的阿
学习人工智能少不了需要一些数据集,比如进行鉴黄的人工智能少不了一些类似的图片。进行语音识别的人工智能,语料库是少不了的。对于初学人工智能的同学常常为数据集而发愁。今天我们就介绍一个非常简单,但很有用的数据集,这就是MNIST。这个数据集非常适合我们进行人工智能相关算法的学习和练习。
MNIST 数据集是美国国家标准与技术研究所(National Institute of Standards and Technology,简称NIST)制作的一个非常简单的数据集。那么该数据集是什么内容呢?其实就是一些手写的阿拉伯数字(0到9十个数字)。

NIST在制作数据集的时候还是很认真的。数据集中的训练集 (training set) 由来自 250 个不同人手写的数字构成,其中 50%是高中学生,50% 来自人口普查局 (the Census Bureau) 的工作人员。测试集(test set) 也是同样比例的手写数字数据。
如何下载MNIST数据集
MNIST数据集可从其官网(http://yann.lecun.com/exdb/mnist/ )下载,由于是国外网站,下载可能比较慢。它包含了四个部分:
- 训练集图片:train-images-idx3-ubyte.gz (9.9 MB, 解压后 47 MB, 包含 60,000 个样本)
- 训练集标签:train-labels-idx1-ubyte.gz (29 KB, 解压后 60 KB, 包含 60,000 个标签)
- 测试集图片:t10k-images-idx3-ubyte.gz (1.6 MB, 解压后 7.8 MB, 包含 10,000 个样本)
- 测试集标签:t10k-labels-idx1-ubyte.gz (5KB, 解压后 10 KB, 包含 10,000 个标签)
上述包含两种类型的内容,一种是图片,另外一种是标签,图片与标签一一对应。但是这里的图片并非是我们平时看到的图片文件,而是一个二进制的文件。该数据集以一个二进制的形式对6万个图片进行了存储。标签则是图片对应的真是数字。
如下图所示,本文将数据集下载到本地,并且解压后的结果。为了便于对比,这里面包含原始的压缩包和解压后的文件。

数据集的格式简析
大家已经发现,压缩包解压后并非一个个的图片,而是每个压缩包对应着一个独立的问题。而在这个文件中存储着上万个图片或者标签的信息。那么这些信息是如何存储在这个文件当中的呢?
其实MNIST的官网给出了详细的描述。以训练集的图片文件为例,官网给出的文件格式描述如下:

从上图可以看出,前4个32位数是该训练集的描述信息。其中第一个是魔数,为固定值0x0803;第二个是图片的数量,0xea60,也就是60000;第三个和第四个是图片的大小,也就是图片是28*28像素。下面则是以一个字节来描述每个像素。由于该文件中以一个字节来描述一个像素,可以知道像素的值可以是从0到255。其中0表示白色,而255表示黑色。

标签文件的格式与图片文件的类似。前面有两个32位数,其中第一个是魔数,固定值0x0801;第二个用于描述标签的数量。接下来的数据是每个标签的值,用一个字节表示。这里表示值的范围是

对应实际训练集的标签文件的数据如下所示。可以看出与上述格式的描述是一致的。另外,我们可以看出,对应该标签集,前面几张图片表示的数字分别应该是5,0,4,1等等。这里大家记一下,后面会用到。

关于数据集的文件格式我们了解了,下面我们实际操作一下。
数据集的可视化处理
知道上述数据的存储格式后,我们就可以对数据进行解析了。比如下面本文实现了一个小程序,用于解析该图片集合中的某个图片,并得到可视化结果。当然,其实我们可以根据标签集合的值知道图片是什么,这里只是一个实验。最终结果是以一个文本文件存储的,用字符“Y”表示笔迹,字符“0”表示背景色。具体程序代码很简单,本文不再赘述。
# -*- coding: UTF-8 -*-
def trans_to_txt(train_file, txt_file, index):

with open(train_file, 'rb') as sf:
with open(txt_file, "w") as wf:
offset = 16 + (28*28*index)
cur_pos = offset
count = 28*28
strlen = 1
out_count = 1
while cur_pos < offset+count:
sf.seek(cur_pos)
data = sf.read(strlen)
res = int(data[0])

#虽然在数据集中像素是1-255表示颜色,这里简化为Y
if res > 0 :
wf.write(" Y ")
else:
wf.write(" 0 ")

#由于图片是28列,因此在此进行换行
if out_count % 28 == 0 :
wf.write("n")

cur_pos += strlen
out_count += 1

trans_to_txt("../data/train-images.idx3-ubyte", "image.txt", 0)
我们运行上述代码,可以得到一个名为image.txt的文件。可以看到该文件的内容如下。其中红色笔记是后面添加了,主要是为看的清楚一些。从图中内容可以看出,这个其实就是手写的“5”。

前面我们通过原生的Python接口对数据集进行了可视化的解析。Python有很多已经实现好的库函数,因此我们可以通过一个库函数简化上述功能。
基于第三方库解析数据
采用原生的Python接口实现起来略显复杂。我们知道Python有很多第三方库,因此我们可以借助第三方库来实现对数据集的解析和展示,具体代码如下。
# -*- coding: utf-8 -*-
import os
import struct
import numpy as np

# 读取数据集,以二维数组的方式返回图片信息和标签信息
def load_mnist(path, kind='train'):
 # 从指定目录加载数据集
labels_path = os.path.join(path,
 '%s-labels.idx1-ubyte'
 % kind)
images_path = os.path.join(path,
 '%s-images.idx3-ubyte'
 % kind)
with open(labels_path, 'rb') as lbpath:
magic, n = struct.unpack('>II',
 lbpath.read(8))
labels = np.fromfile(lbpath,
 dtype=np.uint8)

with open(images_path, 'rb') as imgpath:
#解析图片信息,存储在images中
magic, num, rows, cols = struct.unpack('>IIII',
 imgpath.read(16))
images = np.fromfile(imgpath,
 dtype=np.uint8).reshape(len(labels), 784)

return images, labels

# 在终端打印某个图片的数据信息
def print_image(data, index):
idx = 0;
count = 0;
for item in data[index]:
if count % 28 == 0:
print("")

if item > 0:
print("33[7;31mY 33[0m", end="")
else:
print("0 ", end="")

count += 1

def main():
cur_path = os.getcwd()
cur_path = os.path.join(cur_path, "..data")
imgs, labels = load_mnist(cur_path)
print_image(imgs, 0)


if __name__ == "__main__":
main()
上述代码中分为两步,第一步是将数据集解析到数组中,第二步是对数组中的某个图片进行显示。这里显示也是通过文本的方式程序,只不过不是存储在文件中,而是打印在终端。比如我们依然打印第一个图片,其效果如下:

上述结果的呈现只是通过字符来模拟图片。其实我们可以借助第三方库实现更加完美的图片呈现。接下来我们介绍一下如何通过matplotlib库来呈现图片。这个库非常有用,后续还会接触到这个库。
我们实现一个
def show_image(data, index):
fig, ax = plt.subplots(nrows=1, ncols=1, sharex=True, sharey=True, )

img = data[0].reshape(28, 28)
ax.imshow(img, cmap='Greys', interpolation='nearest')

ax.set_xticks([])
ax.set_yticks([])
plt.tight_layout()
plt.show()
此时可以看到

实现上述功能的时候可能会缺少一些第三方库,比如matplotlib等。此时需要我们手动进行安装,具体方法如下:
pip install matplotlib -i http://pypi.douban.com/simple/ --trusted-host pypi.douban.com
基于TensorFlow的数据解析
MNIST是如此出名,以至于TensorFlow已经对其进行了支持。因此,我们可以通过TensorFlow对其进行加载和解析。下面我们给出用TensorFlow实现的代码。
# -*- coding: utf-8 -*-
from tensorflow.examples.tutorials.mnist import input_data
import pylab

def show_mnist():
# 通过TensorFlow库解析数据
mnist = input_data.read_data_sets("../data", one_hot=True)
im = mnist.train.images[0]
im = im.reshape(28 ,28)
# 进行绘图
pylab.imshow(im, cmap='Greys', interpolation='nearest')
pylab.show()

if __name__ == "__main__":
show_mnist()
该代码实现的最终效果与上一个实例一致,这里不再赘述。
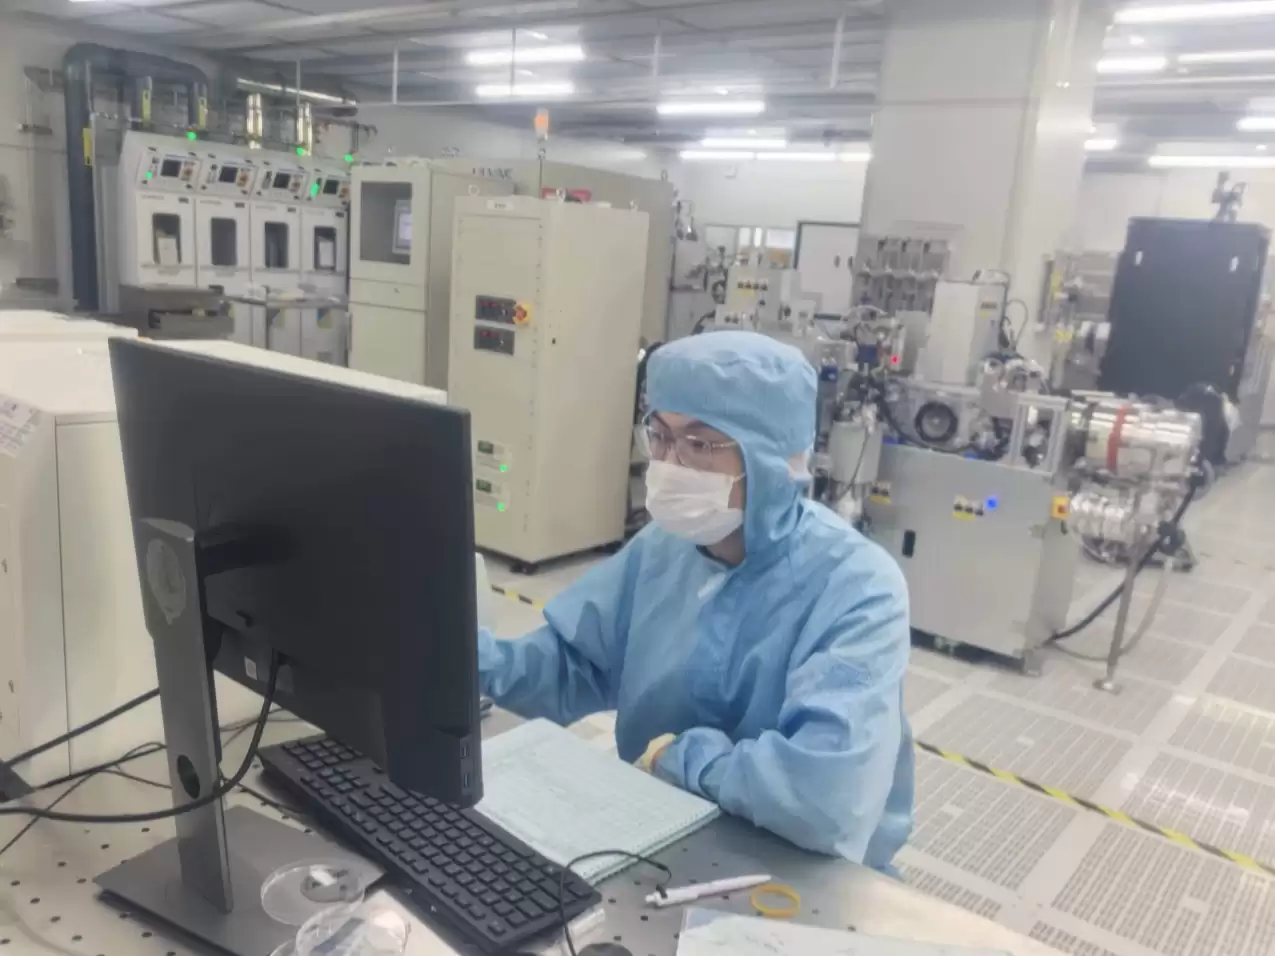
南京邮电大学“光擎智算”团队联合南京大学,攻克GaN基Micro-LED器件技术,成功搭建实验室级光计算验证系统。团队自主研发的5×5 Micro-LED光电计算阵列芯片已进入流片封装阶段,实现了图像识别等算力任务验证,推动光计算技术从理论走向工程落地。
苹果与铠侠签署为期3-5年的NAND闪存长期供应协议,且可能不设价格上限。此举旨在应对AI数据中心需求激增导致的芯片供应紧张,从单纯压价转向确保稳定供货。

一项研究揭示大语言模型在文本嵌入任务中表现平庸的根源:反嵌入矩阵边缘频谱引入高频词偏见。提出的EmbedFilter方法通过滤除该噪声,在MTEB49项任务上显著提升性能,且无需重新训练,兼容多种基线方法。

2026年世界人工智能大会将于7月17日至20日举办,超过300款人工智能新品全球首发,1400多位嘉宾参会,近140场论坛,展览面积超过10万平方米,促成意向合作金额达162亿元,并且推出首个自主举办的国际顶级人工智能学术会议。
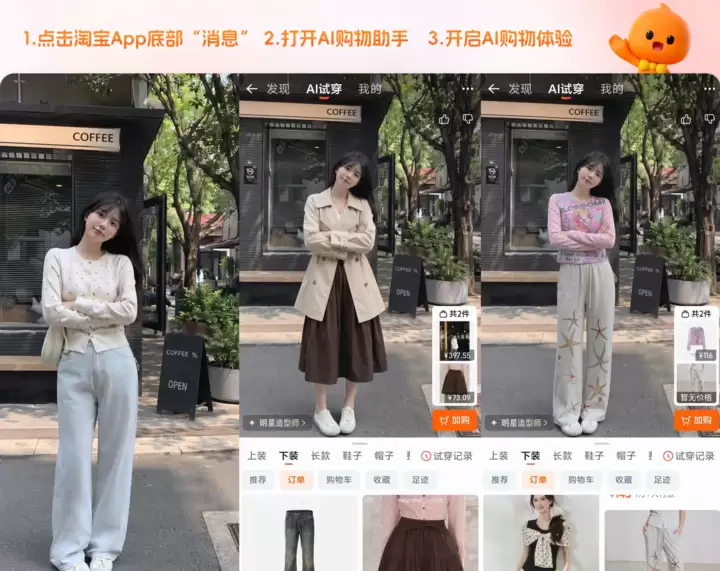
618”期间,AI全面渗透电商,超百万商家使用AI工具提升效率。政策补贴拉动绿色智能家电及汽车消费,市场回暖。供应链升级实现仓配一体化,时效大幅提升,多链协同激活内需活力。
AI生成作品虽完美却缺乏“活人感”,这一悖论贯穿艺术史。《红楼梦》中已批判套路化创作。真正活人感源于创作者内化形式美规律后的即兴发挥与平衡,而非单纯拒绝美化。能否尊重生活细节、容忍碰撞,决定作品是否鲜活,这也是艺术的根本功用。
商务部等8部门发布《关于加快“人工智能+消费”发展的实施意见》,围绕服务消费和商品消费两大领域,明确居家、养老、文旅、教育等场景的AI应用方向,推广智能家居、养老机器人等产品,并适度超前布局城市智能设施。

商汤与香港科技园合作共建国产AI算力中心,目标2030年前实现超40000P算力规模,首阶段预计今年完成。该中心配备国产GPU集群,支撑模型训练与推理,服务本地及国际客户。商汤临港AIDC已有4.04万P算力运营经验。

亚马逊正考虑将其开发的TrainiumAI芯片直接出售给其他公司,以挑战英伟达主导地位。该芯片面向需要本地化数据解决方案的国际企业,亚马逊表示不会影响AWS云业务收入,谷歌也有类似计划。
广东省印发服务业扩能提质方案,聚焦AI机遇,建设国际竞争力的软件与信息技术创新中心,包括培育核心企业、构建AI服务体系、攻关核心技术、建设开源生态,并部署融资租赁、金融合作、算力网络、6G及智能应用。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
