

DetectGPT:使用概率曲率的零样本机器生成文本检测
DetectGPT的目的是确定一段文本是否由特定的llm生成,例如GPT-3。为了对段落x进行分类,DetectGPT首先使用通用的预训练模型(例如T5)对段落~xi生成较小的扰动。然后DetectGPT将原始样本x的对数概率与每个扰动样本~xi进行比较。如果平均对数比高,则样本可能来自源模型。ChatGPT是一个热门话题。人们正在讨论是否可以检测到一篇文章是由大型语言模型(LLM)生成的。DetectGPT定义了一种新的基于曲率的准则,用于判断是否从给定的LLM生成。DetectGPT不需要
DetectGPT的目的是确定一段文本是否由特定的llm生成,例如GPT-3。为了对段落 x 进行分类,DetectGPT 首先使用通用的预训练模型(例如 T5)对段落 ~xi 生成较小的扰动。然后DetectGPT将原始样本x的对数概率与每个扰动样本~xi进行比较。如果平均对数比高,则样本可能来自源模型。
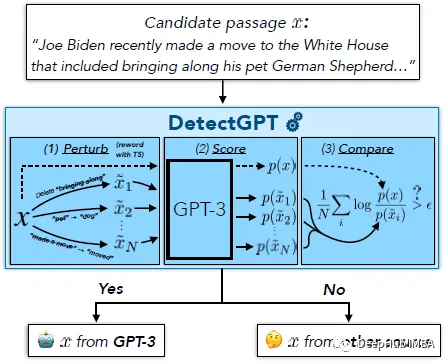
ChatGPT是一个热门话题。人们正在讨论是否可以检测到一篇文章是由大型语言模型(LLM)生成的。DetectGPT定义了一种新的基于曲率的准则,用于判断是否从给定的LLM生成。DetectGPT不需要训练单独的分类器,不需要收集真实或生成的段落的数据集,也不需要显式地为生成的文本加水印。它只使用由感兴趣的模型计算的对数概率和来自另一个通用预训练语言模型(例如T5)的文章随机扰动。
1、DetectGPT:随机排列和假设
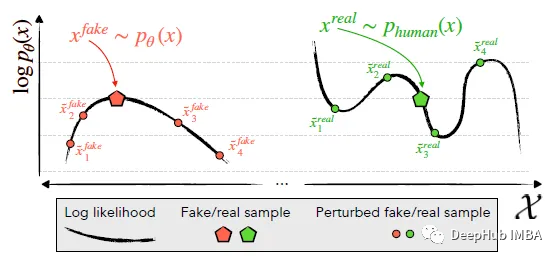
识别并利用了机器生成的通道x~pθ(左)位于logp (x)的负曲率区域的趋势,其中附近的样本平均具有较低的模型对数概率。相比之下,人类书写的文本x~preal(.)(右)倾向于不占据具有明显负对数概率曲率的区域。
DetectGPT基于一个假设,即来自源模型pθ的样本通常位于pθ对数概率函数的负曲率区域,这是人类文本不同的。如果我们对一段文本 x~pθ 应用小的扰动,产生 ~x,与人类编写的文本相比,机器生成的样本的数量 log pθ(x) - log pθ(~x) 应该相对较大。利用这个假设,首先考虑一个扰动函数 q(.|x),它给出了在 ~x 上的分布,x 的略微修改版本具有相似的含义(通常考虑粗略的段落长度文本 x)。例如,q(.|x) 可能是简单地要求人类重写 x 的其中一个句子的结果,同时保留 x 的含义。使用扰动函数的概念,可以定义扰动差异 d (x; pθ, q):
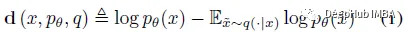
因此,下面的假设 4.1也就是:
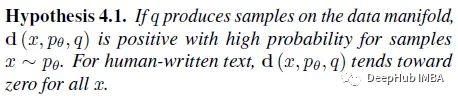
如果q(.|x)是来自掩码填充模型(如T5)的样本而不是人类重写,那么假设4.1可以以自动的、可扩展的方式进行经验检验。
2、DetectGPT:自动测试
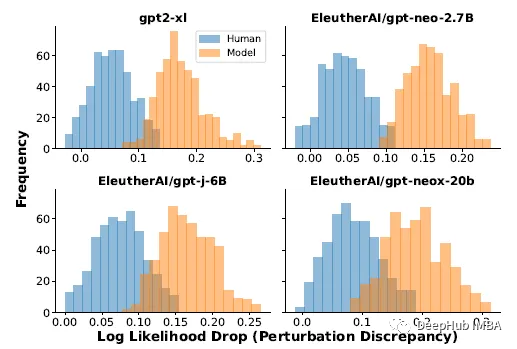
对一篇文章进行改写后,模型生成的文章的对数概率(扰动差异)的平均下降始终高于人工书写的文章
对于真实数据,使用了XSum数据集中的500篇新闻文章。当提示XSum中每篇文章的前30个令牌时,使用四个不同llm的输出。使用T5-3B施加扰动,遮蔽随机采样的2个单词跨度,直到文章中15%的单词被掩盖。上面公式(1)中的期望近似于T5中的100个样本。
上述实验结果表明,人写文章和模型样本的摄动差异分布有显著差异;模型样本往往有较大的扰动差异。根据这些结果,就可以通过简单地阈值扰动差异来检测一段文本是否由模型p生成。
通过用于估计 E~x q(.|x) log p (~x) 的观测值的标准偏差对扰动差异进行归一化提供了更好的检测,通常将 AUROC 增加 0.020 左右, 所以在实验中使用了扰动差异的归一化版本。
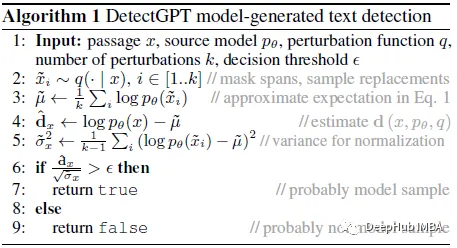
DetectGPT 的检测过程伪代码
扰动差异可能是有用的,它测量的是什么还无法明确解释,所以作者在下一节中使用曲率进行解释。
3、将微扰差异解释为曲率
扰动差异近似于候选段落附近对数概率函数局部曲率的度量,更具体地说,它与对数概率函数的 Hessian 矩阵的负迹成正比。
这一节内容比较多,这里就不详细解释了,有兴趣的可以看看原论文,大概总结如下:
语义空间中的采样确保所有样本都保持在数据流形附近,因为如果随机添加扰动标记,预计对数概率总是下降。所以可以将目标解释为近似限制在数据流形上的曲率。
4、结果展示
零样本机器生成文本检测
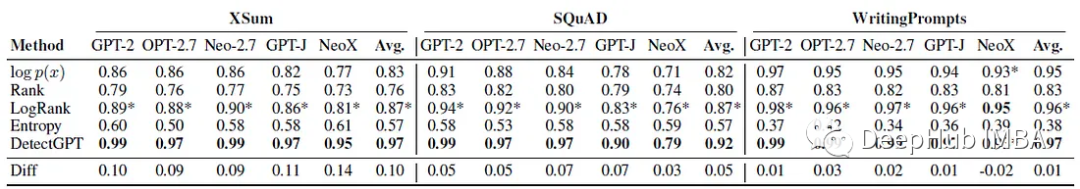
每个实验使用150到500个例子进行评估。机器生成的文本是通过提示真实文本的前30个标记来生成的。使用AUROC)评估性能。
可以看到DetectGPT最大程度地提高了XSum故事的平均检测精度(AUROC提高0.1 )和SQuAD维基百科上下文(AUROC提高0.05 )。
对于15种数据集和模型组合中的14种,DetectGPT提供了最准确的检测性能,AUROC平均提高了0.06。
与有监督检测器的比较
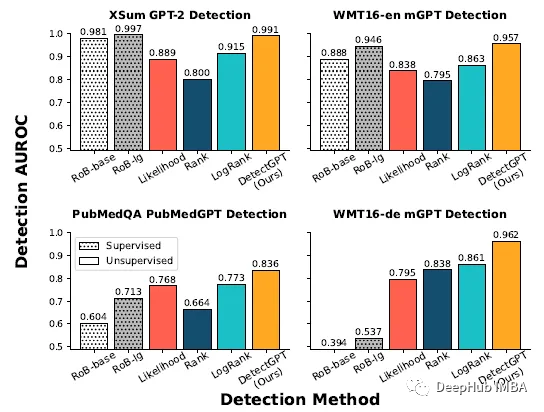
在真实文本和生成文本的大型数据集上训练的有监督的机器生成文本检测模型在分布内(顶部行)文本上的表现与DetectGPT一样好,甚至更好。零样本方法适用于新域(底部一行),如PubMed医学文本和WMT16中的德语新闻数据。
来自每个数据集的200个样本进行评估,监督检测器对英语新闻等分布内数据的检测性能与DetectGPT相似,但在英语科学写作的情况下,其表现明显差于零样本方法,而在德语写作中则完全失败。
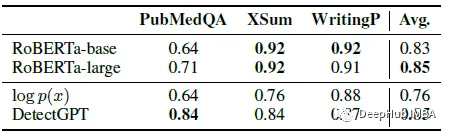
DetectGPT检测GPT-3的平均AUROC与专门为机器生成文本检测训练的监督模型相当。
从PubMedQA、XSum和writingprompt数据集中抽取了150个示例。将两种预训练的基于roberta的检测器模型与DetectGPT和概率阈值基线进行了比较。DetectGPT 可以提供与更强大的监督模型竞争的检测。
机器生成文本检测的变体
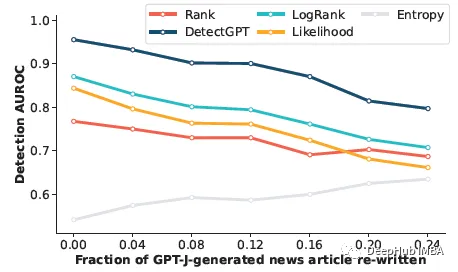
这部分是看检测器是否可以检测到人工编辑的机器生成文本。通过用 T5–3B 中的样本替换文本的 5 个单词跨度来模拟人工修订,直到 r% 的文本被替换。即使模型样本中近四分之一的文本已被替换,DetectGPT 仍能将检测 AUROC 保持在 0.8 以上。DetectGPT 显示了所有修订级别的最强检测性能。
译者|李睿审校|重楼尽管像GPT-4这样的大型语言模型(LLM)在软件编写方面表现出色,但是其高昂的成本和不透明性已经引发了人们对更经济实惠、规模更小的编码LLM的关注。针对特定任务进行微调的替代方案可以有效降低成本。LLM的开发面临的主要挑战之一是在训练数据集的规模和模型性能之间取得最佳平衡。为了应对这一挑战,微软公司最近发表的一篇论文介绍了一项新技术,该技术能够通过使用更少的示例训练高效的编码语言模型。该论文详细介绍了WaveCoder模型,并声称该模型在类似数量的示例上训练时要优于其他编码LLM模型
AI视频模型Sora爆火之后,Meta、谷歌等大厂纷纷下场做研究,追赶OpenAI的步伐。最近,来自谷歌团队的研究人员提出了一种通用视频编码器——VideoPrism。它能够通过单一冻结模型,处理各种视频理解任务。图片论文地址:https://arxiv.org/pdf/2402.13217.pdf比如,VideoPrism能够将下面视频中吹蜡烛的人分类、定位出来。图片视频-文本检索,根据文本内容,可以检索出视频中相应的内容。图片再比如,描述下面视频——一个小女孩正在玩积木。还可以进行QA问答。-她放在绿

随着大数据时代的到来,数据分析和机器学习已经成为了热门领域。然而,对于初学者来说,如何获取数据集并进行分析和训练模型可能会是一个困难的任务。为了解决这个问题,开源社区已经提供了丰富的数据集,并且Python作为一种流行的编程语言,也提供了各种方法来使用这些数据集。本文介绍在Python中使用开源数据集的方法和工具,例如数据加载、浏览、清洗、可视化和分析。我们
实战演练:利用Matplotlib绘制数据集的散点图Matplotlib是Python中常用的绘图库之一,它提供了丰富的功能,可以绘制各种类型的图表。其中,散点图是一种常用的数据可视化方式,用于展示两个变量之间的关系。本文将介绍如何利用Matplotlib绘制数据集的散点图,并附上具体的代码示例。首先,我们需要安装Matplotlib库。可以使用pip命令执
11月10日消息,OpenAI发文宣布,将与组织合作生成用于训练AI模型的公共/私有数据集,数据合作伙伴关系旨在“让更多组织能够帮助引导AI的未来”并“从更有用的模型中受益”。IT之家从博客获悉,OpenAI称:“为了最终使AI变得更加安全且造福于全人类,我们希望AI模型能够深入理解所有主题、行业、文化和语言,这需要尽可能广泛的训练数据集。”作为数据合作伙伴计划的一部分,OpenAI表示,它将收集“反映人类社会”且目前不易在线访问的“大规模”数据集。虽然该公司计划跨多种模式开展工作,包括图像、音频和视频,
论文链接:https://arxiv.org/pdf/2309.06547.pdf数据集链接:http://amodalsynthdrive.cs.uni-freiburg.de摘要本文介绍了AmodalSynthDrive:一个用于自动驾驶的合成非模态感知数据集。与人类不同,即使在部分遮挡的情况下,人类也可以毫不费力地估计物体的整体,而现代计算机视觉算法仍然发现这一方面极具挑战性。由于缺乏合适的数据集,利用这种非模态感知进行自动驾驶在很大程度上仍未得到开发。这些数据集的生成主要受到昂贵标注成本的影响,以
数据集采样策略对模型性能的影响问题,需要具体代码示例随着机器学习和深度学习的快速发展,数据集的质量和规模对于模型性能的影响变得越来越重要。在实际应用中,我们往往面临着数据集规模过大、样本类别不平衡、样本噪声等问题。这时,采样策略的合理选择能够提高模型的性能和泛化能力。本文将通过具体的代码示例,讨论不同数据集采样策略对模型性能的影响。随机采样随机采样是最常见的
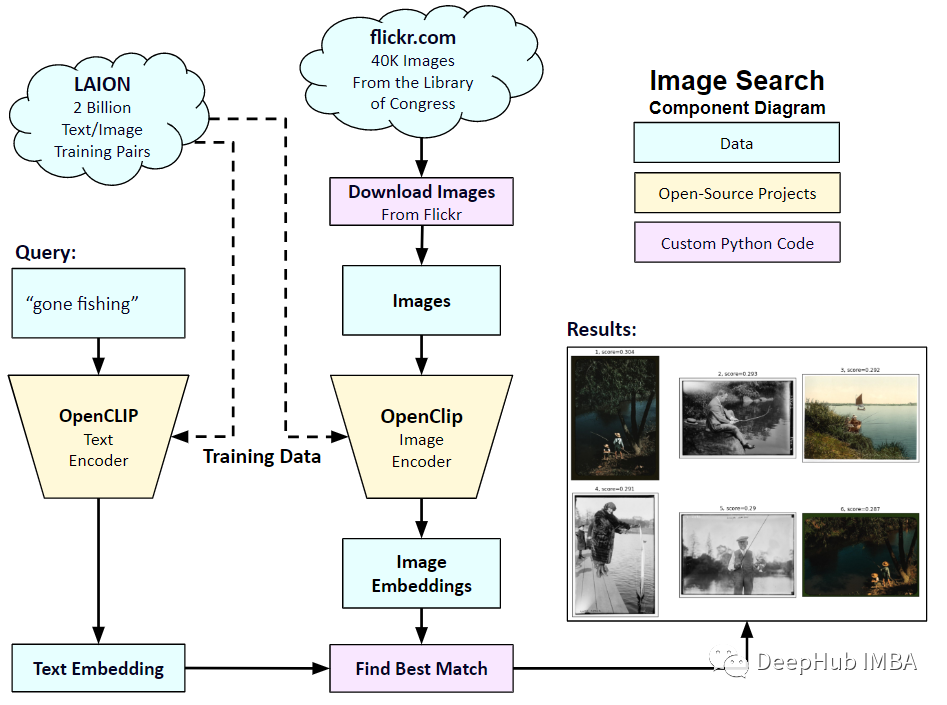
在2021年1月,OpenAI宣布了两个新模型:DALL-E和CLIP。这两个模型都是多模态模型,以某种方式连接文本和图像。CLIP的全称是对比语言-图像预训练(ContrastiveLanguage-ImagePre-training),它是一种基于对比文本-图像对的预训练方法。为什么要介绍CLIP呢?因为目前火热的StableDiffusion并不是单一模型,而是由多个模型组成。其中一个关键组成部分是文本编码器,用于对用户的文本输入进行编码,而这个文本编码器就是CLIP模型中的文本编码器CLIP模型在
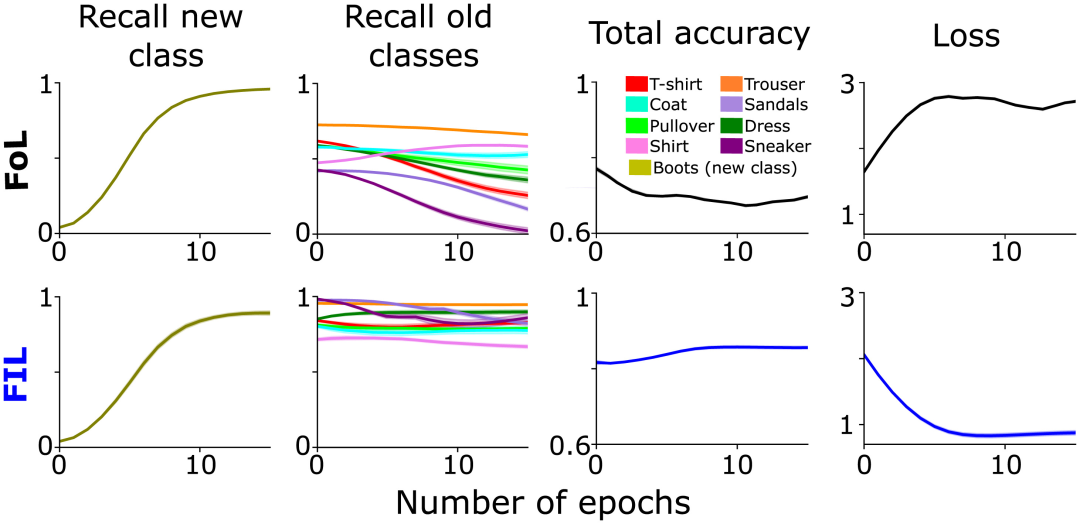
与人类不同,人工神经网络在学习新事物时会迅速遗忘先前学到的信息,必须通过新旧信息的交错来重新训练;但是,交错全部旧信息非常耗时,并且可能没有必要。只交错与新信息有实质相似性的旧信息可能就足够了。近日,美国科学院院报(PNAS)刊登了一篇论文,“Learningindeepneuralnetworksandbrainswithsimilarity-weightedinterleavedlearning”,由加拿大皇家学会会士、知名神经科学家BruceMcNaughton的团队发表
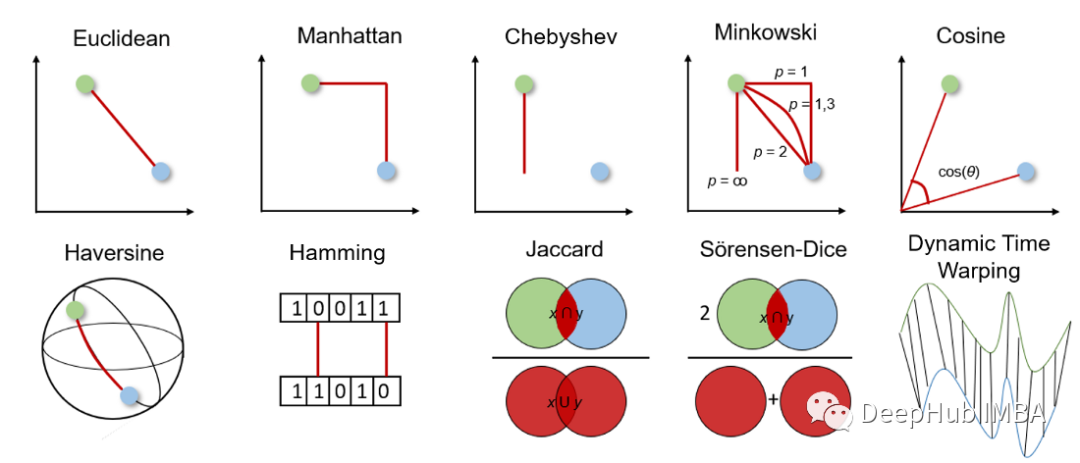
距离度量是有监督和无监督学习算法的基础,包括k近邻、支持向量机和k均值聚类等。距离度量的选择影响我们的机器学习结果,因此考虑哪种度量最适合这个问题是很重要的。因此,我们在决定使用哪种测量方法时应该谨慎。但在做出决定之前,我们需要了解距离测量是如何工作的,以及我们可以从哪些测量中进行选择。本文将简要介绍常用的距离度量方法、它们的工作原理、如何用Python计算它们以及何时使用它们。这样可以加深知识和理解,提高机器学习算法和结果。在更深入地研究不同的距离测量之前,我们先要有一个关于它们如何工作以及如何选择合适





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



