

十个机器学习中常用的距离度量方法
距离度量是有监督和无监督学习算法的基础,包括k近邻、支持向量机和k均值聚类等。距离度量的选择影响我们的机器学习结果,因此考虑哪种度量最适合这个问题是很重要的。因此,我们在决定使用哪种测量方法时应该谨慎。但在做出决定之前,我们需要了解距离测量是如何工作的,以及我们可以从哪些测量中进行选择。本文将简要介绍常用的距离度量方法、它们的工作原理、如何用Python计算它们以及何时使用它们。这样可以加深知识和理解,提高机器学习算法和结果。在更深入地研究不同的距离测量之前,我们先要有一个关于它们如何工作以及如何选择合适
距离度量是有监督和无监督学习算法的基础,包括k近邻、支持向量机和k均值聚类等。
距离度量的选择影响我们的机器学习结果,因此考虑哪种度量最适合这个问题是很重要的。因此,我们在决定使用哪种测量方法时应该谨慎。但在做出决定之前,我们需要了解距离测量是如何工作的,以及我们可以从哪些测量中进行选择。
本文将简要介绍常用的距离度量方法、它们的工作原理、如何用Python计算它们以及何时使用它们。这样可以加深知识和理解,提高机器学习算法和结果。
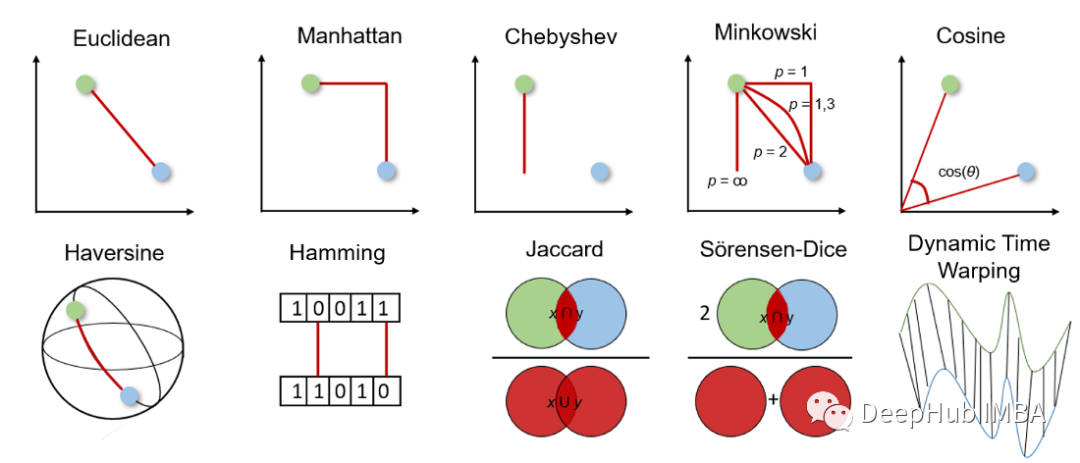
在更深入地研究不同的距离测量之前,我们先要有一个关于它们如何工作以及如何选择合适的测量的大致概念。
距离度量用于计算给定问题空间中两个对象之间的差异,即数据集中的特征。然后可以使用该距离来确定特征之间的相似性, 距离越小特征越相似。
对于距离的度量,我们可以在几何距离测量和统计距离测量之间进行选择,应该选择哪种距离度量取决于数据的类型。特征可能有不同的数据类型(例如,真实值、布尔值、分类值),数据可能是多维的或由地理空间数据组成。
几何距离测量
1、欧氏距离 Euclidean distance
欧氏距离度量两个实值向量之间的最短距离。由于其直观,使用简单和对许多用例有良好结果,所以它是最常用的距离度量和许多应用程序的默认距离度量。
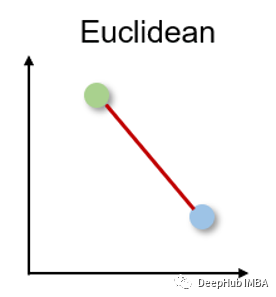
欧氏距离也可称为l2范数,其计算方法为:
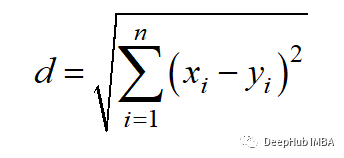
Python代码如下
from scipy.spatial import distance
 distance.euclidean(vector_1, vector_2)
欧氏距离有两个主要缺点。首先,距离测量不适用于比2D或3D空间更高维度的数据。第二,如果我们不将特征规范化和/或标准化,距离可能会因为单位的不同而倾斜。
2、曼哈顿距离 Manhattan distance
曼哈顿距离也被称为出租车或城市街区距离,因为两个实值向量之间的距离是根据一个人只能以直角移动计算的。这种距离度量通常用于离散和二元属性,这样可以获得真实的路径。
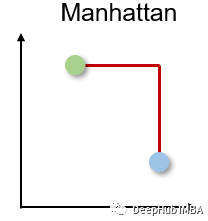
曼哈顿距离以l1范数为基础,计算公式为:
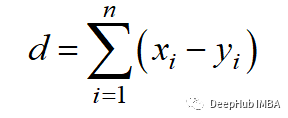
Python代码如下
from scipy.spatial import distance
 distance.cityblock(vector_1, vector_2)
曼哈顿的距离有两个主要的缺点。它不如高维空间中的欧氏距离直观,它也没有显示可能的最短路径。虽然这可能没有问题,但我们应该意识到这并不是最短的距离。
3、切比雪夫距离 Chebyshev distance
切比雪夫距离也称为棋盘距离,因为它是两个实值向量之间任意维度上的最大距离。它通常用于仓库物流中,其中最长的路径决定了从一个点到另一个点所需的时间。
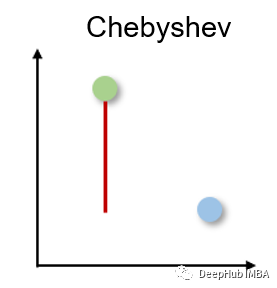
切比雪夫距离由l -无穷范数计算:
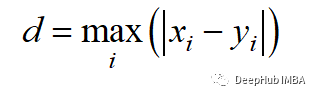
Python代码如下
from scipy.spatial import distance
 distance.chebyshev(vector_1, vector_2)
切比雪夫距离只有非常特定的用例,因此很少使用。
4、闵可夫斯基距离 Minkowski distance
闵可夫斯基距离是上述距离度量的广义形式。它可以用于相同的用例,同时提供高灵活性。我们可以选择 p 值来找到最合适的距离度量。
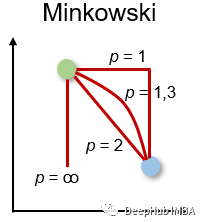
闵可夫斯基距离的计算方法为:
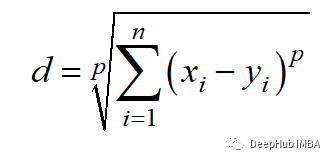
Python代码如下
from scipy.spatial import distance
 distance.minkowski(vector_1, vector_2, p)
由于闵可夫斯基距离表示不同的距离度量,它就有与它们相同的主要缺点,例如在高维空间的问题和对特征单位的依赖。此外,p值的灵活性也可能是一个缺点,因为它可能降低计算效率,因为找到正确的p值需要进行多次计算。
5、余弦相似度和距离 Cosine similarity
余弦相似度是方向的度量,他的大小由两个向量之间的余弦决定,并且忽略了向量的大小。余弦相似度通常用于与数据大小无关紧要的高维,例如,推荐系统或文本分析。
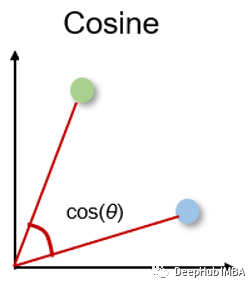
余弦相似度可以介于-1(相反方向)和1(相同方向)之间,计算方法为:
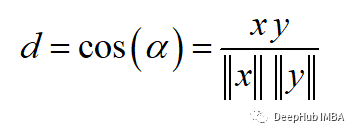
余弦相似度常用于范围在0到1之间的正空间中。余弦距离就是用1减去余弦相似度,位于0(相似值)和1(不同值)之间。
Python代码如下
from scipy.spatial import distance
 distance.cosine(vector_1, vector_2)
余弦距离的主要缺点是它不考虑大小而只考虑向量的方向。因此,没有充分考虑到值的差异。
6、半正矢距离 Haversine distance
半正矢距离测量的是球面上两点之间的最短距离。因此常用于导航,其中经度和纬度和曲率对计算都有影响。
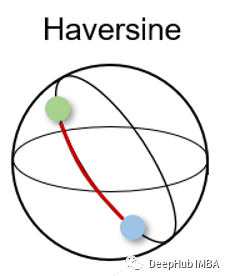
半正矢距离的公式如下:
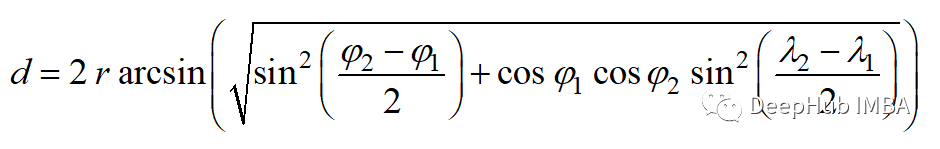
其中r为球面半径,φ和λ为经度和纬度。
Python代码如下
from sklearn.metrics.pairwise import haversine_distances
 haversine_distances([vector_1, vector_2])
半正矢距离的主要缺点是假设是一个球体,而这种情况很少出现。
7、汉明距离
汉明距离衡量两个二进制向量或字符串之间的差异。
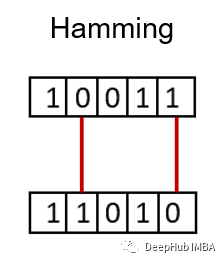
对向量按元素进行比较,并对差异的数量进行平均。如果两个向量相同,得到的距离是0之间,如果两个向量完全不同,得到的距离是1。
Python代码如下
from scipy.spatial import distance
 distance.hamming(vector_1, vector_2)
汉明距离有两个主要缺点。距离测量只能比较相同长度的向量,它不能给出差异的大小。所以当差异的大小很重要时,不建议使用汉明距离。
统计距离测量
统计距离测量可用于假设检验、拟合优度检验、分类任务或异常值检测。
8、杰卡德指数和距离 Jaccard Index
Jaccard指数用于确定两个样本集之间的相似性。它反映了与整个数据集相比存在多少一对一匹配。Jaccard指数通常用于二进制数据比如图像识别的深度学习模型的预测与标记数据进行比较,或者根据单词的重叠来比较文档中的文本模式。
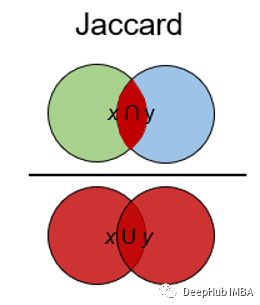
Jaccard距离的计算方法为:
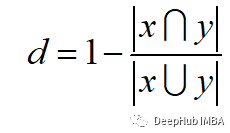
Python代码如下
from scipy.spatial import distance
 distance.jaccard(vector_1, vector_2)
Jaccard指数和距离的主要缺点是,它受到数据规模的强烈影响,即每个项目的权重与数据集的规模成反比。
9、Sorensen-Dice指数
Sörensen-Dice指数类似于Jaccard指数,它可以衡量的是样本集的相似性和多样性。该指数更直观,因为它计算重叠的百分比。Sörensen-Dice索引常用于图像分割和文本相似度分析。
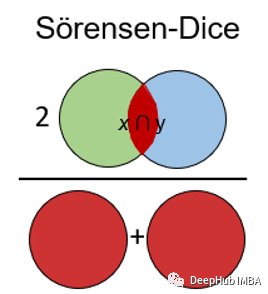
计算公式如下:
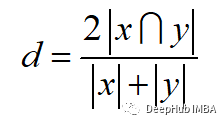
Python代码如下
from scipy.spatial import distance
 distance.dice(vector_1, vector_2)
它的主要缺点也是受数据集大小的影响很大。
10、动态时间规整 Dynamic Time Warping
动态时间规整是测量两个不同长度时间序列之间距离的一种重要方法。可以用于所有时间序列数据的用例,如语音识别或异常检测。
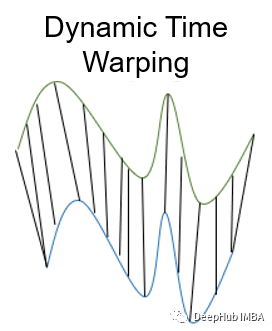
为什么我们需要一个为时间序列进行距离测量的度量呢?如果时间序列长度不同或失真,则上述面说到的其他距离测量无法确定良好的相似性。比如欧几里得距离计算每个时间步长的两个时间序列之间的距离。但是如果两个时间序列的形状相同但在时间上发生了偏移,那么尽管时间序列非常相似,但欧几里得距离会表现出很大的差异。
动态时间规整通过使用多对一或一对多映射来最小化两个时间序列之间的总距离来避免这个问题。当搜索最佳对齐时,这会产生更直观的相似性度量。通过动态规划找到一条弯曲的路径最小化距离,该路径必须满足以下条件:
- 边界条件:弯曲路径在两个时间序列的起始点和结束点开始和结束
- 单调性条件:保持点的时间顺序,避免时间倒流
- 连续条件:路径转换限制在相邻的时间点上,避免时间跳跃
- 整经窗口条件(可选):允许的点落入给定宽度的整经窗口
- 坡度条件(可选):限制弯曲路径坡度,避免极端运动
我们可以使用 Python 中的 fastdtw 包:
from scipy.spatial.distance import euclidean
 from fastdtw import fastdtw

 distance, path = fastdtw(timeseries_1, timeseries_2, dist=euclidean)
动态时间规整的一个主要缺点是与其他距离测量方法相比,它的计算工作量相对较高。
总结
在这篇文章中,简要介绍了十种常用的距离测量方法。本文中已经展示了它们是如何工作的,如何在Python中实现它们,以及经常使用它们解决什么问题。如果你认为我错过了一个重要的距离测量,请留言告诉我。

机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
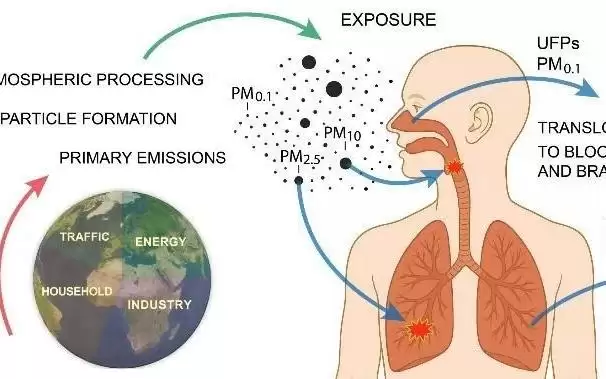
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化
机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。
少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



