

ChiQA-一个基于20万个真实用户问题的图片问答数据集
近年来,随着问答技术和多模态理解技术的蓬勃发展,视觉问答任务(VisualQuestionAnswering)变得越来越受关注。诸如VQA、CLEVER、Visual-7W等大规模视觉问答数据集陆续发布,极大地推动了视觉问答任务的迭代发展。然而,当前大部分视觉问答数据都是人工合成问题,如“她的眼睛是什么颜色”这种标注者在看到图片后虚构设计出的。人工产生的数据会相对简单、低质甚至有偏。因此,在这项工作中,我们基于QQ浏览器中用户真实的问题,提出了一个基于中文的大规模图片问答数据集:ChiQ
近年来,随着问答技术和多模态理解技术的蓬勃发展,视觉问答任务(Visual Question Answering)变得越来越受关注。诸如 VQA、CLEVER、Visual-7W 等大规模视觉问答数据集陆续发布,极大地推动了视觉问答任务的迭代发展。然而,当前大部分视觉问答数据都是人工合成问题,如 “她的眼睛是什么颜色” 这种标注者在看到图片后虚构设计出的。人工产生的数据会相对简单、低质甚至有偏。因此,在这项工作中,我们基于 QQ 浏览器中用户真实的问题,提出了一个基于中文的大规模图片问答数据集:ChiQA。
ChiQA 包含有超过 4 万个真实用户 query 和超过 20 万个问题 - 图像对。数据和一些 baseline 模型已经公布在GitHub。相关研究已经被 CIKM2022 长文录用。
论文地址:https://arxiv.org/abs/2208.03030
Github地址:https://github.com/benywon/ChiQA
对比单模态问答任务
ChiQA的三个显著特性
问答系统(Question Answering) 是人工智能和智能语言处理中非常重要的任务之一。近年来,随着大规模数据集(如 SQuAD、NaturalQuestions)的发布以及大规模预训练语言模型(如 BERT、GPT)的提出,问答任务得到了飞速的发展。然而,当前大部分问答任务都是单模态的,即问题、资源以及答案都是基于文本的。然而,从认知智能以及实际应用的角度来说,多模态资源如图像在很多时候往往能提供更为丰富的信息和答案。例如,对于一个问题:iPhone13 的尺寸是多少?一个针对 iPhone13 不同型号的尺寸对比图会更加清楚和直观。还有一些例子如下图所示:
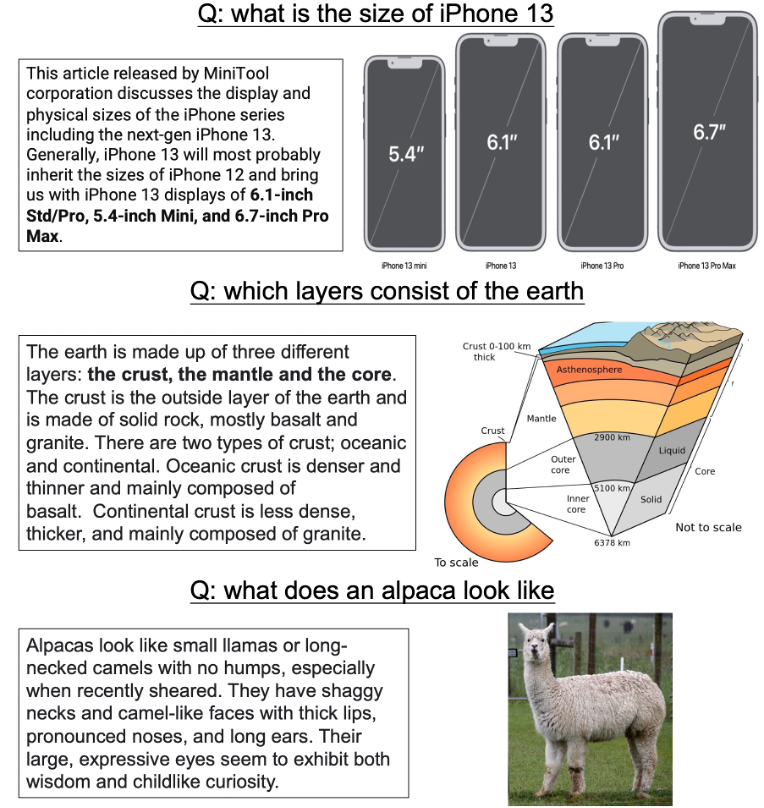
图一:一些适合用图片回答用户问题的例子
最近几年,针对多模态理解的问答数据和任务被相继提出。如 VQA1.0 和 2.0、CLEVR、GQA 等等。在大部分图像问答数据集中,系统提供一些人工生成或者真实的图像给标注者,标注者需要人工写出一些针对特定属性或者实体的问题。然而,这种数据收集过程不可避免的有很多缺陷:
1)所有的问题都是图像相关的(image-dependent),即标注者看到图片之后提出问题。在大规模数据构建过程中,人工生成的问题往往会缺乏多样性,而且往往由于标注者的主观因素会产生偏置。在这种先看资源,再提问的数据上训练的模型往往可以不用看背景资源只看问题而轻易达到非常好的效果;
2)其次,在传统的 VQA 数据中,答案往往是一个简单的实体、关系或者简单对特定区域的描述。然而对于实际的图像问答任务中,很多文本性答案是不必要的,例如对于问题:“羊驼长什么样”,提供一个冗长的答案描述羊驼的外表显得非常冗余。其次,这种简短的实体描述往往会让标注者只关注到局部关系,而很少注意真正整体结构上的一些信息;
3)最后,大部分之前的资源往往是专注于英文,在中文领域的图像问答数据很少。
在这个工作中,针对以上几个问题,我们提出了一个大规模的中文图像问答数据集 - ChiQA(Chinese Image Question Answering)。我们通过手机 QQ 浏览器中用户真实的搜索词出发,通过特定 API 检索到相关的若干张图片,然后将图片交由经过专业培训的标注人员进行三级标注,以表示该图片是否能完美回答(2 分)、部分回答(1 分)以及不能回答(0 分)用户的问题。对于 ChiQA 来说,有三个显著的特点:
- 真实问题,真实图片:ChiQA 中的图片来源于随机用户的查询。这些查询是开放域中随机的用户 query,这些 query 非常多样,而且 query 的领域分布非常广泛。这样随机的多样性 query 保证了我们的数据中的问题不会有偏;
- 可回答性:对于问答任务来说,可回答性是一个非常重要的方面。在 ChiQA 中我们不要求标注人员给出最终的答案:因为这样往往会引入一些额外的偏置,比如标注人员的常识。相反的,我们着重于可回答性,即图片对于问题是否可以回答。这种可回答性可以让 ChiQA 的标注人员既需要理解 query,也需要理解图片;
- 无偏的:因为随机 query 中也会存在 28 定律,即一些高频或者单一的问题往往会出现很多次,数据中这种简单模式的问题会占据大多数,造成数据中真正跨模态理解的偏置。因此,我们在数据收集过程中引入了两阶段的主动学习过程,在第一阶段随机 query 标注完成后,我们训练了一个简单的模型,然后用这个模型挑选出 "更难" 的一些模型,从而让二阶段的标注数据中数据的丰富度和难度相对更高。
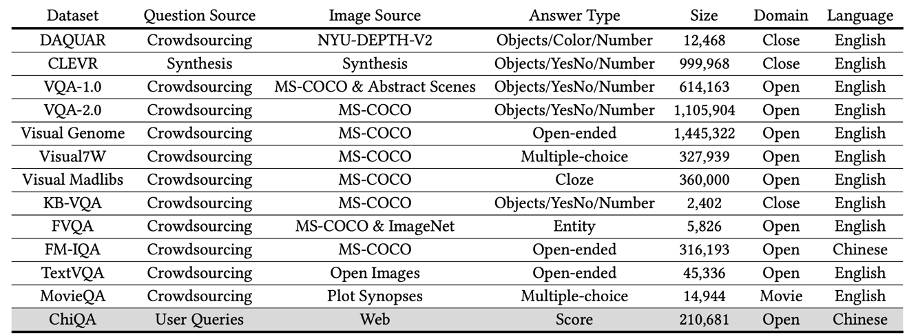
图二:ChiQA 和业界其他一些图像问答数据的对比
最终我们收集了超过 40000 个问题,每个问题都有大约 5 个相关的图片,即总量超过 20 万的问题 - 图片对。每个问题都有若干张图片,我们对每个图片以2-1-0进行三挡打分。
一些 ChiQA 中的例子如下图所示:
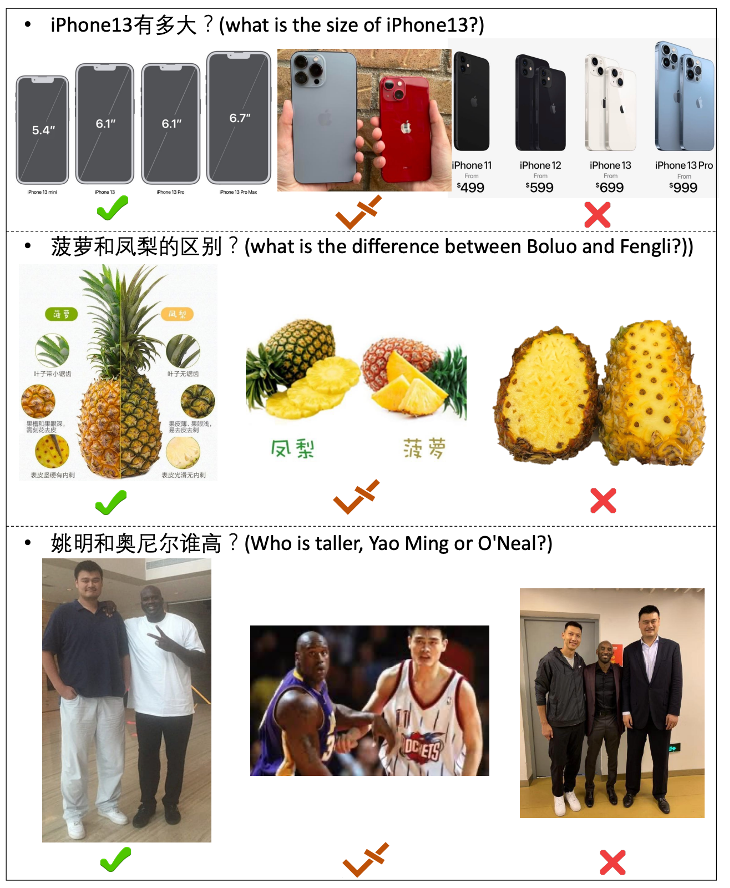
图三:ChiQA 中一些样本的示例。
数据收集:所有问题均来源于用户真实查询
整个数据的收集过程可以分为四步,整体流程图如下:
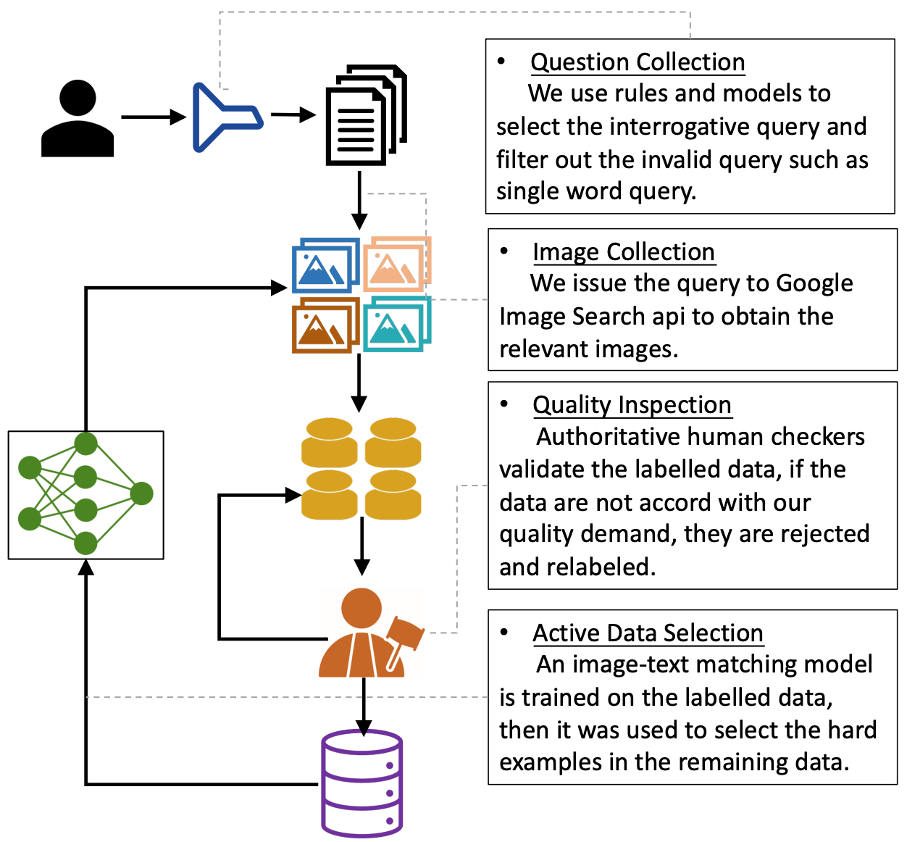
图四:数据收集过程
对于 ChiQA 来说,其一大特色是所有的问题都来源于用户真实的查询。然而,如果我们随机从搜索引擎用户的搜索日志中采样用户的查询,那么大部分查询都是没有问答意图的。
因此我们首先需要过滤出有问答意图的 query。在这个工作中,我们采用了一种内部构造的弱监督方法训练了一个二分类器,来判定一个 query 是不是有问答意图。人工评测这个意图模型能够达到 90% 的精度以及 80% 的召回。我们通过这个模型对用户的 query 进行采样,得到了大约 7.5 万个经过模型判定具有问答意图的用户 query 进入下一轮。
图像收集&标注过程和经验
得到了问题之后,我们将这些问题发送给谷歌提供的开放 API(Google Images API - SerpApi)进行相关图像检索。谷歌 API 对每个 query 会返回最相关的 100 个图像。为了保证最后数据的质量,我们去掉了那些长度或者宽度小于 200 像素的 query以及那些过长或者过宽的图像。
得到了原始图像之后,我们取经过过滤后的前 5 个图片,并让标注人员标注这个 query 和对应的 5 个图片。我们内部专门为本任务设计了一个标注界面,如下图所示。
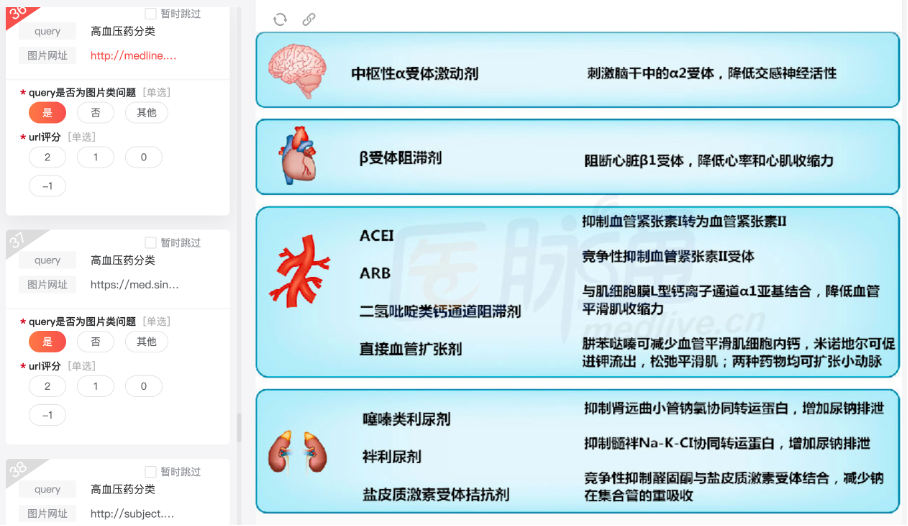
图五:ChiQA 的标注界面
在标注过程中,我们让标注人员标注三个方面:
1) 问题标注
由于本工作主要着眼于图片问答,而事实上在普通的用户问题中很多都和图片问答无关(或者很难用图片来回答)。因此我们首先让标注人员标注这个问题是不是可以算作一个图片问答的问题。例如:
如果一个问题是“xxx 和 xxx 的差别”,那么这个问题就会被认为是一个具有图像问答意图的问题;
如果一个问题是模糊的、具有歧义的或者包含有没有事实根据推论的观点,那么这个问题就会被归类于无图像问答意图,并且不会参与到后续图片标注的过程中。
一些 query 标注的例子如图 6 所示:
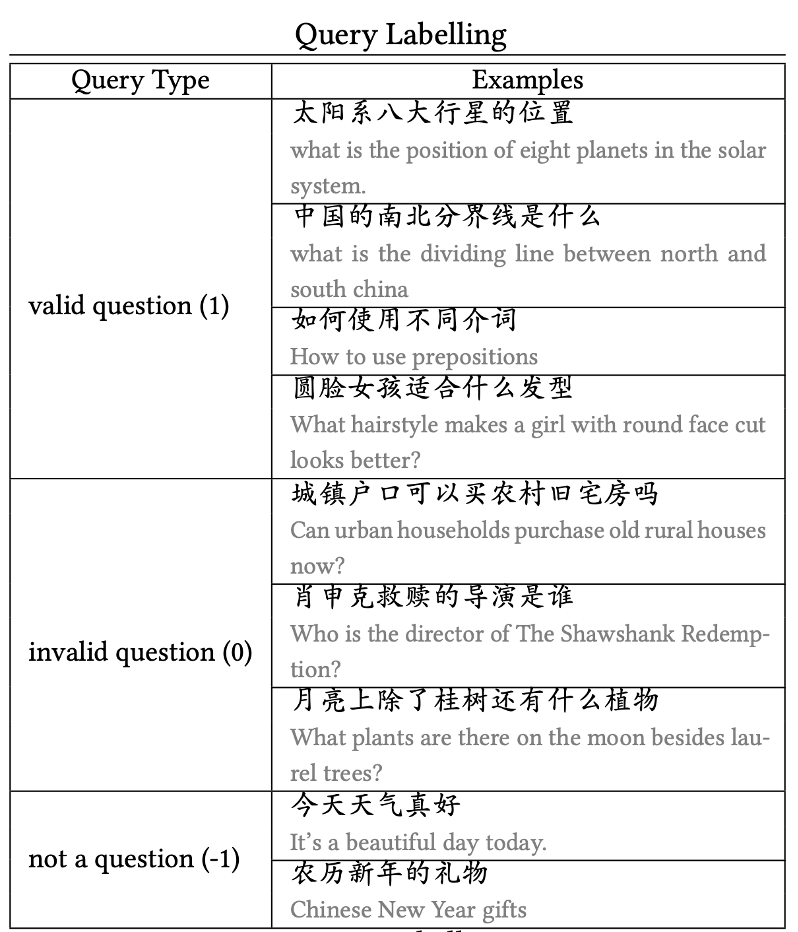
图 6:query 标注的示例
2) 图片标注
对于上一步中有效的 query,我们对其 5 个候选 query 进行标注。标注的标准是三级 0-1-2 标注,其中:
0 分表示这个图片完全不能用来回答这个问题,2 分表示这个图片质量过关并且可以完全独立的回答这个问题。而 1 分的图片则介于这两者之间,表示这个图片和这个 query 相关,但是却无法直接回答,用户可能需要更多的查询或者推理才能得到最终的答案。一些 0 分、1 分、2 分的例子如下图所示:
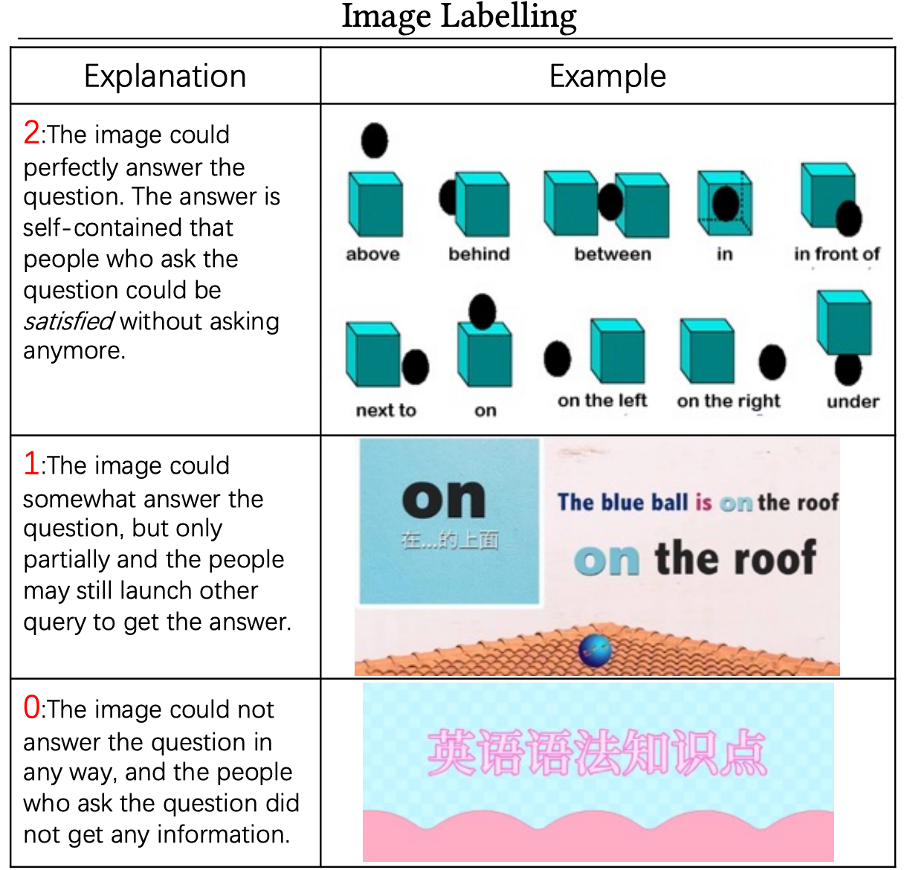
图七:对于问题“如何使用不同介词”,图片标注打分的示例
3) 质量控制
我们在整个标注过程中采用了严格的质量控制方案。具体来说,我们首先会邀请 3 个质量团队进行试标注,选择标注质量最好的那个团队来标注余下所有的数据。其次,在标注过程中,我们会将标注数据分批,每一批次的数据我们会采样其中五分之一的数据进行人工校验,如果数据的合格率小于 90%,那么这一批次的数据将会被打回重新进行标注,直到数据精度达到 90%。
主动学习的数据标注
让结果更无偏
经过数据收集的工作,我们发现如果随机对数据进行采样和标注,那么数据中往往会存在一些简单的模式,这种简单的模式大量存在于数据中可能会对最终的模型造成偏置影响。因此,我们设计了一个主动学习的标注过程。具体来说,我们首先将让标注人员标注一批数据,这一批数据标注完成之后,我们就用这一批数据训练一个跨膜态的文本图像匹配模型。模型训练完毕之后,我们开始用这个模型来 “选择” 新的样本:如果模型对这个新的样本预测非常不确定(即最后分类预测的熵特别大),那么我们认为这个样本相对模型较难,因此有较大概率保留到下一轮中间,反之说明模型对这个数据已经很置信了,那么这个模型以较小的概率保留到下一轮中。
我们发现主动学习数据选择过程确实使数据集更无偏。我们发现第一阶段的标记数据包含一些难以察觉的偏置。例如,包含 “的技巧” 字的问题标记为有效问题,但几乎所有相应的图像被标记为无法回答(即 0 分),因此模型很可能不看图片直接根据 query 中的问题就预测出最终的结果。而这种主动学习的过程降低了这种可能性,这种高置信度且有偏的窍门(shortcut)在下一轮中很难被选择上,从而降低了这种模式的影响面。
测试集标注
我们随机从标注数据中筛选出来 2500 条数据,并且让不同的标注者重新标注。如果标注的结果和之前的结果一样,则这个数据被保留为测试集,要是不一样,我们让一个对任务非常了解的“专家”重新标注这个数据,最终得到了 2362 条测试数据以及超过 4 万条训练数据。训练集和测试集的统计信息如下图所示:
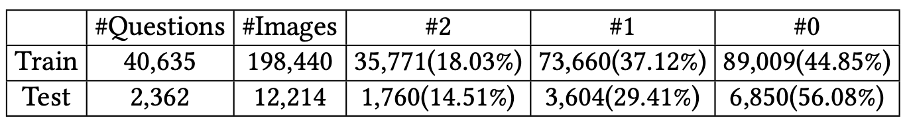
图八:ChiQA 中训练集和测试集的统计信息
数据的推理和分析
在标注完数据之后,我们对 ChiQA 中的数据进行统计和分析。
1)query 常用词分析:
我们用结巴分词对 query 进行切分,并且将 query 中的词按照频率展示在下面的云图上:
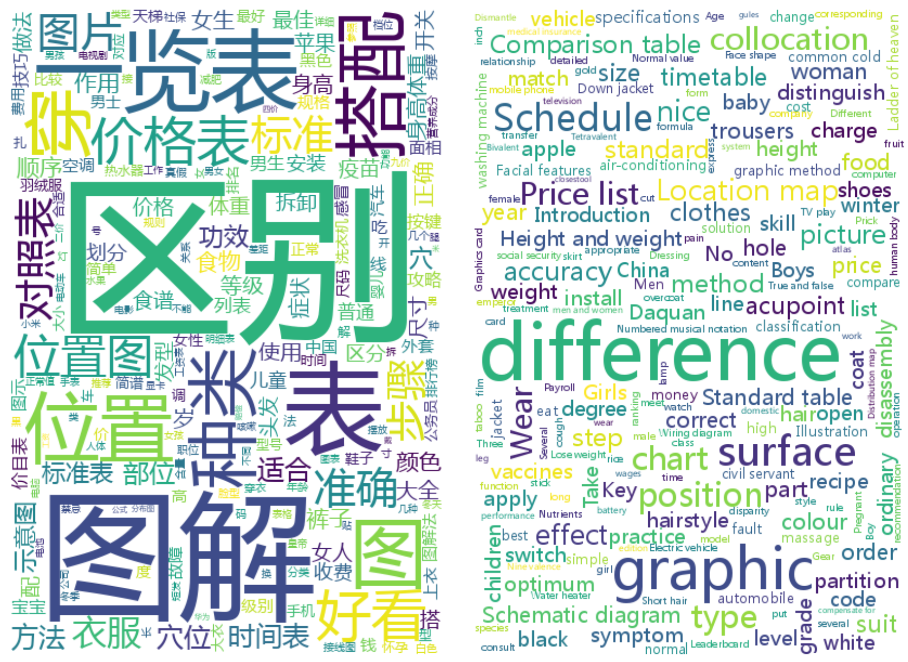
可以看到 ChiQA 中最常见的 query 是区别、图解、位置等。这和我们的直觉一样,因为这些词确实是很适合图片来回答的问题。
2)领域分析
我们使用内部的一个领域分类的分类器来对所有的 query 进行分类,最终的结果如下图所示:
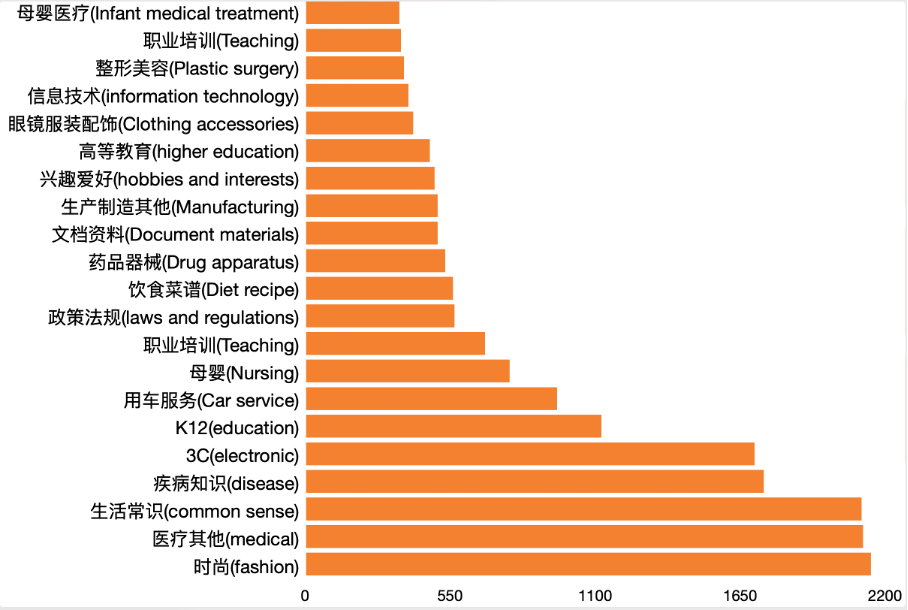
可以看到我们的数据包含有很多种领域的数据,并且没有某一种领域的数据是占绝对多数的。这保证了我们的数据分布是均匀的。其次,我们对问题里面的疑问词也进行统计,结果如下图所示:
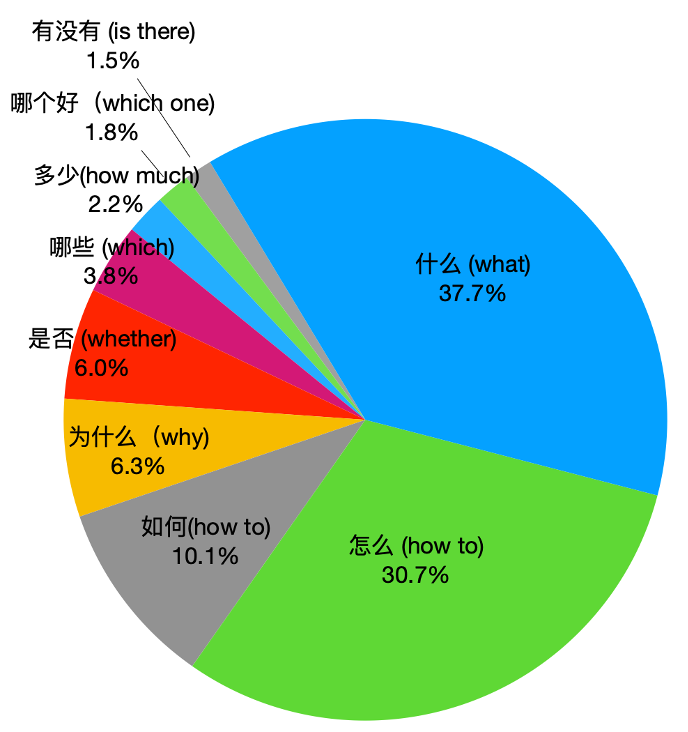
可以看到 ChiQA 中 what 类和 how to 类问题占了大多数,而其他的一些问题也有相当大的比例。
3)图像分析
除了问题之外,我们也对 ChiQA 中的图像进行了分析。由于图像大部分是语言无关的,因此我们采用了一个在业界公认性能比较优良的目标检测模型 DETR 来挖掘出图像中的实体。DETR 可以将图像中的实体映射到标准 MS-COCO 定义的实体中,如 “人物”、“狗” 等。我们对 ChiQA 中的每个图像挖掘出实体,并将最高频次的实体分布展示在下图中:
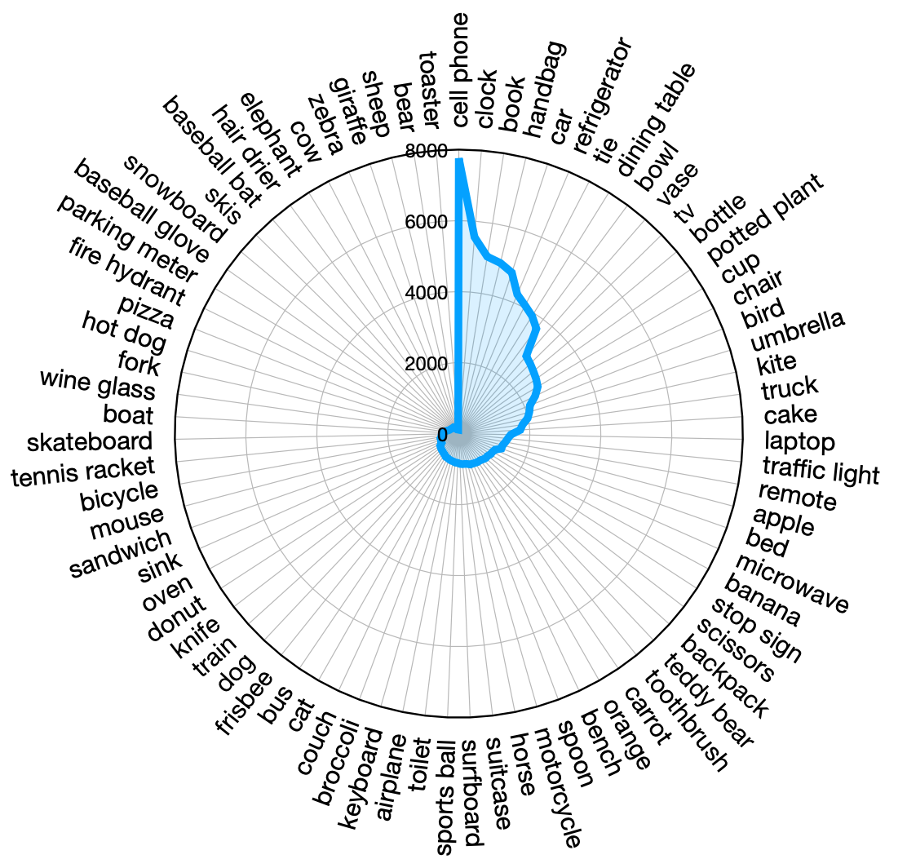
可以看到在 ChiQA 中有超过 30 个实体出现了至少 1000 次,这显示出 ChiQA 是一个分布非常均匀并且覆盖了大部分领域的图像数据,其中出现次数最多的实体是 “人物”、“手机”、“汽车” 等。这个和问题的分布类似。
4)推理技能
为了更好地分析数据,我们还对 ChiQA 数据中所需要的推理技能进行了分析。着重分析了 5 中需要推理的技能:
- Grouding: 需要模型和系统将问题中提到的实体进行理解和定位
- 阅读:需要模型理解图片中出现的文字部分
- 对比:需要模型对比一些不同的属性和内容,例如身高、大小等等
- 因果推理:模型需要深层次理解问题和图片中存在的因果部分(即事物发生的原因或者造成的结果)
- 逻辑推理:需要模型理解问题或者图片中的一些逻辑比较因素,例如否定、条件等等
我们随机采样了 200 条数 ChiQA 据并且根据上述 5 个标准进行标注,其中某些数据可能需要不止一种推理技能。其结果如下图所示。
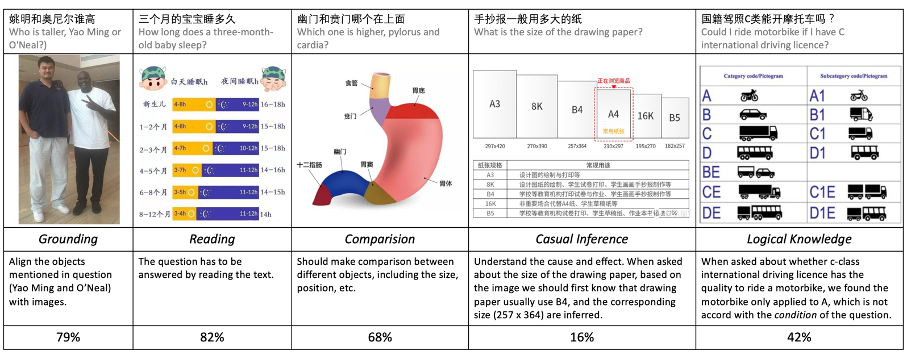
可以看到除了 Grouding 之外,超过 80% 的 ChiQA 数据需要深度理解图片中的文字和对比关系。这和之前大部分的 VQA 数据很不一样。其次,有相当多的问题需要逻辑和对比,说明 ChiQA 中的数据具有相当的难度。我们认为对 ChiQA 中推理技能的分析可以帮助我们更好地理解这个数据,并且为后续的模型设计提供一些先验的指导。
实验评估指标
在 ChiQA 数据集中,标注打分有三挡:0,1,2,所以在实验中我们测试模型排序的指标和普通分类的指标。分为三类:
- NDCG@N:Normalized Discounted Cumulative Gain
- Mean Average Precision(MAP@N):平均精度 (MAP@N)
- Accuray / Precision / Recall / F1
基线模型
我们在 ChiQA 数据集上实验了多个常用的模型。仿照之前图片 - 文本匹配的工作,我们先把图片和文本分别用编码器进行编码,然后将它们的表示进行跨模态融合,最后用一个预测层来获取匹配得分。在下面所列模型中,加♣代表模型经过了预训练,加♦则表示没有。
- Random♦:对测试集中的每条数据,在 0、1、2 中随机选择一个预测分数,random 模型是作为 ChiQA 上的一个基线模型。
- Majority♦:选择训练集中出现最多的标签作为测试集上所有数据的预测分数。
- LSTM+ResNet♦:在文本和视觉的大规模预训练模型出现前,LSTM 和 ResNet 分别是文本和视觉领域最常用的模型之一。
- Bert+ViT♣:我们使用 Bert 模型编码查询文本,使用 ViT 模型编码图片,其中,Bert 和 ViT 模型都是在大规模无监督数据上预训练过的。最后使用 < CLS > 的表示向量进行匹配分数预测。
- ALBEF♣:ALBEF 是一种大规模的视觉和语言表示学习,已经在各种视觉语言任务上展示出较大的改进。
- +Pretrain♣:对于中文的跨模态预训练,我们在悟空数据集上对Bert-ViT和ALBEF进行跨膜态预训练,预训练方式和ALBEF类似。悟空数据集是一个包含1亿个图片-文本对的开源跨模态数据。
- Wenlan♣:Wenlan 是一个大规模的多模态预训练模型,在 3000 万文本-图像对上进行了训练,模型包含近十亿个参数。我们使用他们公开的api服务获取文本和图片的表示向量,并使用两个向量的Cos相似度作为预测的匹配分数。
- Human:除了上述这些模型,我们还评估了人类在测试集上的预测水平。由于测试集数据较多,我们人工随机抽样了 100 条数据进行预测和评估预测指标。
以下是结果显示:
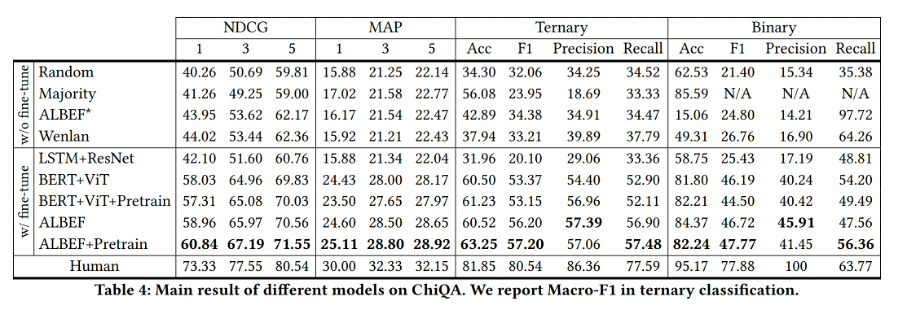
上述模型在测试集上的指标如图所示。我们可以看到,直接应用之前最先进的跨模态方法的效果很差,指标仅比随机打分模型好一点。这意味着 ChiQA 数据较难,仅使用大规模的弱监督对比学习的模型,如 ALBEF*、Wenlan,可能无法区分视觉问答所需的细粒度信息。此外,这些模型的糟糕表现说明,ChiQA 数据集不同于之前弱监督的图像 - 文本匹配数据,因为弱监督的图像 - 文本匹配侧重于相关性,而 ChiQA 数据同时要求图片的可回答性。
最后,在 ChiQA 上微调的模型在基线上取得了很大的进步,但与人类的表现仍然相差较远,所以模型在 ChiQA 数据集还有很大的提升空间。
ChiQA在产品里的应用
随着互联网的发展,用户对问答的需求更高,需要系统提供更为直观、便捷的答案。特别是最近几年,多媒体内容愈加的丰富,以图片、视频为载体的问答内容越来越多的出现在公众面前。QQ 浏览器实验室立知团队在今年 4 月份率先在业界推出图片问答项目,如用户搜猕猴桃和奇异果的区别,结果会以图片的形式直观的展现在用户面前。如下图所示:
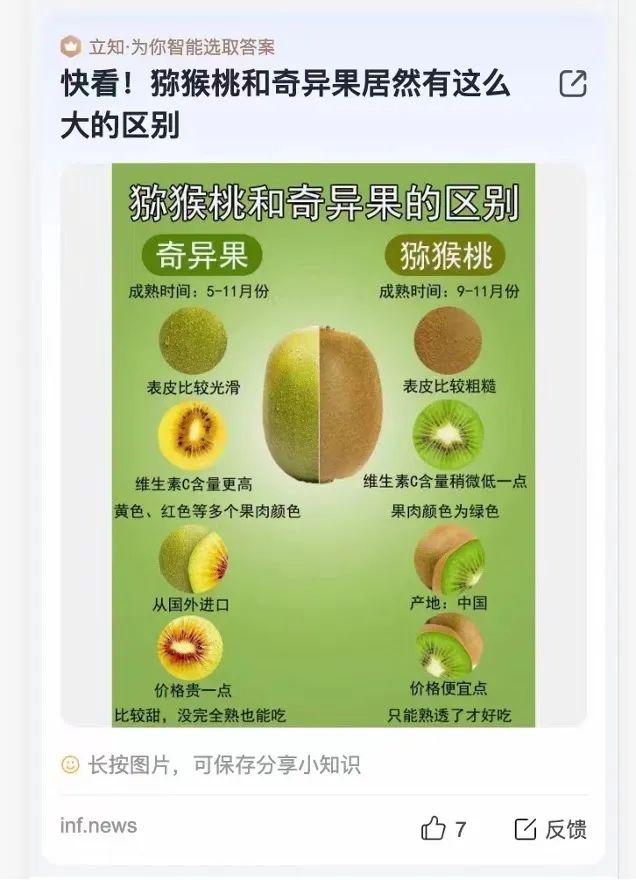
当前这种可以直接由图片满足的问题上线后取得了良好的效果。我们观察到其用户行为(如 CTR、换词率等)相较于传统的结果有着明显的改善,说明当前以图片等为载体的 “新问答” 是一个更能满足用户需求的产品业务。
作者团队介绍
QQ 浏览器搜索技术中心团队是腾讯 PCG 信息平台与服务线负责搜索技术研发的团队,依托腾讯内容生态,通过用户研究驱动产品创新,为用户提供图文、资讯、小说、长短视频、服务等多方位的信息需求满足。在算法方面,以自然语言处理、深度学习、多模态理解与生成、知识计算与应用等技术为基础,建设内容理解、相关性和排序、多模态搜索、智能问答、多语言翻译、搜索推荐等技术方向,探索和应用业界先进技术、打造更优秀的用户搜索体验;在工程方面,建设搜索技术中台工业化系统,打磨高性能、高可用、低成本的百亿级检索系统,为腾讯 PCG 各个内容业务的搜索场景提供基础的搜索引擎服务,当前已支持 QQ 浏览器、腾讯视频、腾讯新闻、腾讯微视等 PCG 多条产品线。

3月28日,OPPOFind系列产品负责人周意保在微博发文,表示OPPO已经进入了5.5G时代。OPPOFindX7系列周意保在微博上传了一张截图,图中的手机锁屏界面右上方状态栏信号一栏显示为5GA,也就是人们更加熟悉的5.5G。此外,周意保也发文称:"和大家一起进入5.5G新移动网络时代!"宣布了5.5G新移动网络时代的到来。OPPOFind系列产品负责人周意保微博有博主表示,OPPOFindX7系列即将行业首发支持5G-A(5.5G),OTA固件已经准备好了。5G-A理论上可以实现10倍提升的连接速率
3月18日,通用技术集团机床产业生态合作伙伴大会在北京国家会议中心举行 春日的北京,一场关乎中国工业未来的盛会拉开帷幕。通用技术集团机床产业生态合作伙伴大会在国家会议中心举行,近500位产业链上下游的企业代表与行业专家齐聚一堂。会上,通用技术集团总工程师、机床公司董事长周舟发布了集团机床产业的未来发

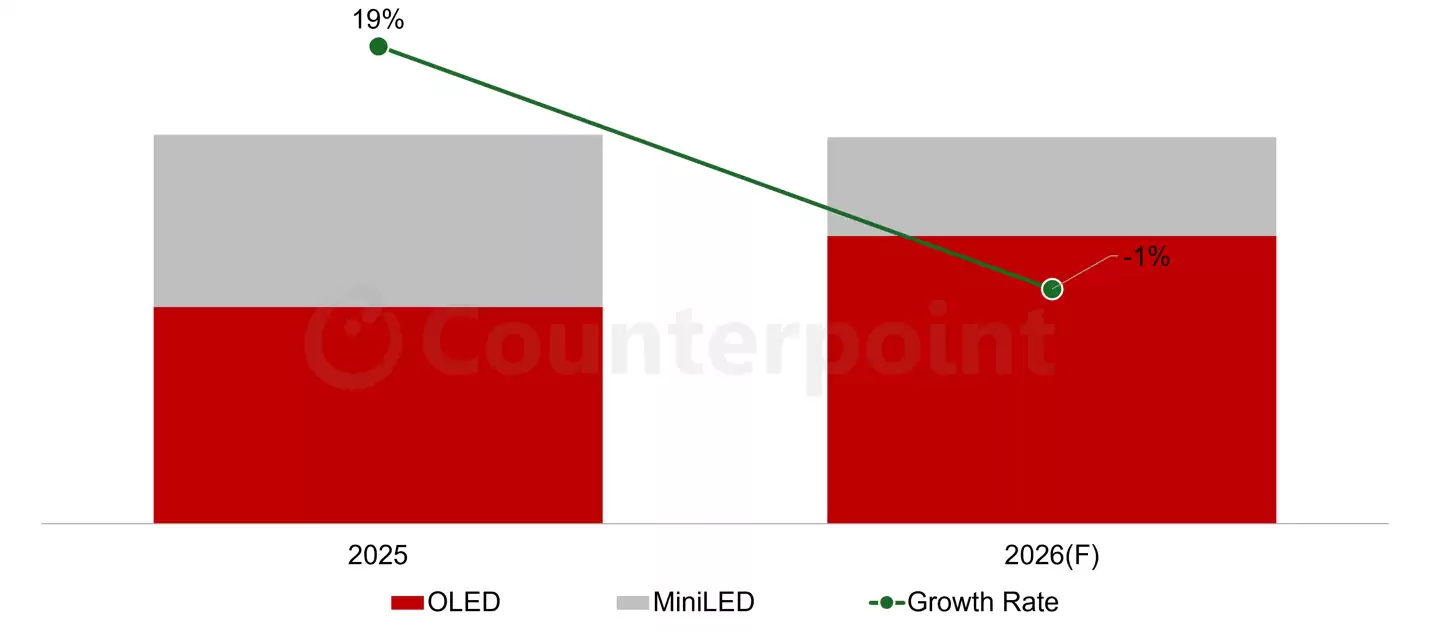

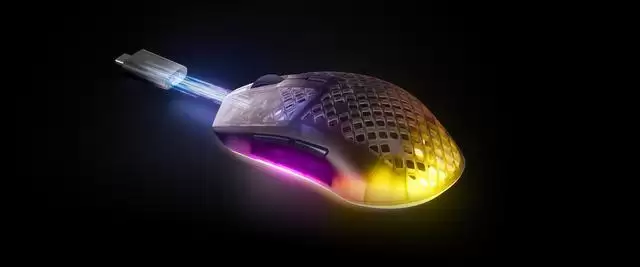
赛睿Aerox 3 Wireless Gen 2鼠标评测:当轻量化与光效完美邂逅 作为外设领域的老牌劲旅,赛睿在轻量化鼠标的赛道上又有了新动作。最近,它们带来了第二代Aerox 3无线鼠标。这款新品依然延续了那个极具辨识度的挖孔“洞洞鼠”设计,但在灯光、性能和耐用性上都做了针对性升级。对于追求极致手
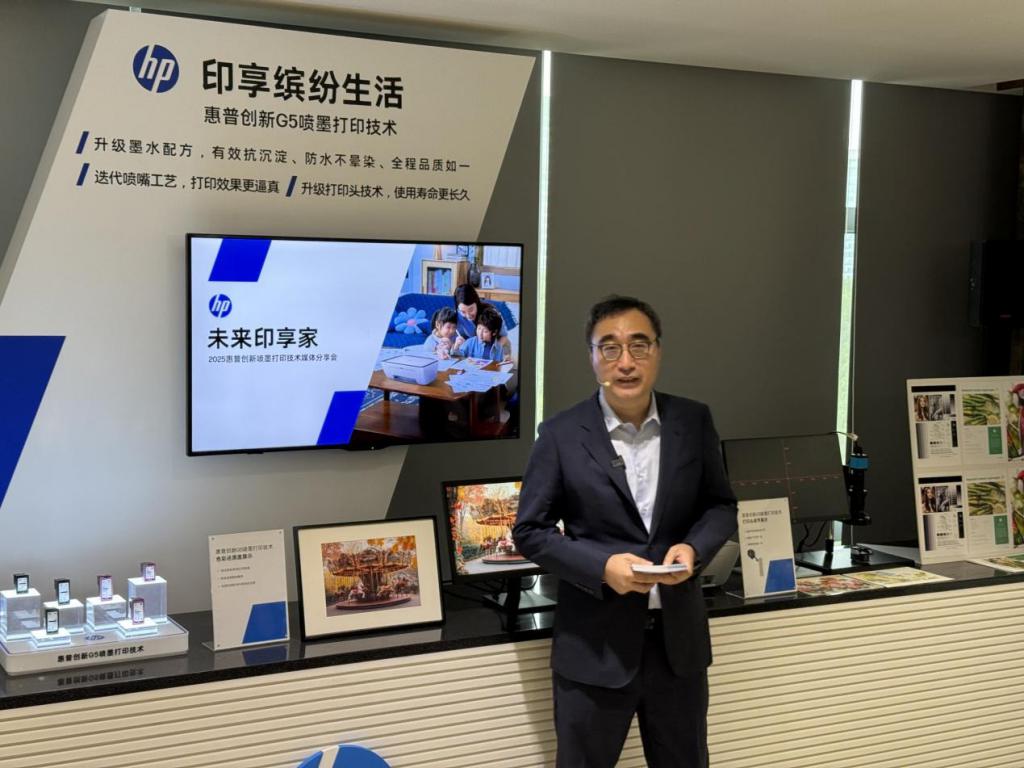
9月23日,2025惠普创新喷墨打印技术媒体分享会在北京圆满举行。惠普正式发布全新一代G5喷墨打印技术,并推出多款面向家庭学习、办公应用及照片打印的全新产品,致力于为中国用户打造更智能、更稳定的打印体验。据悉,G5技术采用先进的墨滴精准控制技术和优化升级的黑色墨水配方,显著提升输出品质,使文字边缘更锐利、图像色彩更逼真。同时具备防荧光笔渗透、防水防褪色等实用性能。其打印头寿命长达2000小时不堵塞,相比上一代延长50%,大幅降低维护频率与使用成本,切实解决家庭用户的日常困扰。此次惠普还
11月26日,据相关报道,Tachyum正式推出其全新研发的TDIMM内存技术,旨在为人工智能与高性能计算领域带来更高带宽、更大容量及更低功耗的先进解决方案。该技术基于Tachyum旗下的ProdigyUltimate处理器平台构建,单条TDIMM模块可实现高达281GB/s的带宽,相较当前主流的DDR5内存提升了约5.5倍。ProdigyUltimate处理器支持多达24个内存通道,使系统总带宽达到惊人的6.7TB/s,约为传统12通道CPU系统的11倍水平。在存储容量方面,标准版TDIMM提供
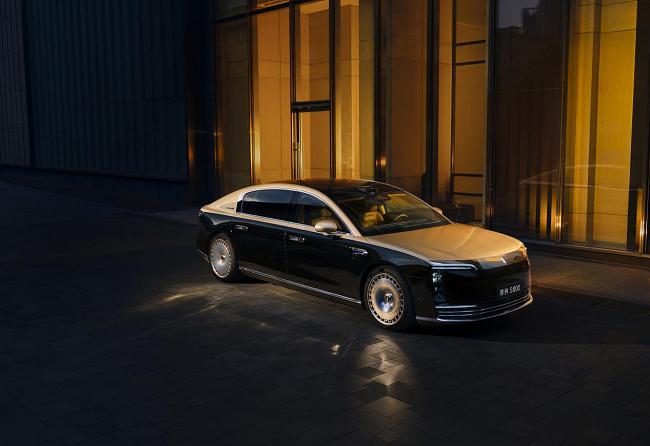
在自动驾驶步入攻坚阶段的2026年,算力竞赛已逐渐走向平台化与标准化,产业竞争的焦点正悄然转向感知能力的维度跃迁。据内部消息人士透露,鸿蒙智行即将启动一轮关键性技术升级,其中最具突破性的亮点,当属全新一代激光雷达的正式登场。事实上,激光雷达性能的跨越式进步具有深远战略价值。当部分车企仍在纯视觉方案与多传感器融合路径之间反复权衡时,业内普遍研判,鸿蒙智行正通过强化底层感知硬件,为全场景高阶智能驾驶打造更牢靠的三维物理世界建模根基。有接近项目的消息源进一步指出,这项有望重新定义行业技术边界的前沿成果,或将率先





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



