

持续学习常用六种方法总结:使ML模型适应新数据的同时保持旧数据的性能
持续学习是指在不忘记从前面的任务中获得的知识的情况下,按顺序学习大量任务的模型。这是一个重要的概念,因为在监督学习的前提下,机器学习模型被训练为针对给定数据集或数据分布的最佳函数。而在现实环境中,数据很少是静态的,可能会发生变化。当面对不可见的数据时,典型的ML模型可能会性能下降。这种现象被称为灾难性遗忘。解决这类问题的常用方法是在包含新旧数据的新的更大数据集上对整个模型进行再训练。但是这种做法往往代价高昂。所以有一个ML研究领域正在研究这个问题,基于该领域的研究,本文将讨论6种方法,使模型可以在保持旧的
持续学习是指在不忘记从前面的任务中获得的知识的情况下,按顺序学习大量任务的模型。这是一个重要的概念,因为在监督学习的前提下,机器学习模型被训练为针对给定数据集或数据分布的最佳函数。而在现实环境中,数据很少是静态的,可能会发生变化。当面对不可见的数据时,典型的ML模型可能会性能下降。这种现象被称为灾难性遗忘。
解决这类问题的常用方法是在包含新旧数据的新的更大数据集上对整个模型进行再训练。但是这种做法往往代价高昂。所以有一个ML研究领域正在研究这个问题,基于该领域的研究,本文将讨论6种方法,使模型可以在保持旧的性能的同时适应新数据,并避免需要在整个数据集(旧+新)上进行重新训练。
Prompt
Prompt 想法源于对GPT 3的提示(短序列的单词)可以帮助驱动模型更好地推理和回答。所以在本文中将Prompt 翻译为提示。提示调优是指使用小型可学习的提示,并将其与实际输入一起作为模型的输入。这允许我们只在新数据上训练提供提示的小模型,而无需再训练模型权重。
具体来说,我选择了使用提示进行基于文本的密集检索的例子,这个例子改编自Wang的文章《Learning to Prompt for continuous Learning》。
该论文的作者使用下图描述了他们的想法:
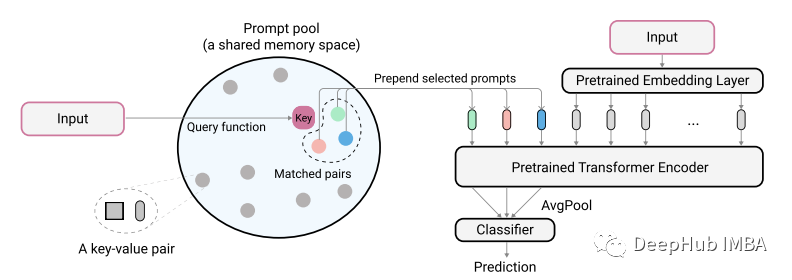
实际编码的文本输入用作从提示池中识别最小匹配对的key。在将这些标识的提示输入到模型之前,首先将它们添加到未编码的文本嵌入中。这样做的目的是训练这些提示来表示新的任务,同时保持旧的模型不变,这里提示的很小,大概每个提示只有20个令牌。
class PromptPool(nn.Module):
def __init__(self, M = 100, hidden_size = 768, length = 20, N=5):
super().__init__()
self.pool = nn.Parameter(torch.rand(M, length, hidden_size), requires_grad=True).float()
self.keys = nn.Parameter(torch.rand(M, hidden_size), requires_grad=True).float()

self.length = length
self.hidden = hidden_size
self.n = N

nn.init.xavier_normal_(self.pool)
nn.init.xavier_normal_(self.keys)

def init_weights(self, embedding):
pass

# function to select from pool based on index
def concat(self, indices, input_embeds):
subset = self.pool[indices, :] # 2, 2, 20, 768

subset = subset.to("cuda:0").reshape(indices.size(0),
self.n*self.length,
self.hidden) # 2, 40, 768

return torch.cat((subset, input_embeds), 1)

# x is cls output
def query_fn(self, x):

# encode input x to same dim as key using cosine
x = x / x.norm(dim=1)[:, None]
k = self.keys / self.keys.norm(dim=1)[:, None]

scores = torch.mm(x, k.transpose(0,1).to("cuda:0"))

# get argmin
subsets = torch.topk(scores, self.n, 1, False).indices # k smallest

return subsets

 pool = PromptPool()
然后我们使用的经过训练的旧数据模型,训练新的数据,这里只训练提示部分的权重。
def train():
count = 0
print("*********** Started Training *************")

start = time.time()
for epoch in range(40):
model.eval()
pool.train()

optimizer.zero_grad(set_to_none=True)
lap = time.time()

for batch in iter(train_dataloader):
count += 1
q, p, train_labels = batch

queries_emb = model(input_ids=q['input_ids'].to("cuda:0"),
attention_mask=q['attention_mask'].to("cuda:0"))
passage_emb = model(input_ids=p['input_ids'].to("cuda:0"),
attention_mask=p['attention_mask'].to("cuda:0"))

# pool
q_idx = pool.query_fn(queries_emb)
raw_qembedding = model.model.embeddings(input_ids=q['input_ids'].to("cuda:0"))
q = pool.concat(indices=q_idx, input_embeds=raw_qembedding)

p_idx = pool.query_fn(passage_emb)
raw_pembedding = model.model.embeddings(input_ids=p['input_ids'].to("cuda:0"))
p = pool.concat(indices=p_idx, input_embeds=raw_pembedding)

qattention_mask = torch.ones(batch_size, q.size(1))
pattention_mask = torch.ones(batch_size, p.size(1))

queries_emb = model.model(inputs_embeds=q,
attention_mask=qattention_mask.to("cuda:0")).last_hidden_state
passage_emb = model.model(inputs_embeds=p,
attention_mask=pattention_mask.to("cuda:0")).last_hidden_state

q_cls = queries_emb[:, pool.n*pool.length+1, :]
p_cls = passage_emb[:, pool.n*pool.length+1, :]

loss, ql, pl = calc_loss(q_cls, p_cls)
loss.backward()

optimizer.step()
optimizer.zero_grad(set_to_none=True)

if count % 10 == 0:
print("Model Loss:", round(loss.item(),4),
"| QL:", round(ql.item(),4), "| PL:", round(pl.item(),4),
"| Took:", round(time.time() - lap), "secondsn")

lap = time.time()

if count % 40 == 0 and count > 0:
print("model saved")
torch.save(model.state_dict(), model_PATH)
torch.save(pool.state_dict(), pool_PATH)

if count == 4600: return

print("Training Took:", round(time.time() - start), "seconds")
print("n*********** Training Complete *************")
训练完成后,后续的推理过程需要将输入与检索到的提示结合起来。例如这个例子得到了性能—93%的新数据提示池,而完全(旧+新)训练为—94%。这与原论文中提到的表现类似。但是需要说明的一点是结果可能会因任务而不同,你应该尝试实验来知道什么是最好的。
要使此方法成为值得考虑的方法,它必须能够在旧数据上保留老模型> 80%的性能,同时提示也应该帮助模型在新数据上获得良好的性能。
这种方法的缺点是需要使用提示池,这会增加额外的时间。这也不是一个永久的解决方案,但是目前来说是可行的,也或许以后还会有新的方法出现。
Data Distillation
你可能听说过知识蒸馏一词,这是一种使用来自教师模型的权重来指导和训练较小规模模型的技术。数据蒸馏(Data Distillation)的工作原理也类似,它是使用来自真实数据的权重来训练更小的数据子集。因为数据集的关键信号被提炼并浓缩为更小的数据集,我们对新数据的训练只需要提供一些提炼的数据以保持旧的性能。
在此示例中,我将数据蒸馏应用于密集检索(文本)任务。目前看没有其他人在这个领域使用这种方法,所以结果可能不是最好的,但如果你在文本分类上使用这种方法应该会得到不错的结果。
本质上,文本数据蒸馏的想法源于 Li 的一篇题为 Data Distillation for Text Classification 的论文,该论文的灵感来自 Wang 的 Dataset Distillation,他对图像数据进行了蒸馏。Li 用下图描述了文本数据蒸馏的任务:
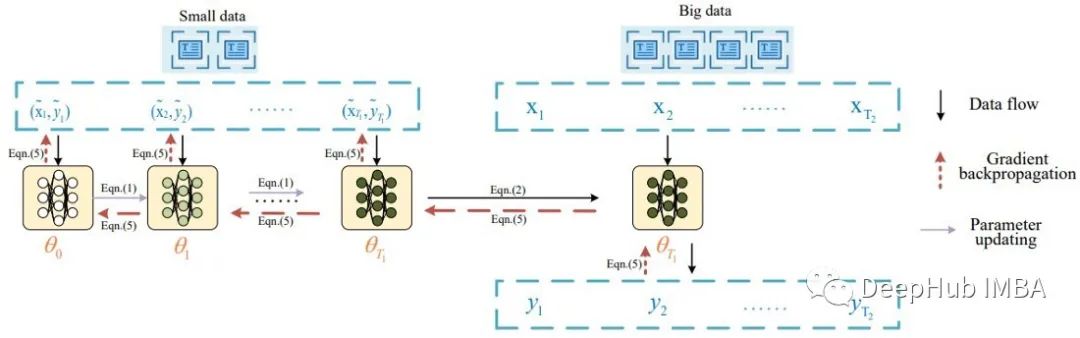
根据论文,首先将一批蒸馏数据输入到模型以更新其权重。然后使用真实数据评估更新后的模型,并将信号反向传播到蒸馏数据集。该论文在 8 个公共基准数据集上报告了良好的分类结果(> 80% 准确率)。
按照提出的想法,我做了一些小的改动,使用了一批蒸馏数据和多个真实数据。以下是为密集检索训练创建蒸馏数据的代码:
class DistilledData(nn.Module):
def __init__(self, num_labels, M, q_len=64, hidden_size=768):
super().__init__()
self.num_samples = M
self.q_len = q_len
self.num_labels = num_labels
self.data = nn.Parameter(torch.rand(num_labels, M, q_len, hidden_size), requires_grad=True) # i.e. shape: 1000, 4, 64, 768

# init using model embedding, xavier, or load from state dict
def init_weights(self, model, path=None):
if model:
self.data.requires_grad = False
print("Init weights using model embedding")
raw_embedding = model.model.get_input_embeddings()
soft_embeds = raw_embedding.weight[:, :].clone().detach()
nums = soft_embeds.size(0)
for i1 in range(self.num_labels):
for i2 in range(self.num_samples):
for i3 in range(self.q_len):
random_idx = random.randint(0, nums-1)
self.data[i1, i2, i3, :] = soft_embeds[random_idx, :]
print(self.data.shape)
self.data.requires_grad = True

if not path:
nn.init.xavier_normal_(self.data)
else:
distilled_data.load_state_dict(torch.load(path), strict=False)

# function to sample a passage and positive sample as in the article, i am doing dense retrieval
def get_sample(self, label):
q_idx = random.randint(0, self.num_samples-1)
sampled_dist_q = self.data[label, q_idx, :, :]

p_idx = random.randint(0, self.num_samples-1)
while q_idx == p_idx:
p_idx = random.randint(0, self.num_samples-1)
sampled_dist_p = self.data[label, p_idx, :, :]

return sampled_dist_q, sampled_dist_p, q_idx, p_idx
这是将信号提取到蒸馏数据上的代码
def distll_train(chunk_size=32):
count, times = 0, 0
print("*********** Started Training *************")
start = time.time()
lap = time.time()

for epoch in range(40):
distilled_data.train()

for batch in iter(train_dataloader):
count += 1
# get real query, pos, label, distilled data query, distilled data pos, ... from batch
q, p, train_labels, dq, dp, q_indexes, p_indexes = batch

for idx in range(0, dq['input_ids'].size(0), chunk_size):
model.train()

with torch.enable_grad():
# train on distiled data first
x1 = dq['input_ids'][idx:idx+chunk_size].clone().detach().requires_grad_(True)
x2 = dp['input_ids'][idx:idx+chunk_size].clone().detach().requires_grad_(True)
q_emb = model(inputs_embeds=x1.to("cuda:0"),
attention_mask=dq['attention_mask'][idx:idx+chunk_size].to("cuda:0")).cpu()
p_emb = model(inputs_embeds=x2.to("cuda:0"),
attention_mask=dp['attention_mask'][idx:idx+chunk_size].to("cuda:0"))
loss = default_loss(q_emb.to("cuda:0"), p_emb)
del q_emb, p_emb

loss.backward(retain_graph=True, create_graph=False)
state_dict = model.state_dict()

# update model weights
with torch.no_grad():
for idx, param in enumerate(model.parameters()):
if param.requires_grad and not param.grad is None:
param.data -= (param.grad*3e-5)

# real data
model.eval()
q_embs = []
p_embs = []
for k in range(0, len(q['input_ids']), chunk_size):
with torch.no_grad():
q_emb = model(input_ids=q['input_ids'][k:k+chunk_size].to("cuda:0"),).cpu()
p_emb = model(input_ids=p['input_ids'][k:k+chunk_size].to("cuda:0"),).cpu()
q_embs.append(q_emb)
p_embs.append(p_emb)
q_embs = torch.cat(q_embs, 0)
p_embs = torch.cat(p_embs, 0)
r_loss = default_loss(q_embs.to("cuda:0"), p_embs.to("cuda:0"))
del q_embs, p_embs

# distill backward
if count % 2 == 0:
d_grad = torch.autograd.grad(inputs=[x1.to("cuda:0")],#, x2.to("cuda:0")],
outputs=loss,
grad_outputs=r_loss)
indexes = q_indexes
else:
d_grad = torch.autograd.grad(inputs=[x2.to("cuda:0")],
outputs=loss,
grad_outputs=r_loss)
indexes = p_indexes
loss.detach()
r_loss.detach()

grads = torch.zeros(distilled_data.data.shape) # lbl, 10, 100, 768
for i, k in enumerate(indexes):
grads[train_labels[i], k, :, :] = grads[train_labels[i], k, :, :].to("cuda:0")
+ d_grad[0][i, :, :]
distilled_data.data.grad = grads
data_optimizer.step()
data_optimizer.zero_grad(set_to_none=True)

model.load_state_dict(state_dict)
model_optimizer.step()
model_optimizer.zero_grad(set_to_none=True)

if count % 10 == 0:
print("Count:", count ,"| Data:", round(loss.item(), 4), "| Model:",
round(r_loss.item(),4), "| Time:", round(time.time() - lap, 4))
# print()
lap = time.time()

if count % 100 == 0:
torch.save(model.state_dict(), model_PATH)
torch.save(distilled_data.state_dict(), distill_PATH)

if loss < 0.1 and r_loss < 1:
times += 1

if times > 100:
print("Training Took:", round(time.time() - start), "seconds")
print("n*********** Training Complete *************")
return
del loss, r_loss, grads, q, p, train_labels, dq, dp, x1, x2, state_dict

print("Training Took:", round(time.time() - start), "seconds")
print("n*********** Training Complete *************")
这里省略了数据加载等代码,训练完蒸馏的数据后,我们可以通过在其上训练新模型来使用它,例如将其与新数据合并一起训练。
根据我的实验,一个在蒸馏数据上训练的模型(每个标签只包含4个样本)获得了66%的最佳性能,而一个完全在原始数据上训练的模型也是得到了66%的最佳性能。而未经训练的普通模型得到45%的性能。就像上面提到的这些数字对于密集检索任务可能不太好,分类数据上会好很多。
要使此方法成为在调整模型以适应新数据时值是一个有用的方法,需要能够提取出比原始数据小得多的数据集(即~ 1%)。经过提炼的数据也能够给你一个略低于或等于主动学习方法的表现。
这个方法的优点是可以创建用于永久使用的蒸馏数据。缺点是提取的数据没有可解释性,并且需要额外的训练时间。
Curriculum/Active training
Curriculum training是一种方法,训练时向模型提供训练样本的难度逐渐变大。在对新数据进行训练时,此方法需要人工的对任务进行标注,将任务分为简单、中等或困难,然后对数据进行采样。为了理解模型的简单、中等或困难意味着什么,我以这张图片为例:
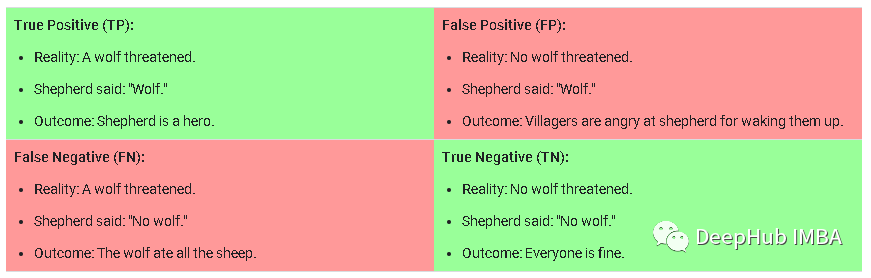
这是在分类任务中的混淆矩阵,困难样本是假阳性(False Positive),是指模型预测为True的可能性很高,但实际上不是True的样本。中等样本是那些具有中到高的正确性可能性但低于预测阈值的True Negative。而简单样本则是那些可能性较低的True Positive/Negative。
Maximally Interfered Retrieval
这是 Rahaf 在题为“Online Continual Learning with Maximally Interfered Retrieval”的论文(1908.04742)中介绍的一种方法。主要思想是,对于正在训练的每个新数据批次,如果针对较新数据更新模型权重,将需要识别在损失值方面受影响最大的旧样本。保留由旧数据组成的有限大小的内存,并检索最大干扰的样本以及每个新数据批次以一起训练。
这篇论文在持续学习领域是一篇成熟的论文,并且有很多引用,因此可能适用于您的案例。
Retrieval Augmentation
检索增强(Retrieval Augmentation)是指通过从集合中检索项目来扩充输入、样本等的技术。这是一个普遍的概念而不是一个特定的技术。我们到目前为止所讨论的方法,大多数都在一定程度都是检索相关的操作。Izacard 的题为 Few-shot Learning with Retrieval Augmented Language Models 的论文使用更小的模型获得了出色的少样本 学习的性能。检索增强也用于许多其他情况,例如单词生成或回答事实问题。
扩展模型在训练时使用附加层是最常见也最简单的方法,但是不一定有效,所以在这里不进行详细的讨论,这里的一个例子是 Lewis 的 Efficient Few-Shot Learning without Prompts。使用附加层通常是在新旧数据上获得良好性能的最简单但经过尝试和测试的方法。主要思想是保持模型权重固定,并通过分类损失在新数据上训练一层或几层。
总结在本文中,我介绍了在新数据上训练模型时可以使用的 6 种方法。与往常一样应该进行实验并决定哪种方法最适合,但是需要注意的是,除了我上面的方法外还有很多方法,例如数据蒸馏是计算机视觉中的一个活跃领域,你可以找到很多关于它的论文。最后说明的一点是:要使这些方法有价值,它们应该在旧数据和新数据上同时获得良好的性能 。

机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
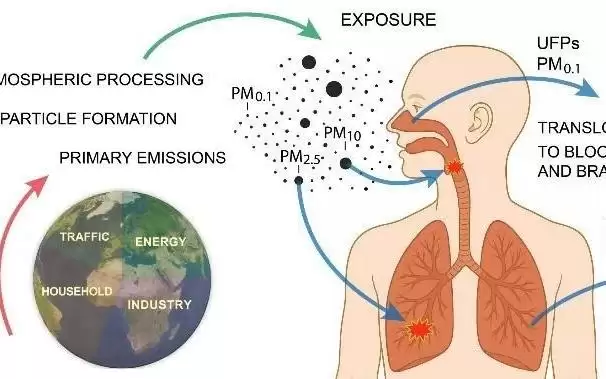
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化
机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。
少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



