

Golang反射获取嵌套字段方法详解
在Go语言中,通过反射访问结构体多层嵌套字段最直接的方法是使用reflect.Value的FieldByIndex方法。它接受一个整数切片来指定字段路径,依次表示每层结构体中字段的索引位置。例如,访问Employee结构体中Details.Location.City字段的路径为[]int{3,1,0},分别对应Details、Location和City在各自层级中的索引。相比于FieldByName,FieldByIndex更高效且无歧义,尤其适合编译时确定路径的场景。使用时需注意字段类型是否为结构体、值
在Go语言中,通过反射访问结构体多层嵌套字段最直接的方法是使用reflect.Value的FieldByIndex方法。它接受一个整数切片来指定字段路径,依次表示每层结构体中字段的索引位置。例如,访问Employee结构体中Details.Location.City字段的路径为[]int{3, 1, 0},分别对应Details、Location和City在各自层级中的索引。相比于FieldByName,FieldByIndex更高效且无歧义,尤其适合编译时确定路径的场景。使用时需注意字段类型是否为结构体、值是否可设置以及字段可见性等陷阱。此外,也可选择FieldByName、FieldByNameFunc或手动遍历字段等方式,但FieldByIndex在明确路径下更具优势。

在Go语言中,如果你想通过反射来访问一个结构体内部嵌套的字段,尤其是多层嵌套的字段,reflect.Value 类型提供的 FieldByIndex 方法无疑是最直接和强大的工具。它通过一个整数切片来精确指定字段的访问路径,就像你在地图上根据坐标找到具体位置一样。
Golang反射获取结构体嵌套字段的实际操作
我们来直接看一个例子。假设我们有这样的结构体定义:
package main

import (
    "fmt"
    "reflect"
)

type Location struct {
    City    string
    ZipCode string
}

type Employee struct {
    ID       string
    Name     string
    Position string
    Details  struct { // 匿名嵌套结构体
        Age      int
        Location Location // 具名嵌套结构体
    }
    IsActive bool
}

func main() {
    emp := Employee{
        ID:       "EMP001",
        Name:     "张三",
        Position: "软件工程师",
        Details: struct {
            Age      int
            Location Location
        }{
            Age: 30,
            Location: Location{
                City:    "北京",
                ZipCode: "100000",
            },
        },
        IsActive: true,
    }

    // 获取reflect.Value
    empValue := reflect.ValueOf(emp)

    // 访问 Name 字段
    nameField := empValue.FieldByName("Name")
    if nameField.IsValid() {
        fmt.Printf("员工姓名: %v\n", nameField.Interface())
    }

    // 使用 FieldByIndex 访问嵌套字段
    // emp.Details.Location.City
    // 路径解析:
    // empValue.FieldByIndex([]int{3, 1, 0})
    // 3: Details 字段在 Employee 中的索引 (ID=0, Name=1, Position=2, Details=3)
    // 1: Location 字段在 Details 中的索引 (Age=0, Location=1)
    // 0: City 字段在 Location 中的索引 (City=0, ZipCode=1)

    cityField := empValue.FieldByIndex([]int{3, 1, 0})
    if cityField.IsValid() {
        fmt.Printf("员工所在城市: %v\n", cityField.Interface())
    } else {
        fmt.Println("无法获取城市字段,路径可能不正确或字段不存在。")
    }

    // 尝试修改一个字段的值
    // 注意:如果 reflect.Value 是从一个非指针类型创建的,通常不能直接修改其内部字段。
    // 需要传入指针才能修改原始值。
    empPtrValue := reflect.ValueOf(&emp).Elem() // 获取指针指向的实际值
    if empPtrValue.CanSet() {
        positionField := empPtrValue.FieldByIndex([]int{2}) // Position 字段
        if positionField.CanSet() && positionField.Kind() == reflect.String {
            positionField.SetString("高级软件工程师")
            fmt.Printf("修改后的职位: %v\n", emp.Position)
        }

        // 尝试修改嵌套字段
        nestedCityField := empPtrValue.FieldByIndex([]int{3, 1, 0})
        if nestedCityField.CanSet() && nestedCityField.Kind() == reflect.String {
            nestedCityField.SetString("上海")
            fmt.Printf("修改后的城市: %v\n", emp.Details.Location.City)
        }
    }
}
这段代码展示了如何利用 FieldByIndex 来深入访问多层嵌套的字段。关键在于那个 []int 切片,它定义了从根结构体开始,每层结构体中目标字段的索引位置。这个索引是基于字段在结构体定义中的声明顺序,从0开始计数。比如 Employee 中的 Details 是第四个字段(索引为3),Details 结构体中的 Location 是第二个字段(索引为1),Location 中的 City 是第一个字段(索引为0)。
为什么FieldByIndex在处理结构体嵌套时如此高效?
说实话,FieldByIndex 在处理结构体嵌套字段时,它的“高效”更多体现在其精确性和稳定性上,而非绝对的性能优势。当然,相比于反复使用 FieldByName 进行字符串查找,FieldByIndex 确实可能在理论上减少一些字符串比较和哈希查找的开销,因为它直接使用了编译时确定的字段偏移量。
但更重要的点在于:
- 直接路径寻址:它提供了一个直接的、基于索引的访问路径。这就像你在一个数组里,直接用
arr[index]访问元素一样,非常直接。而FieldByName则需要遍历字段列表,进行名称匹配。 - 避免歧义:在某些复杂场景,比如结构体匿名嵌入,可能会有字段名冲突的情况。虽然 Go 的规则会处理这种提升(promotion),但
FieldByIndex总是根据其在特定层级的物理位置来定位,避免了任何潜在的名称解析歧义。 - 编译时信息利用:字段的索引是在编译时确定的。
FieldByIndex实际上是利用了 Go 运行时对结构体内存布局的了解,通过这些索引快速计算出目标字段的内存地址偏移量。这使得它在运行时能非常迅速地定位到目标字段。 - 应对匿名字段:即使是匿名字段(匿名嵌入的结构体),
FieldByIndex也能很好地工作。匿名字段本质上也是结构体的一个字段,只是它没有显式的名称。你仍然可以通过其在父结构体中的索引来访问它,然后继续深入到其内部字段。
我个人觉得,FieldByIndex 的这种设计,体现了 Go 语言在提供反射能力时,既考虑了灵活性,也兼顾了底层效率的平衡。当你明确知道结构体的层级和字段顺序时,它就是你的最佳选择。
深入理解FieldByIndex的索引路径:层级与陷阱
FieldByIndex 的核心就是那个 []int 类型的索引路径。理解它,就理解了 FieldByIndex 的全部。
- 层级概念:切片中的每个整数代表一个层级。第一个整数是根结构体中的字段索引,第二个整数是第一个字段(必须是结构体类型)内部的字段索引,以此类推。这个索引是基于字段在结构体定义中的声明顺序,从
0开始。 - 索引的确定:要确定一个字段的索引,你只需要看它在结构体定义中是第几个声明的。比如
type MyStruct { A int; B string; C bool },那么A的索引是0,B是1,C是2。 - 匿名嵌入结构体:这是一个容易让人困惑的地方。如果一个结构体
A匿名嵌入了B,那么B在A中依然是一个字段,它有自己的索引。比如:type Inner struct { Value int } type Outer struct { ID string; Inner } // Inner 是匿名嵌入要访问
Outer的Inner字段的Value,你需要reflect.ValueOf(outerVar).FieldByIndex([]int{1, 0})。这里的1是Inner在Outer中的索引(ID是0),0是Value在Inner中的索引。
常见的陷阱:
- 索引越界或类型不匹配导致 panic:如果
FieldByIndex路径中的某个索引超出了当前层级字段的数量,或者路径中的某个中间字段不是结构体类型(例如,你尝试访问string类型的Name字段的子字段),FieldByIndex会直接panic。在使用前,最好通过IsValid()和Kind()来检查reflect.Value的有效性和类型。 - 值类型与指针类型:这是反射操作中一个永恒的痛点。如果你通过
reflect.ValueOf(myStruct)传入一个值类型,那么FieldByIndex返回的reflect.Value通常是不可设置的 (CanSet()返回false)。因为你操作的是原始值的副本。如果你想修改原始结构体的值,必须传入一个指针,并通过reflect.ValueOf(&myStruct).Elem()来获取其底层元素,这样返回的reflect.Value才能进行修改操作。 - 字段可见性:Go 语言中字段的首字母大小写决定了其是否可导出(Public/Private)。反射可以访问到未导出的字段,但
CanSet()仍然会返回false,你无法修改它们。
理解这些细节,能让你在实际使用 FieldByIndex 时更加得心应手,避免一些不必要的运行时错误。
除了FieldByIndex,还有哪些方法可以获取嵌套字段?它们有何不同?
除了 FieldByIndex,Go 语言的反射机制还提供了其他一些方法来获取结构体字段,它们各有侧重,适用于不同的场景。
reflect.Value.FieldByName(name string)这是最常用的方法,通过字段的名称来获取reflect.Value。- 优点:直观,易于理解和使用,特别是当你只需要访问顶层字段时。它还能自动处理匿名嵌入结构体的字段提升(promoted fields)。例如,如果
Employee匿名嵌入了Location,并且Location有City字段,你可以直接empValue.FieldByName("City")来获取City字段。 - 缺点:对于深层嵌套的字段,你需要链式调用
FieldByName,比如empValue.FieldByName("Details").FieldByName("Location").FieldByName("City")。这会涉及多次字符串查找,在性能敏感的场景下可能不如FieldByIndex。而且,如果存在同名字段(通过不同路径提升),可能会导致混淆。
- 优点:直观,易于理解和使用,特别是当你只需要访问顶层字段时。它还能自动处理匿名嵌入结构体的字段提升(promoted fields)。例如,如果
reflect.Value.FieldByNameFunc(match func(string) bool)这个方法允许你传入一个函数来匹配字段名。- 优点:提供了更大的灵活性,可以根据自定义的匹配规则来查找字段。例如,你可以查找所有以特定前缀开头的字段。
- 缺点:通常用于更复杂的、非直接的字段查找需求,对于简单的嵌套字段访问,不如
FieldByIndex或FieldByName直观。
手动遍历
reflect.Type或reflect.Value你可以通过reflect.Type.NumField()和reflect.Type.Field(i)来遍历结构体的所有字段信息,或者通过reflect.Value.NumField()和reflect.Value.Field(i)来遍历字段的reflect.Value。- 优点:提供了最底层的控制,你可以完全自定义遍历逻辑,例如递归地查找所有嵌套字段。
- 缺点:代码会比较冗长,需要手动处理层级关系和类型检查。
FieldByIndex实际上就是对这种手动遍历的封装和优化。
总结选择:
FieldByIndex:当你明确知道字段的层级和顺序时,或者需要高性能、无歧义地访问深层嵌套字段时,它是首选。特别适合于在编译时就能确定访问路径的场景。FieldByName:当你只需要访问顶层字段,或者字段名是动态传入的,且不需要处理复杂的同名提升问题时,它更方便。对于一般应用,其性能开销通常可以忽略。FieldByNameFunc和手动遍历:适用于更高级、更定制化的反射需求,例如构建通用ORM、序列化/反序列化工具等。
实际开发中,我通常会根据具体需求来选择。如果路径固定且深,我会倾向于 FieldByIndex;如果只是偶尔访问一两个字段,或者字段名是动态的,FieldByName 会更简洁。
Docker容器创建后无法启动或立即退出?本文详解如何通过docker logs查看报错、检查端口占用及修正配置文件,助你快速解决容器启动难题。
多张JPG快速转PDF可使用PDF.cn批量上传、系统打印或手机文件功能;图片尺寸不一致时,应先统一方向、纸张和适配方式,再决定留白或裁切,避免导出后页面忽大忽小、主体被截断和文件体积过大。转换前后还要核对图片顺序、页面边缘和打印清晰度。便于减少误操作和重复返工。
面向希望提升照片局部光影自然度的摄影后期用户,解决直接应用全局效果或普通蒙版导致边缘生硬、过渡不自然的痛点。本文基于Luminar Neo软件,解析线性与径向渐变滤镜的遮罩原理,演示如何通过“开发”工具中的曝光、曲线及颜色调整功能,配合径向渐变遮罩实现人物主体突出、背景压暗或色彩反差等渐变亮度调节效果,帮助读者掌握更细腻的局部修图技巧。
面向Luminar Neo新手用户,解决快速风格化修图与人像细节调整的难题。本文详解如何调用智能推荐预设、预览并应用效果,以及如何将微调后的参数保存为自定义预设。针对液化需求,介绍如何利用“脸AI”和“身体AI”工具自动实现瘦脸、放大眼睛及身材塑造,替代传统手动液化操作,获得更自然的人像修饰效果。
针对 SQL 初学者的分组统计实战指南。深入解析 GROUP BY 分组机制、WHERE 与 HAVING 的执行时机差异,以及 COUNT 函数对 NULL 值的处理逻辑。通过具体代码示例演示如何正确筛选聚合结果,并排查因 JOIN 连接导致的统计数据异常,提升报表准确性。
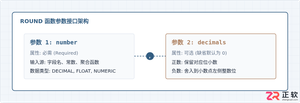
详细讲解SQL中ROUND函数的语法定义、小数位参数控制逻辑、正负数舍入规则与截断差异,包含完整的SQL代码示例与结构化图解。
面向使用Luminar Neo进行风景后期处理的摄影爱好者,解决阴天天空灰暗及彩虹色彩模糊的常见痛点。本文详解利用Sky AI功能智能替换并优化蓝天色调的操作步骤,以及结合风景预设、结构增强、HSL分色调整与去雾工具,精准提升彩虹清晰度与饱和度的具体方法,帮助用户快速获得通透自然的风景大片。
PDF 加密或受限无法编辑打印?教你合法解除 PDF 密码与权限保护!涵盖 PDF.cn 在线解锁、已知密码离线移除及源文件找回技巧,快速恢复文件编辑与打印权限!
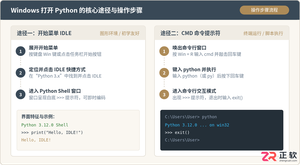
详细讲解在Windows操作系统中打开Python的两种核心方式:通过开始菜单启动自带的IDLE集成开发环境,以及通过CMD命令提示符启动Python解释器,并提供环境变量排查与退出操作指南。




AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

AnyDesk macOS版是一款适用于远程办公、设备维护和客户支持的远程桌面工具,可连接并操作异地计算机,支持文件传输、无人值守访问、会话权限控制及跨平台协作。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。


