

新标题:英伟达H200发布:HBM容量提升76%,大幅提升大模型性能90%的最强AI芯片
11月14日消息,英伟达(Nvidia)在当地时间13日上午的“Supercomputing23”会议上正式发布了全新的H200GPU,并更新了GH200产品线其中,H200依然是建立在现有的HopperH100架构之上,但增加了更多高带宽内存(HBM3e),从而更好地处理开发和实施人工智能所需的大型数据集,使得运行大模型的综合性能相比前代H100提升了60%到90%。而更新后的GH200,也将为下一代AI超级计算机提供动力。2024年将会有超过200exaflops的AI计算能力上线。H200:HBM容
11月14日消息,英伟达(Nvidia)在当地时间13日上午的“Supercomputing 23”会议上正式发布了全新的H200 GPU,并更新了GH200产品线
其中,H200依然是建立在现有的 Hopper H100 架构之上,但增加了更多高带宽内存(HBM3e),从而更好地处理开发和实施人工智能所需的大型数据集,使得运行大模型的综合性能相比前代H100提升了60%到90%。而更新后的GH200,也将为下一代 AI 超级计算机提供动力。2024 年将会有超过 200 exaflops 的 AI 计算能力上线。
H200:HBM容量增加了76%,大型模型的性能提升了90%
具体来说,全新的H200提供了高达141GB的HBM3e内存,有效运行速度约为6.25 Gbps,六个HBM3e堆栈中每个GPU的总带宽为4.8 TB/s。与上一代的H100(具有80GB HBM3和3.35 TB/s带宽)相比,这是一个巨大的改进,HBM容量提升了超过76%。根据官方提供的数据,在运行大模型时,H200相比H100将带来60%(GPT3 175B)到90%(Llama 2 70B)的提升
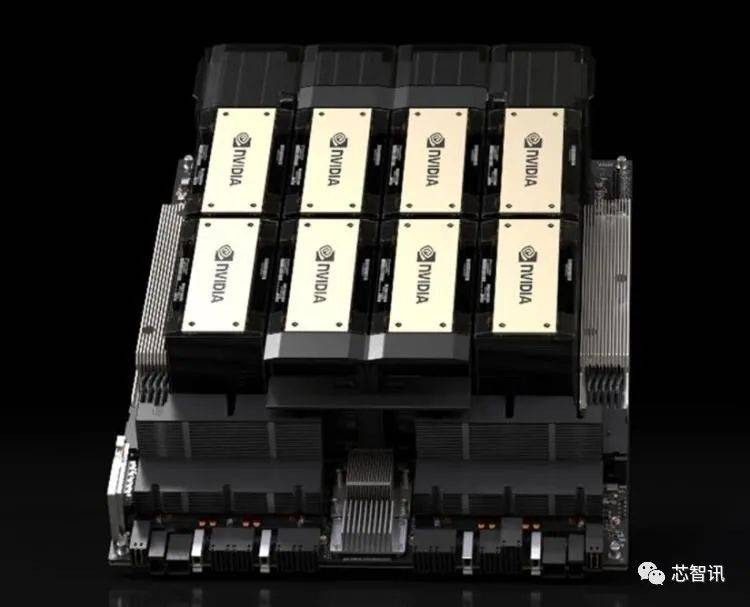
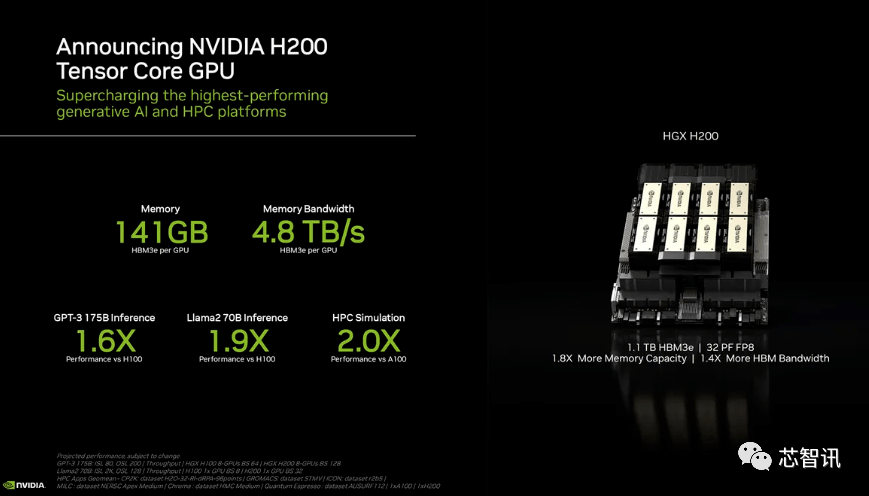
虽然H100 的某些配置确实提供了更多内存,例如 H100 NVL 将两块板配对,并提供总计 188GB 内存(每个 GPU 94GB),但即便是与 H100 SXM 变体相比,新的 H200 SXM 也提供了 76% 以上的内存容量和 43 % 更多带宽。
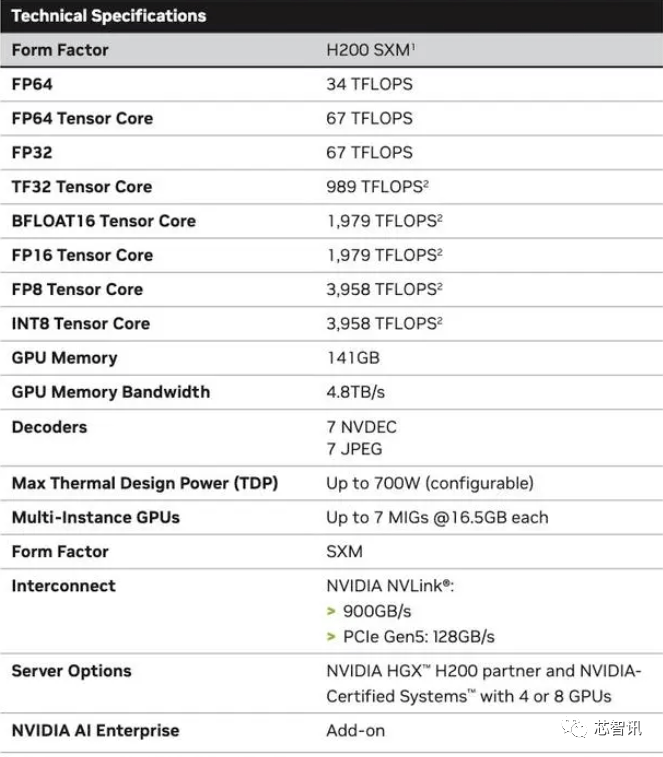
需要指出的是,H200原始计算性能似乎没有太大变化。英伟达展示的唯一体现计算性能的幻灯片是基于使用了8个GPU的HGX 200配置,总性能为“32 PFLOPS FP8”。而最初的H100提供了3,958 teraflops的FP8算力,因此八个这样的GPU也提供了大约32 PFLOPS的FP8算力
更高带宽内存带来的提升取决于工作量。大型模型(如GPT-3)将极大受益于HBM内存容量的增加。据英伟达表示,H200在运行GPT-3时的性能将比原始A100高出18倍,比H100快大约11倍。此外,即将推出的Blackwell B100的预告片显示,它包含一个逐渐变黑的更高条,大约是H200的两倍最右
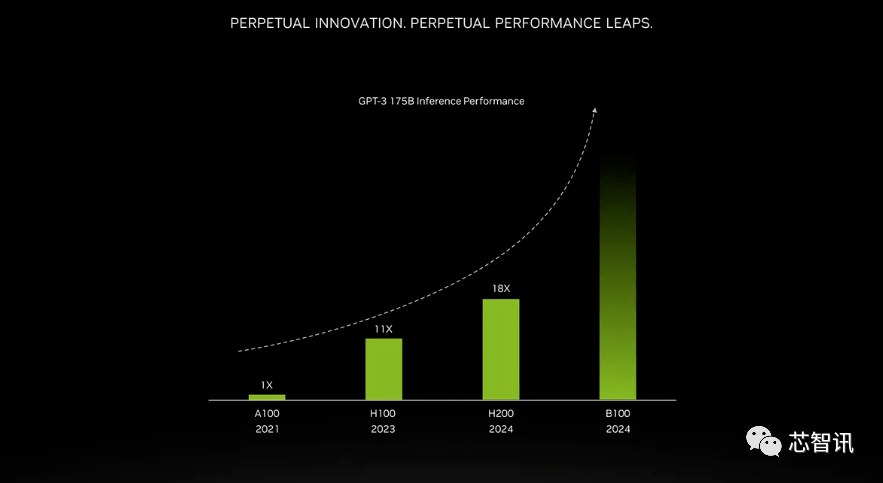
不仅如此,H200和H100是互相兼容的。也就是说,使用H100训练/推理模型的AI企业,可以无缝更换成最新的H200芯片。云端服务商将H200新增到产品组合时也不需要进行任何修改。
英伟达表示,通过推出新产品,他们希望跟上用于创建人工智能模型和服务的数据集规模的增长。增强的内存能力将使H200在向软件提供数据的过程中更快速,这个过程有助于训练人工智能执行识别图像和语音等任务。
“整合更快、更大容量的HBM內存有助于对运算要求较高的任务提升性能,包括生成式AI模型和高效能运算应用程序,同时优化GPU使用率和效率”,NVIDIA高性能计算产品副总裁Ian Buck表示。
英伟达数据中心产品负责人迪翁·哈里斯(Dion Harris)表示:“当你观察市场发展的趋势时,会发现模型规模正在迅速增大。这是我们持续引入最新和最优秀技术的典范。”
预计大型计算机制造商和云服务提供商将于2024年第二季度开始使用H200。英伟达服务器制造伙伴(包括永擎、华硕、戴尔、Eviden、技嘉、HPE、鸿佰、联想、云达、美超威、纬创资通以及纬颖科技)可以使用H200更新现有系统,而亚马逊、Google、微软、甲骨文等将成为首批采用H200的云端服务商。
鉴于目前市场对于英伟达AI芯片的旺盛需求,以及全新的H200增加了更多的昂贵的HBM3e内存,因此H200的价格肯定会更昂贵。英伟达没有列出它的价格,但上一代H100价格就已经高达25,000美元至40,000美元。
英伟达发言人Kristin Uchiyama表示,最终的定价将由英伟达的制造伙伴来确定
对于H200的推出是否会影响H100的生产,Kristin Uchiyama表示:“我们预计全年的总供应量将会增加。”
英伟达的高端AI芯片一直以来被视为处理大量数据和训练大型语言模型、AI生成工具的最佳选择。然而,在推出H200芯片之时,AI公司仍在市场上拼命寻求A100/H100芯片。市场关注的焦点仍然在于,英伟达是否能够提供足够多的供应来满足市场需求。因此,H200芯片是否会像H100芯片一样供不应求,NVIDIA并没有给出答案
不过,明年对GPU买家来说可能将是一个更有利时期,据《金融时报》8月报导曾指出,NVIDIA计划在2024年将H100产量提升三倍,产量目标将从2023年约50万个增加至2024年200万个。但生成式AI仍在蓬勃发展,未来需求也可能会更大。
举个例子,最新推出的GPT-4大约是在10000-25000块A100上进行训练的。Meta的AI大模型需要大约21000块A100进行训练。Stability AI使用了大约5000块A100。Falcon-40B的训练则需要384块A100
根据马斯克的说法,GPT-5可能需要30000-50000块H100。摩根士丹利的说法是25000个GPU。
Sam Altman否认了在训练GPT-5,但却提过“OpenAI的GPU严重短缺,使用我们产品的人越少越好”。
当然,除了英伟达之外,AMD和英特尔也在积极的进入AI市场与英伟达展开竞争。此前AMD推出的MI300X就配备192GB的HBM3和5.2TB/s的显存带宽,这将使其在容量和带宽上远超H200。
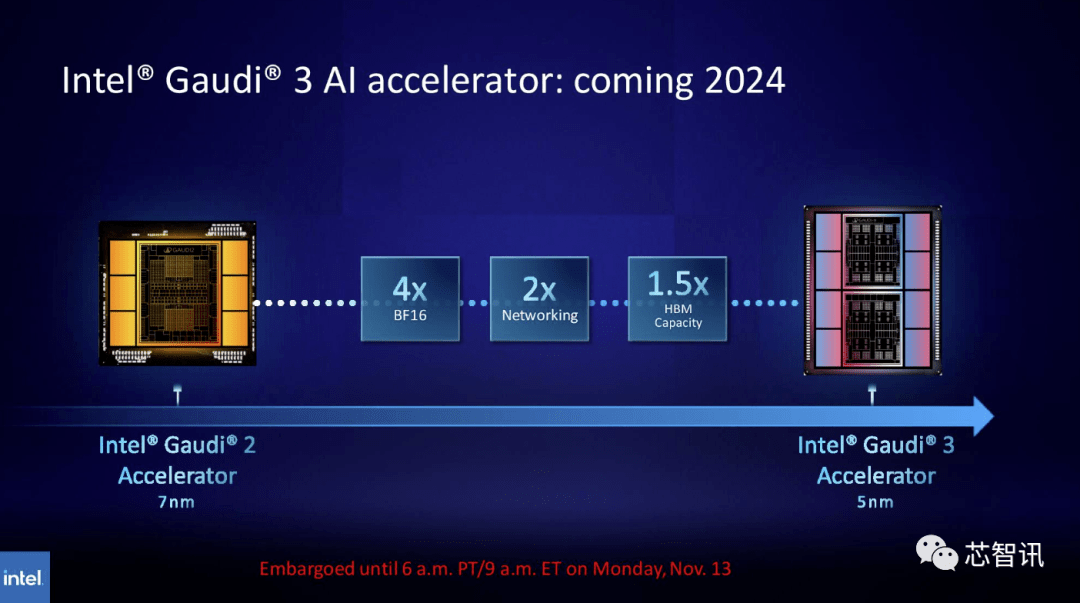
同样,英特尔计划提升Gaudi AI芯片的HBM容量。根据最新公布的信息显示,Gaudi 3采用5nm工艺,其在BF16工作负载方面的性能将是Gaudi 2的四倍,网络性能也将是其的两倍(Gaudi 2有24个内置的100 GbE RoCE Nic)。此外,Gaudi 3的HBM容量是Gaudi 2的1.5倍(Gaudi 2有96 GB的HBM2E)。从下图可以看出,Gaudi 3采用了基于chiplet的设计,具有两个计算集群,而不像Gaudi 2使用英特尔的单芯片解决方案
全新GH200超级芯片:为下一代 AI 超级计算机提供动力
英伟达除了发布全新的H200 GPU外,还推出了升级版的GH200超级芯片。这款芯片采用了NVIDIA NVLink-C2C芯片互连技术,结合了最新的H200 GPU和Grace CPU(不确定是否为升级版)。每个GH200超级芯片还将搭载总计624GB的内存
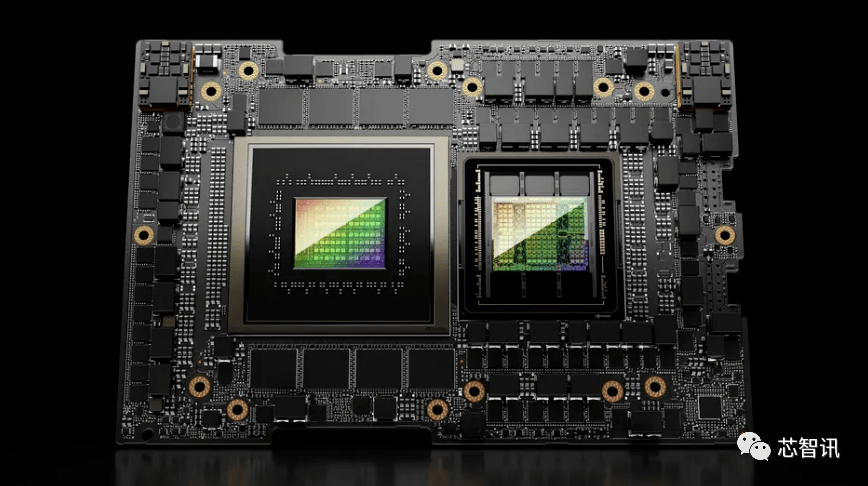
作为对比,上一代的GH200则是基于H100 GPU和 72 核的Grace CPU,提供了96GB 的 HBM3 和 512 GB 的 LPDDR5X 集成在同一个封装中。
虽然英伟达并未介绍GH200超级芯片当中的Grace CPU细节,但是英伟达提供了GH200 和“现代双路 x86 CPU”之间的一些比较。可以看到,GH200带来了ICON性能8倍的提升,MILC、Quantum Fourier Transform、RAG LLM Inference等更是带来数十倍乃至百倍的提升。
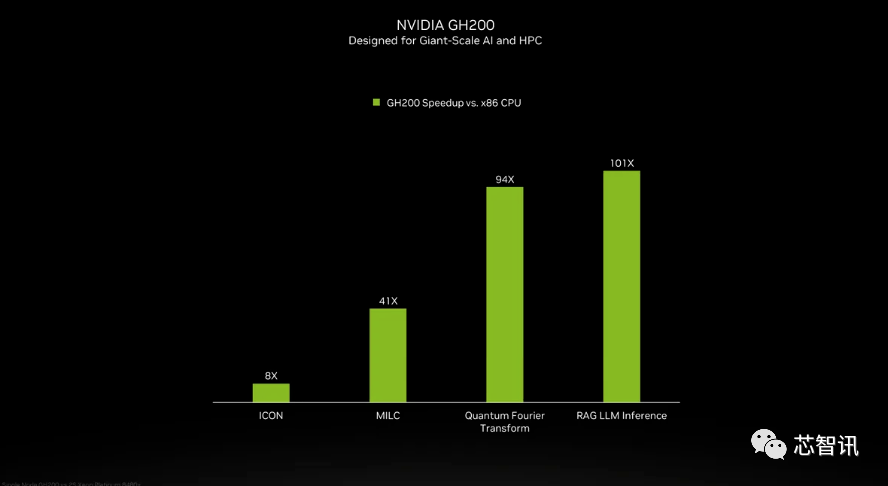
但需要指出的是,其中提到了加速与“非加速系统”。这意味着什么?我们只能假设 x86 服务器运行的是未完全优化的代码,特别是考虑到人工智能世界正在快速发展,并且优化方面似乎定期出现新的进展。
全新的GH200 还将用于新的 HGX H200 系统。据说这些与现有的 HGX H100 系统“无缝兼容”,这意味着 HGX H200 可以在相同的安装中使用,以提高性能和内存容量,而无需重新设计基础设施。
据介绍,瑞士国家超级计算中心的阿尔卑斯超级计算机可能是明年第一批投入使用的基于GH100的Grace Hopper超级计算机之一。第一个在美国投入使用的GH200系统将是洛斯阿拉莫斯国家实验室的Venado超级计算机。德克萨斯高级计算中心(TACC) Vista系统同样将使用刚刚宣布的Grace CPU和Grace Hopper超级芯片,但尚不清楚它们是基于H100还是H200
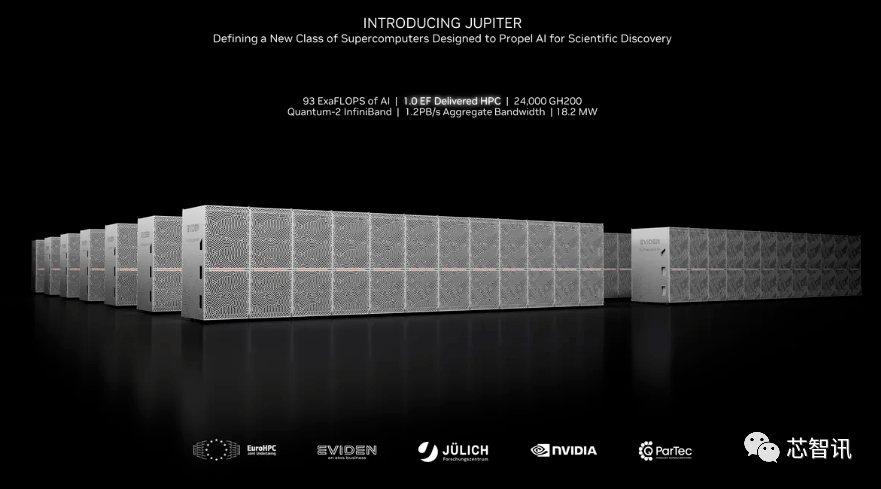
目前,即将安装的最大的超级计算机是Jϋlich超级计算中心的Jupiter 超级计算机。它将容纳“近”24000 个 GH200 超级芯片,总共 93 exaflops 的 AI 计算(大概是使用 FP8,虽然大多数 AI 仍然使用 BF16 或 FP16)。它还将提供 1 exaflop 的传统 FP64 计算。它将使用具有四个 GH200 超级芯片的“Quad GH200”板。
英伟达预计在未来一年左右安装的这些新型超级计算机,总体来说,将实现超过200 exaflops的人工智能计算能力
不需要改变原始意思的情况下,需要将内容改写成中文,不需要出现原句
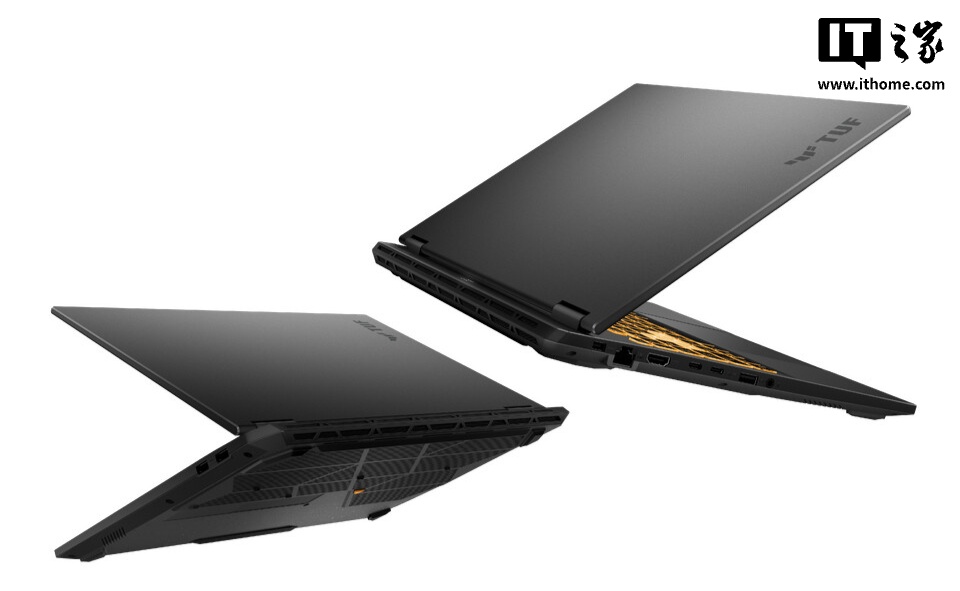
华硕2026款TUF Gaming系列游戏本海外亮相,RTX 5070 Ti显卡登场 3月17日,华硕在海外市场正式发布了2026款TUF Gaming系列游戏本,包括A16、F16和A18三款型号。这一系列专为电竞玩家打造,其中最引人注目的当属最高可选的英伟达RTX 5070 Ti显卡配置。 下面
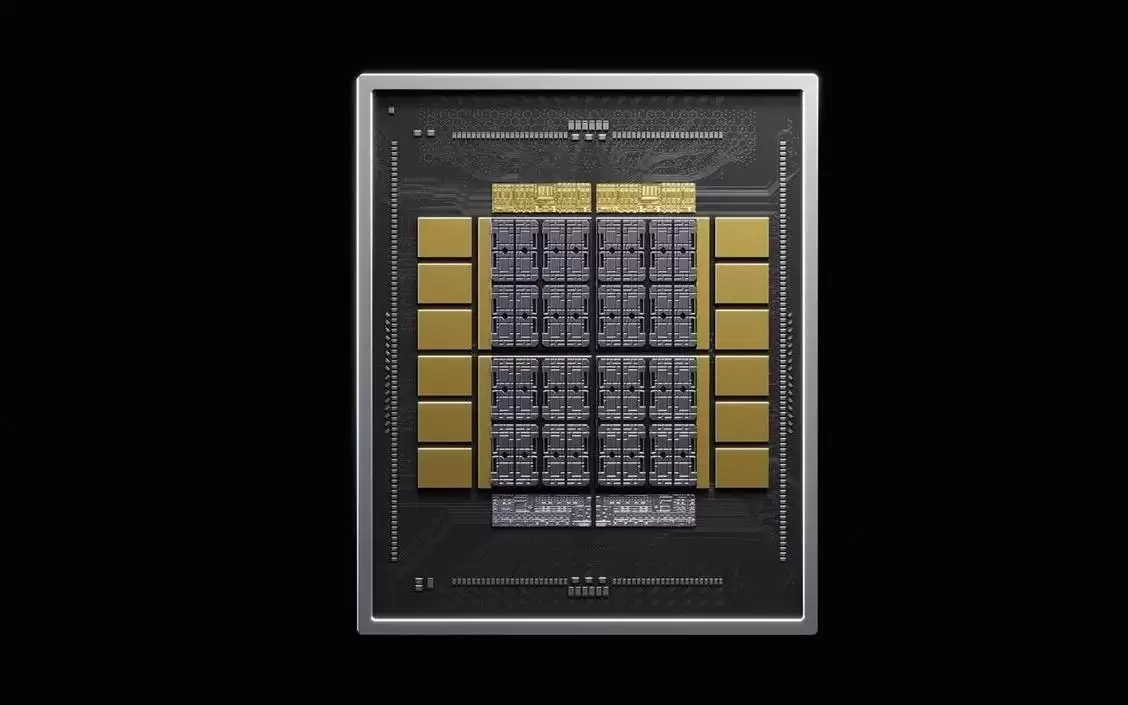
英伟达发布定制HBM技术NVHBM,通过集成内存控制器至HBM基础裸片,实现带宽较HBM4E提升30%、功耗降低15%,并释放主芯片25%空间。亚马逊Annapurna Labs为首个合作伙伴,该技术旨在通过标准化方案加速定制AI芯片开发,而非取代通用HBM。
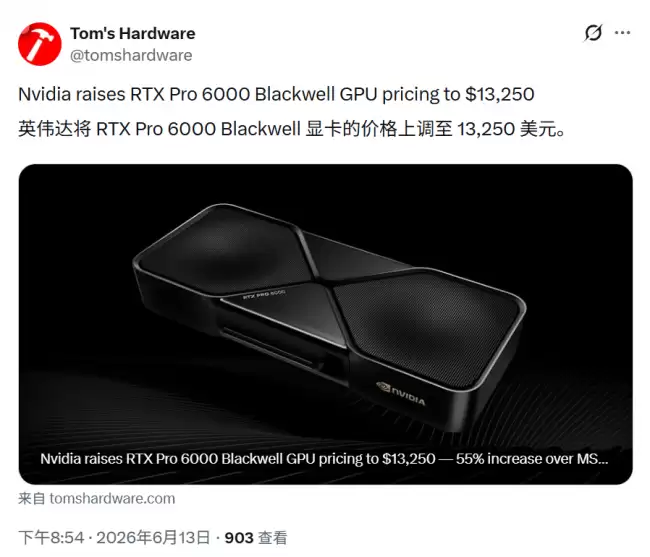
英伟达RTXPRO6000Blackwell官方标价升至13250美元,较首发价8565美元上涨55%。受显存市场紧绷及AI需求升温影响,专业显卡价格持续走高,折射出高端GPU市场供需格局演变。
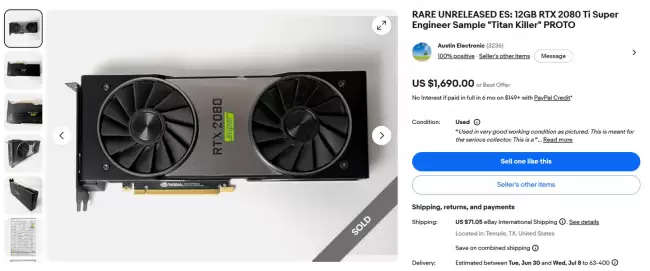
英伟达未发布的RTX2080TiSUPER工程样品现身eBay,配备4608个CUDA核心、12GB显存及384-bit位宽,规格接近TitanRTX。该卡因性能与定价内斗被取消,需在测试模式下修改驱动方可使用。
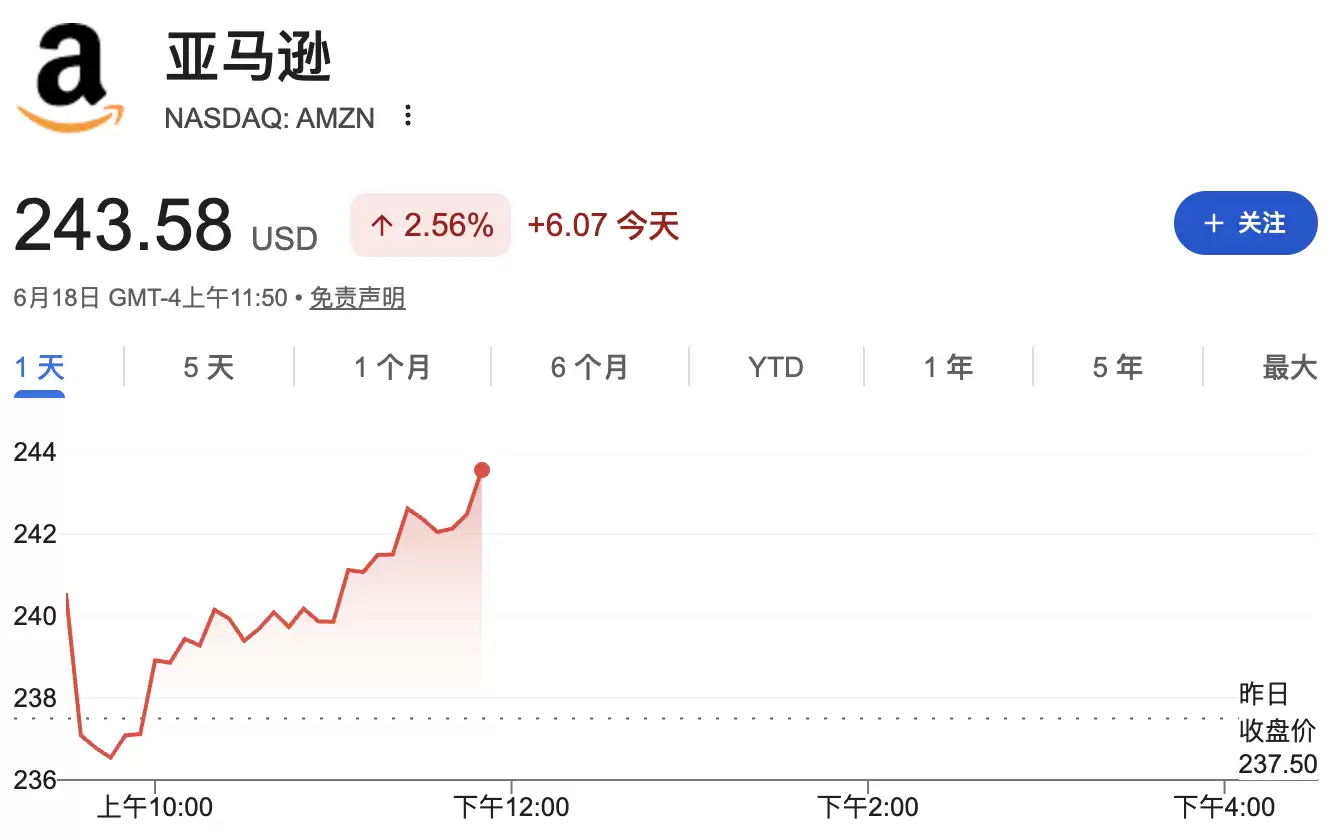
亚马逊计划将自研AI芯片Trainium对外销售,直接挑战英伟达市场主导地位。第三代芯片已售罄,第四代明年发布,累计收入承诺超2250亿美元。欧洲主权计算需求驱动战略转向,同时自研处理器Graviton已向Meta供应。
近日,LG旗下多家子公司高管将集体访问英伟达总部,探讨实体人工智能与机器人领域合作。此前董事长已与黄仁勋会面。此消息推动LG电子、LGCNS等公司股价出现上涨。
诺基亚与英伟达合作开发AI6G网络,推动AI芯片从数据中心向电信基础设施渗透。6G算力需求增长,GPU等AI芯片成为核心组件,国产AI芯片企业迎来国产替代窗口,寒武纪、海光信息等持续突破。
近日,高通宣布微软和Meta将采用其人工智能芯片。微软选用基于平价内存的高带宽计算芯片,Meta选用自研处理器DragonflyC1000芯片。另有未具名云厂商正合作开发定制化芯片,意图冲击英伟达市场,挑战其主导地位。
高通公司向微软和Meta供应其最新一代AI芯片。微软采用了高带宽计算架构,使用了普通内存替代昂贵的HBM(高带宽内存);Meta则选用了自研CPUDragonflyC1000;此外还有两家尚未公开的超大规模云厂商正在等待其定制化芯片。
瑞芯微推出面向具身智能的旗舰AIoT芯片RK3588,采用新思科技全流程EDA工具与IP,实现高性能与低功耗突破。该芯片已在服务机器人、工业自动化等领域成功落地,推动端侧AI芯片创新,为具身智能提供强大算力支持。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



