

Java爬虫核心技术解析:从初级到高级的全面指南
从入门到精通:Java爬虫的核心技术全面解析导言:随着互联网的不断发展,人们对于网络信息的获取需求也越来越高。而爬虫技术的出现,为人们提供了一种便捷、高效地从互联网上获取大量信息的方式。Java作为一门功能强大的编程语言,也有着许多优秀的爬虫框架和库,为开发人员提供了丰富的工具。本文将从零开始,详细介绍Java爬虫的核心技术,包括网页请求、网页解析、数据存储
从入门到精通:Java爬虫的核心技术全面解析
导言:
随着互联网的不断发展,人们对于网络信息的获取需求也越来越高。而爬虫技术的出现,为人们提供了一种便捷、高效地从互联网上获取大量信息的方式。Java作为一门功能强大的编程语言,也有着许多优秀的爬虫框架和库,为开发人员提供了丰富的工具。
本文将从零开始,详细介绍Java爬虫的核心技术,包括网页请求、网页解析、数据存储等方面。同时,将提供具体的代码示例,帮助读者深入理解每个环节的实现原理以及如何应用到实际项目中。
一、网页请求
爬虫的第一步是向目标网站发送请求,获取网页内容。Java中,我们可以使用 HttpClient 或者 Jsoup 来实现网页请求的功能。
1.1 HttpClient
HttpClient 是一个HTTP客户端库,可以模拟浏览器发送请求。以下是一个使用 HttpClient 获取网页内容的示例代码:
// 创建 HttpClient 对象
CloseableHttpClient httpClient = HttpClients.createDefault();

// 创建 HttpGet 对象
HttpGet httpGet = new HttpGet("http://www.example.com");

// 发送 GET 请求
CloseableHttpResponse response = httpClient.execute(httpGet);

// 获取响应内容
String html = EntityUtils.toString(response.getEntity(), "UTF-8");

// 关闭 HttpClient 和响应对象
response.close();
httpClient.close();
通过上述代码,我们可以使用 HttpClient 发送 GET 请求,并获取响应的 HTML 内容。
1.2 Jsoup
Jsoup 是一个用于处理 HTML 文档的 Java 库,它提供了类似于 jQuery 的 CSS 选择器语法,方便我们从 HTML 中提取需要的信息。以下是一个使用 Jsoup 获取网页内容的示例代码:
// 发送 GET 请求,获取 Document 对象
Document doc = Jsoup.connect("http://www.example.com").get();

// 通过 CSS 选择器提取需要的信息
Element titleElement = doc.select("title").first();
String title = titleElement.text();
通过上述代码,我们可以使用 Jsoup 发送 GET 请求,并通过 CSS 选择器提取需要的信息,如标题、链接等。
二、网页解析
获取到网页内容后,下一步是对网页进行解析,提取需要的信息。Java中,常用的网页解析库有 Jsoup 和 XPath。
2.1 Jsoup
在前面的代码示例中,我们已经使用了 Jsoup 的一部分功能进行了网页的解析操作。Jsoup 提供了丰富的API,可以帮助我们高效地解析 HTML 文档。
以下是一个使用 Jsoup 解析 HTML 的示例代码:
// 解析 HTML 字符串
Document doc = Jsoup.parse(html);

// 通过标签名提取需要的信息
Elements elements = doc.getElementsByTag("a");
for (Element element : elements) {
    String href = element.attr("href");
    String text = element.text();
    System.out.println(href + " - " + text);
}
通过上述代码,我们可以使用 Jsoup 解析 HTML 字符串,然后通过标签名提取需要的信息。
2.2 XPath
XPath 是一种在 XML 文档中定位节点的语言,但它同样适用于 HTML 文档。通过 XPath,我们可以更加精确地定位网页中的元素。Java中,可以使用 jsoup-xpath 这个三方库来实现 XPath 解析。
以下是一个使用 jsoup-xpath 解析 HTML 的示例代码:
// 解析 HTML 字符串
Document doc = Jsoup.parse(html);

// 使用 XPath 定位元素
XPath xpath = XPathFactory.newInstance().newXPath();
XPathExpression expr = xpath.compile("//a[contains(text(),'click here')]");
NodeList nodeList = (NodeList) expr.evaluate(doc, XPathConstants.NODESET);

// 遍历节点列表,提取需要的信息
for (int i = 0; i < nodeList.getLength(); i++) {
    Node node = nodeList.item(i);
    String href = node.getAttributes().getNamedItem("href").getNodeValue();
    String text = node.getTextContent();
    System.out.println(href + " - " + text);
}
通过上述代码,我们可以使用 jsoup-xpath 解析 HTML 字符串,并通过 XPath 表达式定位元素,然后提取需要的信息。
三、数据存储
爬虫获取到的数据通常需要进行存储,以备后续分析或展示。Java中,可以使用多种方式来存储爬取到的数据,如文本文件、数据库、Excel等。
3.1 文本文件
将数据存储到文本文件是最简单的方式之一。Java中,可以使用 FileWriter 或者 BufferedWriter 来操作文件,将数据写入到指定的文件中。
以下是一个使用 BufferedWriter 将数据存储到文本文件的示例代码:
// 创建 BufferedWriter 对象
BufferedWriter writer = new BufferedWriter(new FileWriter("data.txt"));

// 写入数据
writer.write("Data 1");
writer.newLine();
writer.write("Data 2");

// 关闭 BufferedWriter
writer.close();
通过上述代码,我们可以将数据写入到 data.txt 文件中。
3.2 数据库
如果需要更加灵活地进行数据管理和查询,可以将数据存储到数据库中。Java中,可以使用 JDBC 来与数据库进行交互。以下是一个使用 JDBC 将数据存储到 MySQL 数据库中的示例代码:
// 加载数据库驱动
Class.forName("com.mysql.jdbc.Driver");

// 连接数据库
Connection conn = DriverManager.getConnection("jdbc:mysql://localhost:3306/test", "root", "password");

// 创建 PreparedStatement 对象
PreparedStatement ps = conn.prepareStatement("INSERT INTO data VALUES (?, ?)");

// 设置参数
ps.setString(1, "Data 1");
ps.setString(2, "Data 2");

// 执行插入操作
ps.executeUpdate();

// 关闭 PreparedStatement 和连接
ps.close();
conn.close();
通过上述代码,我们可以将数据插入到名为 test 的数据库中的 data 表中。
结语:
本文从网页请求、网页解析、数据存储等方面介绍了Java爬虫的核心技术,并提供了具体的代码示例。希望读者通过本文的学习,能够掌握Java爬虫的基本原理和实现方法,在实际项目中能够熟练运用爬虫技术,从而提高信息获取的效率和质量。
Yandex官网入口是https://www.yondex.net/,该平台支持多语言切换、智能搜索匹配、虚拟键盘变更及实时翻译,提供地图、图片、新闻、购物等垂直服务,并具备账户同步、隐私管理、个性化首页和云存储等功能。
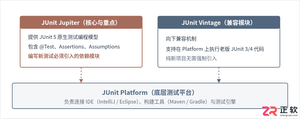
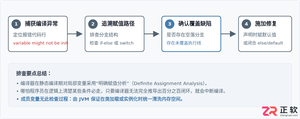
深入解析Java中局部变量未初始化编译报错与成员变量自动赋予默认值的机制差异,涵盖JVM内存分配、编译期确定性赋值检查与实际排查修复方案。
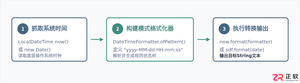
详细讲解在Java中获取当前系统时间并进行格式化输出的两种核心方案:基于Java 8全新日期时间API的DateTimeFormatter与传统遗留的SimpleDateFormat,包含完整代码示例、线程安全机制对比及生产选型建议。
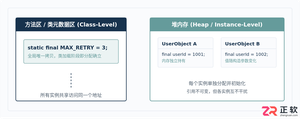
深入解析Java中final变量与static final常量的定义、内存语义、初始化时机及合法赋值路径,涵盖编译期常量优化与实战避坑指南。
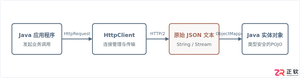
本文提供Java标准库HttpClient发起HTTP GET/POST请求并结合Jackson进行JSON数据反序列化与序列化的完整代码示例与工程实践指南。
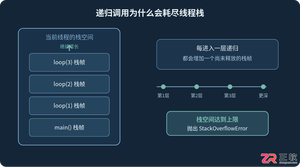
详细分析Java递归调用出现StackOverflowError的原因,结合代码说明线程栈、栈帧和递归深度之间的关系,并介绍终止条件排查、迭代改写、减少栈帧开销以及通过-Xss调整JVM栈空间的方法。
针对Java中常见的NullPointerException(NPE),本文从堆栈日志定位、典型代码触发场景、具体修复代码对比到防御体系进行系统讲解,提供实用且易上手的排查与修复方案。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



