

深入探讨Python推导式的边界场景与常见错误避免指南
Python推导式在提升代码简洁性的同时,存在嵌套变量作用域冲突、条件判断位置错误、空值处理、内存溢出等常见陷阱,需注意作用域顺序、区分过滤与映射、优先生成器并加类型检查,以确保代码正确高效。
Python推导式——列表、字典、集合推导式——是很多开发者提升代码简洁性的利器。但用不好,坑也不少。今天我们就来聊聊那些容易被忽略的边界场景和常见错误,通过大量真实代码示例,帮你从“写对”迈向“写好”。
什么是推导式?为什么它如此重要?
推导式是一种紧凑而高效的创建容器(列表、字典、集合)的方法,语法结构统一且直观:
[expression for item in iterable if condition]
比如:
squares = [x**2 for x in range(10) if x % 2 == 0]
print(squares)  # [0, 4, 16, 36, 64]
它的优势很明显:代码更简洁,减少冗余的 for 循环;执行速度通常优于等价的 for 循环;更具函数式编程风格,易读易懂。
但话说回来,任何强大工具都有它的“边界”与“陷阱”,下面我们直接进入实战。
边界场景一:嵌套推导式中的变量作用域冲突
错误案例:内层变量名与外层重复
# 错误示例:变量名冲突
matrix = [[1, 2], [3, 4], [5, 6]]
result = [x for x in row for row in matrix]  # ❌ 报错!
这段代码看似合理,实际会抛出 NameError: name 'row' is not defined。
原因分析
在嵌套推导式中,内部的 for 子句是按顺序执行的,等价于:
for row in matrix:
    for x in row:
        yield x
但因为语法书写顺序是反的(先写内层 x,再写外层 row),Python 在解析时认为 row 在 x 的作用域中已经存在,可实际上它还没绑定。
正确做法:明确作用域顺序
# 正确写法:外层变量必须先于内层出现
matrix = [[1, 2], [3, 4], [5, 6]]
result = [x for row in matrix for x in row]
print(result)  # [1, 2, 3, 4, 5, 6]
小贴士:嵌套推导式要遵循“从外到内”的顺序书写,避免变量提前引用。
可视化:嵌套推导式执行流程(Mermaid图)
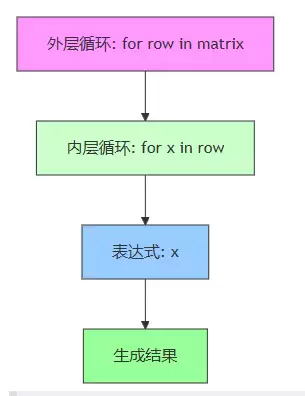
图解说明:外层变量 row 必须先绑定,才能用于内层迭代。
边界场景二:条件判断位置不当导致逻辑错误
错误案例:if条件放在表达式前
# 错误:if 放在表达式前面
numbers = [1, 2, 3, 4, 5]
result = [x if x % 2 == 0 for x in numbers]  # ❌ SyntaxError
这会直接报语法错误,因为 if 不能单独出现在表达式前,必须配合 else 构成三元表达式。
正确写法:使用三元表达式 + 条件过滤
# ✅ 正确:使用三元表达式
result = [x if x % 2 == 0 else 0 for x in numbers]
print(result)  # [0, 2, 0, 4, 0]

# ✅ 正确:用 if 过滤(非三元)
result = [x for x in numbers if x % 2 == 0]
print(result)  # [2, 4]
关键区别:
if作为过滤器:只保留满足条件的元素 →for x in ... if conditionif-else作为表达式:对每个元素进行映射 →x if cond else y
Mermaid图:推导式中条件的两种角色
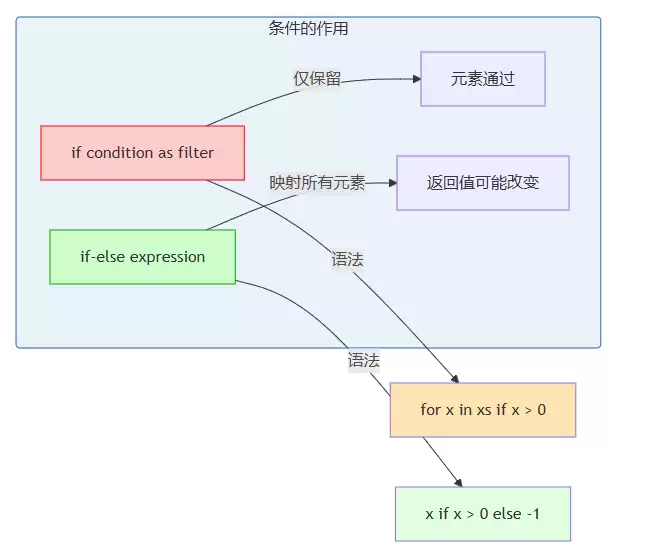
小结:不要混淆“过滤”与“映射”,这是推导式中最常见的逻辑错误之一。
边界场景三:使用未定义变量或引用外部作用域失败
错误案例:引用未定义变量
# 错误:引用了局部作用域外的变量
value = 10
result = [x + y for x in range(5) if x > 3 for y in [value, value*2]]
print(result)  # ✅ 本应正常?等等...
看起来没问题?其实这里有个隐藏陷阱:value 被引用了,但若你在函数中使用,就可能出问题。
更严重的例子:在函数中使用自由变量
def make_multiplier(n):
    return [x * n for x in range(5)]

print(make_multiplier(2))  # [0, 2, 4, 6, 8] ✅
看似正确,但如果你这样写:
def make_multipliers():
    factors = [2, 3, 5]
    return [x * f for x in range(3) for f in factors]

result = make_multipliers()
print(result)  # [0, 0, 0, 3, 6, 9, 10, 15, 20] ✅
虽然这次成功了,但如果 factors 是动态变化的呢?
def create_handlers():
    handlers = []
    for i in range(3):
        handlers.append(lambda: print(i))  # ❌ 捕获的是最后的 i
    return handlers

handlers = create_handlers()
for h in handlers:
    h()  # 打印 2, 2, 2 ❌ 不是预期的 0,1,2
这不是推导式的问题,而是闭包捕获变量的延迟绑定机制。
解决方案:使用默认参数“固化”变量
def create_handlers_fixed():
    handlers = []
    for i in range(3):
        handlers.append(lambda i=i: print(i))  # ✅ 固定当前 i
    return handlers

handlers = create_handlers_fixed()
for h in handlers:
    h()  # 打印 0, 1, 2 ✅
推导式中同样适用此原则:
# 推导式中也需注意变量捕获
factors = [2, 3, 5]
result = [x * f for f in factors for x in range(3)]
print(result)  # [0, 1, 2, 0, 2, 4, 0, 3, 6] ✅
只要 factors 在推导式执行前已定义,就不会出错。
边界场景四:空可迭代对象导致意外行为
错误案例:对空列表使用推导式,但期望有输出
empty_list = []
result = [x * 2 for x in empty_list]
print(result)  # [] ✅ 正常,但容易忽略
虽然不报错,但开发者可能误以为“应该有值”。
验证是否为空:结合or提供默认值
data = []
default_result = [x * 2 for x in data] or [0]
print(default_result)  # [0] ✅
或者更清晰地:
result = [x * 2 for x in data] if data else [0]
推荐:在处理可能为空的数据源时,主动添加默认逻辑。
结论:推导式不会抛异常,只会返回空结果。务必做空值判断。
边界场景五:性能陷阱 —— 大数据量下的推导式开销
错误案例:在大数据集上使用推导式而不考虑内存
# 危险!处理百万级数据
huge_data = range(1_000_000)
squares = [x**2 for x in huge_data]  # 占用大量内存!
即使 x**2 计算很快,但整个列表会被一次性构建,可能导致内存溢出。
正确做法:使用生成器表达式(惰性求值)
# ✅ 使用生成器表达式(推荐)
squares_gen = (x**2 for x in huge_data)

# 只在需要时才计算
for sq in squares_gen:
    if sq > 1000000:
        print(f"第一个大于100万的平方数是: {sq}")
        break
生成器表达式使用圆括号 (),而不是方括号 [],实现惰性求值。
说明:列表推导式一次性加载所有数据,生成器则按需计算,内存占用极低。
边界场景六:字符串拼接中的推导式误用
错误案例:用推导式拼接字符串
words = ['hello', 'world', 'python']
result = ''.join([w.upper() for w in words])  # ✅ 可行,但不高效
虽然能工作,但中间创建了一个临时列表 [W.UPPER()...],浪费内存。
最佳实践:直接用生成器
result = ''.join(w.upper() for w in words)  # ✅ 推荐!
print(result)  # HELLOWORLDPYTHON
关键点:join() 接受任意可迭代对象,包括生成器。
边界场景七:混合类型推导式导致类型混乱
错误案例:不同类型的混合操作
mixed = [1, '2', 3.0, '4']
# 错误:试图对字符串进行数学运算
result = [x * 2 for x in mixed]  # ❌ 有些会报错
运行时会抛出 TypeError,因为 '2' * 2 是 '22',而 3.0 * 2 是 6.0,但某些情况下如 'abc' * 2 也能运行,造成不可预测的结果。
安全做法:类型过滤 + 异常处理
from typing import Union

def safe_multiply(items: list, factor: Union[int, float]) -> list:
    result = []
    for item in items:
        try:
            if isinstance(item, (int, float)):
                result.append(item * factor)
            else:
                # 尝试转换为数字
                num = float(item)
                result.append(num * factor)
        except (ValueError, TypeError):
            continue  # 忽略无法转换的项
    return result

mixed = ['1', '2', 'abc', 3, '4.5']
print(safe_multiply(mixed, 2))  # [2.0, 4.0, 6.0, 9.0]
推荐:在不确定输入类型时,使用显式类型检查与容错机制。
实用技巧:如何写出“健壮”的推导式?
| 技巧 | 说明 |
|---|---|
| 使用生成器替代列表推导式(大数据) | 节省内存,支持惰性求值 |
| 保持变量命名清晰,避免重名 | 特别在嵌套推导式中 |
| 条件判断放对位置 | if 作过滤或 if-else 作映射 |
| 对可能为空的数据加默认值 | 如 or [] 或 or [0] |
优先使用 join() + 生成器拼接字符串 | 避免中间列表 |
| 使用类型提示和异常处理 | 提高代码健壮性 |
总结:推导式的“黄金法则”
- 作用域顺序要正确:外层变量先于内层。
- 区分过滤与映射:
if是过滤,if-else是映射。 - 避免变量名冲突:尤其在嵌套结构中。
- 警惕空值与大数:用生成器+默认值应对。
- 慎用混合类型:加类型检查与容错。
- 优先生成器:节省内存,提升性能。
最后一点忠告
推导式不是“越短越好”,而是“越清晰越有效”。一段难以理解的推导式,远不如一个清晰的 for 循环来得安全。
记住:优雅的代码 = 可读性 + 正确性 + 效率

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



