

文本数据的聚集和聚类是什么 文本数据如何进行聚合和聚类
文本数据聚类是一种无监督学习方法,用于将相似的文本归为一类。它能发现隐藏的模式和结构,适用于信息检索、文本分类和文本摘要等应用。文本数据聚类的基本思想是将文本数据集根据相似性分成多个类别或簇。每个簇包含一组具有相似单词、主题或语义的文本。聚类算法的目标是在同一簇内最大化文本的相似性,并在不同簇之间最大化文本的差异性。通过聚类,我们可以对文本数据进行有效的分类和组织,从而更好地理解和分析文本内容。以下是文本数据聚类的一般步骤:1、收集和准备数据集首先,收集需要进行聚类的文本数据集。接下来,对文本数据进行预处
文本数据聚类是一种无监督学习方法,用于将相似的文本归为一类。它能发现隐藏的模式和结构,适用于信息检索、文本分类和文本摘要等应用。
文本数据聚类的基本思想是将文本数据集根据相似性分成多个类别或簇。每个簇包含一组具有相似单词、主题或语义的文本。聚类算法的目标是在同一簇内最大化文本的相似性,并在不同簇之间最大化文本的差异性。通过聚类,我们可以对文本数据进行有效的分类和组织,从而更好地理解和分析文本内容。
以下是文本数据聚类的一般步骤:
1、收集和准备数据集
首先,收集需要进行聚类的文本数据集。接下来,对文本数据进行预处理和清理,包括去除不必要的标点符号、停用词、数字和特殊字符,并将所有单词转换为小写形式。
2、特征提取
接下来,需要将文本数据转换为可以被聚类算法处理的向量表示。常用的技术包括词袋模型(Bag-of-Words)和词向量(Word Embedding)。词袋模型将每个文本表示为一个词频向量,其中向量的每个元素表示一个词在文本中出现的次数。词向量是一种将单词映射到低维向量空间的技术,通常使用深度学习方法训练。
3、选择聚类算法
选择合适的聚类算法是聚类任务中的关键步骤之一。聚类算法的选择通常基于数据集的大小,性质和目标。常用的聚类算法包括K均值聚类,层次聚类,密度聚类,谱聚类等。
4、确定聚类数量
在开始聚类之前,需要确定应该将文本数据集分成多少个簇。这通常是一项具有挑战性的任务,因为类别的数量可能是未知的。常用的方法包括肘部法和轮廓系数法。
5、应用聚类算法
一旦选择了合适的聚类算法和聚类数量,可以将算法应用于文本数据集并生成聚类。聚类算法会迭代地将文本分配到不同的簇中,直到达到停止准则或最大迭代次数为止。
6、评估聚类效果
最后,需要评估聚类效果以确定聚类算法的质量。常用的评估指标包括聚类纯度,聚类准确性,F-measure等。这些指标可以帮助确定聚类是否是正确的,并且是否有必要进行改进。
需要注意的是,文本数据聚类是一种重要的数据挖掘和信息检索技术,涉及到多种聚类算法。不同的聚类算法有不同的优缺点和适用范围,需要结合具体的应用场景来选择合适的算法。
在文本数据聚类中,常用的聚类算法包括K均值聚类,层次聚类,密度聚类,谱聚类等。
1、K均值聚类
K均值聚类是一种基于距离的聚类算法,它将文本数据集划分为K个簇,使得同一簇内的文本距离最小化。这种算法的主要思想是首先选择K个随机中心点,然后迭代地将每个文本分配到最近的中心点,并更新中心点以最小化簇内平均距离。该算法通常需要指定簇的数量,因此需要使用评估指标来确定最佳的簇数量。
2、层次聚类
层次聚类是一种基于相似性的聚类算法,它将文本数据集划分为一系列嵌套的簇。该算法的主要思想是首先将每个文本作为一个簇,然后迭代地将这些簇合并成更大的簇,直到达到预定的停止条件。层次聚类算法有两种类型:凝聚层次聚类和分裂层次聚类。在凝聚层次聚类中,每个文本开始都是一个单独的簇,然后将最相似的簇合并成一个新的簇,直到所有文本都属于同一个簇。在分裂层次聚类中,每个文本开始都属于一个大的簇,然后将这个大簇分成更小的簇,直到达到预定的停止条件。
3、密度聚类
密度聚类是一种基于密度的聚类算法,它可以发现具有任意形状的簇。该算法的主要思想是将文本数据集分成不同的密度区域,每个密度区域内的文本被视为一个簇。密度聚类算法使用密度可达性和密度相连性来定义簇。密度可达性表示文本之间的距离小于一定的密度阈值,而密度相连性表示文本之间可以通过一系列密度可达的文本到达彼此。
4、谱聚类
谱聚类是一种基于图论的聚类算法,它使用谱分解方法将文本数据集转换为低维特征空间,然后在该空间中进行聚类。该算法的主要思想是将文本数据集看作是一个图,其中每个文本是一个节点,节点之间的边表示文本之间的相似性。然后,使用谱分解方法将图转换为低维特征空间,并在该空间中使用K均值聚类或其他聚类算法进行聚类。相对于其他聚类算法,谱聚类可以发现具有任意形状的簇,并且对噪声和异常值的容忍度较高。
总之,文本数据聚类是一种将文本数据集中的相似文本归为一类的技术。它是一种重要的数据挖掘和信息检索技术,可用于许多应用程序。文本数据聚类的步骤包括收集和准备数据集,特征提取,选择聚类算法,确定聚类数量,应用聚类算法和评估聚类效果。

机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
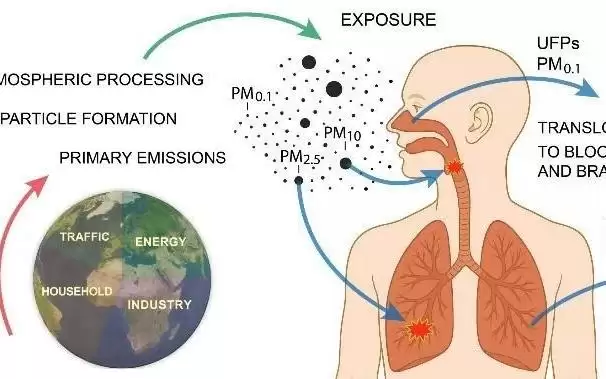
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化
机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。
少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



