

简单运用pandas函数,轻松处理大数据量
掌握pandas库常用函数,轻松处理大数据,需要具体代码示例随着大数据时代的到来,数据处理变得越来越重要,而pandas库作为Python中最常用的数据处理库之一,其强大的功能和灵活的处理方式受到了广大数据分析师和科学家的喜爱。本文将介绍pandas库中一些常用的函数,同时提供具体的代码示例,帮助读者快速上手并轻松处理大数据。数据读取与写入pandas提供了
掌握pandas库常用函数,轻松处理大数据,需要具体代码示例
随着大数据时代的到来,数据处理变得越来越重要,而pandas库作为Python中最常用的数据处理库之一,其强大的功能和灵活的处理方式受到了广大数据分析师和科学家的喜爱。本文将介绍pandas库中一些常用的函数,同时提供具体的代码示例,帮助读者快速上手并轻松处理大数据。
- 数据读取与写入
pandas提供了多种读取数据的方式,最常用的是读取csv文件。使用pandas.read_csv()函数可以直接将csv文件读取为一个DataFrame对象。
import pandas as pd

# 读取csv文件
data = pd.read_csv('data.csv')同样地,我们可以使用pandas.DataFrame.to_csv()函数将DataFrame对象写入到csv文件。
# 将DataFrame对象写入csv文件
data.to_csv('result.csv', index=False)- 查看数据
在处理大数据时,首先需要了解数据的整体情况。pandas提供了几个常用的函数,可以帮助我们查看数据的前几行、后几行以及整体的统计摘要信息。
head()函数可以查看DataFrame的前几行,默认显示前5行。
# 查看前5行数据
print(data.head())
tail()函数可以查看DataFrame的后几行,默认显示后5行。
# 查看后5行数据
print(data.tail())
describe()函数可以查看DataFrame的统计摘要信息,包括计数、平均值、标准差、最小值、最大值等。
# 查看统计摘要信息
print(data.describe())
- 数据筛选与过滤
在处理大数据时,我们常常需要根据特定条件对数据进行筛选与过滤。pandas提供了多个常用的函数,可以帮助我们实现这一功能。
- 使用
loc[]函数可以通过标签筛选数据。
# 筛选某一列中值大于10的数据
filtered_data = data.loc[data['column'] > 10]
- 使用
isin()函数可以根据一个列表中的值进行筛选。
# 筛选某一列中值在列表[1,2,3]中的数据
filtered_data = data[data['column'].isin([1, 2, 3])]
- 使用
query()函数可以根据条件表达式进行筛选。
# 筛选某一列中值大于10且小于20的数据
filtered_data = data.query('10 < column < 20')- 数据排序与重排
处理大数据时,数据的排序和重排经常是必不可少的操作。pandas提供了多个函数,可以帮助我们实现这一功能。
- 使用
sort_values()函数可以按照指定的列对数据进行排序。
# 按照某一列的值对数据进行升序排序
sorted_data = data.sort_values(by='column', ascending=True)
- 使用
sort_index()函数可以按照索引对数据进行排序。
# 按照索引对数据进行升序排序
sorted_data = data.sort_index(ascending=True)
- 数据分组与聚合
在处理大数据时,常常需要根据某些条件进行数据分组,并对每个组进行聚合计算。pandas提供了多个函数,可以帮助我们完成这个任务。
- 使用
groupby()函数可以根据某一列进行分组。
# 根据某一列进行分组
grouped_data = data.groupby('column')- 使用
agg()函数可以对分组后的数据进行聚合计算。
# 对分组后的数据进行求和操作
sum_data = grouped_data.agg({'column': 'sum'})- 数据合并与连接
在处理大数据时,常常需要将多个数据集合并或连接在一起。pandas提供了多个函数,可以帮助我们实现这一功能。
- 使用
merge()函数可以根据指定的列将两个数据集合并在一起。
# 按照某一列进行合并
merged_data = pd.merge(data1, data2, on='column')
- 使用
concat()函数可以将多个数据集按行或列的方式连接在一起。
# 按行连接两个数据集
concatenated_data = pd.concat([data1, data2], axis=0)
以上介绍了pandas库常用的一些函数以及具体的代码示例,希望对读者在处理大数据时有所帮助。当然,pandas库拥有更多强大的功能,涉及到更多复杂场景时可以进一步探索官方文档和其他资料。祝愿读者能够轻松处理大数据,并取得更好的分析效果!
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。

详解 python pandas安装 的完整步骤,包括使用 venv 创建隔离环境、通过 pip 安装依赖及验证导入成功。提供决策图辅助排错,适用于后端开发环境搭建。

详解 python 安装pandas 的正确姿势,包括使用 venv 隔离环境、通过 python -m pip 安装依赖、验证安装结果及处理常见报错,帮助开发者构建稳定的数据处理环境。
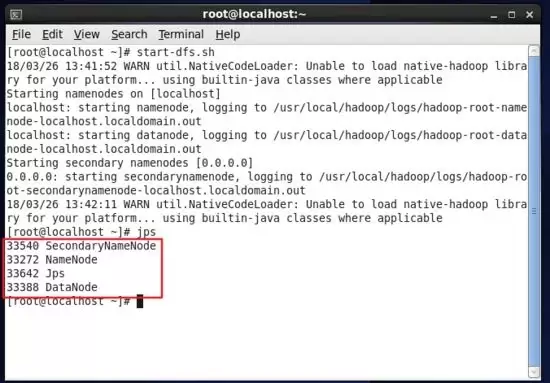
本教程指导大数据分析师在Linux环境中安装Hadoop,通过配置环境变量、验证版本及启动服务,确保Java和Hadoop命令可用。最终利用jps命令检查NameNode等核心进程状态,为后续学习HDFS和Spark打下基础。
麦富迪与达索系统联合举办技术公开日,展示数智化研发系统。通过WarmData大数据中心采集犬猫天性数据,结合达索系统仿真能力,实现配方模拟优化,缩短研发周期,推动宠物食品行业从经验驱动转向数据驱动。
总体原则匹配负载:以工作负载为锚点分配内存。轻量服务(如 Nginx、小型数据库)起步可给1–2 GB;桌面环境或中等负载建议2–4 GB;重负载(多服务/大数据/容器编排)在此基础上按峰值再加余量。始终以“应用需求 + 系统基线”为准,而非拍脑袋给大值。留有余量:宿主机需为自身与后台进程预留充足内
Debian 下 PostgreSQL 数据库迁移方案一、方案总览与选型方案适用场景停机窗口版本/平台要求关键工具主要优点主要限制逻辑导出导入(pg_dump/pg_restore、pg_dumpall)跨版本、跨平台、只迁部分库/表、云上/云下迁移一般为分钟级(取决于数据量)基本无限制,适合升级或
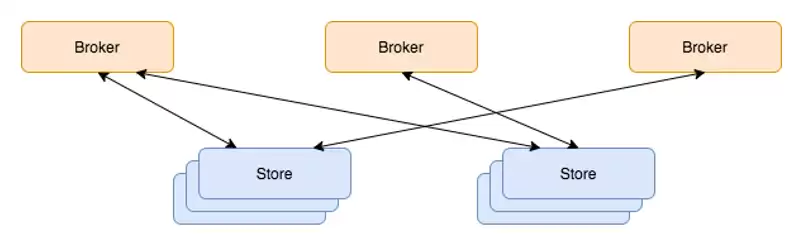
云妹导读:随着互联网的不断发展,大数据高并发不再遥远,是大部分项目都必须具备的能力。其中,消息队列几乎是必备技能。成熟的消息队列工具有很多,本篇文章就来介绍一款京东智联云自研消息队列工具——JCQ。JCQ全名JD Cloud Message Queue,是京东智联云自研,具有CloudNative特
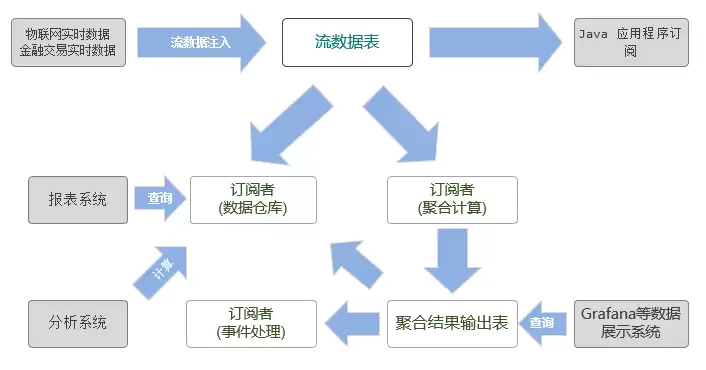
实时流处理一般是将业务系统产生的数据进行实时收集,交由流处理框架进行数据清洗,统计,入库,并可以通过可视化的方式对统计结果进行实时的展示。传统的面向静态数据表的计算引擎无法胜任流数据领域的分析和计算任务。在金融交易、物联网、互联网/移动互联网等应用场景中,复杂的业务需求对大数据处理的实时性提出了更高





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



