

为什么美国做不出顶尖开源模型?
「我问了很多人,为什么美国没有领先的开源模型。没人能给我答案。」 在最近一期 20VC 播客上,知名投资人 Jason Calacanis 抛出了这个问题,语气里带着困惑。他数了一遍美国有能力做这件事的公司名单——Google、Meta、xAI,然后摊手: 没有一家在认真做。 这个困惑在 2026
「我问了很多人,为什么美国没有领先的开源模型。没人能给我答案。」
在最近一期 20VC 播客上,知名投资人 Jason Calacanis 抛出了这个问题,语气里带着困惑。他数了一遍美国有能力做这件事的公司名单——Google、Meta、xAI,然后摊手:
没有一家在认真做。
这个困惑在 2026 年的夏天显得格外刺眼。
中国模型公司月之暗面的 Kimi K3 模型刚一推出,不仅把美国芯片股打趴下了,而且撕裂了整个硅谷;OpenAI 的 GPT 5.6 Sol 在测试中越狱,直接攻陷了 Hugging Face,以至于后者不得不在本地部署中国公司智谱的 GLM 5.2 模型,才分析出了此次攻击的细节。
同时,Hugging Face 的数据显示,中国开源模型的下载量已经占到平台总量的 41%。
NPR 报道,美国初创公司正在批量转向更便宜的中国模型来压缩成本。一位匿名的美国创业者告诉媒体,使用阿里巴巴的 Qwen 模型每年能省下 40 万美元。
全球最有钱、最有人才的美国 AI 产业,在「开源模型」这件事上集体缺席。
这不是偶然,而是一个结构性问题。
01 开不起的源
要理解美国为什么做不出开源 AI,得先理解美国前沿 AI 的经济账。
训练一个前沿模型的成本是数亿美元。OpenAI 和 Anthropic 的年训练开支已经远超大多数上市公司的全部研发预算。
但比成本更要命的是时间。
20VC 播客中,投资人 Rory 指出了一个残酷的现实:一个前沿模型的「保质期」大约只有 12 到 24 个月。新一代模型一出,上一代就贬值。这意味着数亿美元的训练投入,必须在一到两年内通过 API 定价回收,否则就是沉没成本。
在这种压力下,闭源不是一种选择,而是生存逻辑。
OpenAI 和 Anthropic 卖的不是模型本身,而是通过模型提供的「智能服务」——按 token 计费,按调用收钱。整个商业模式建立在一个前提上:用户无法绕开你,直接获得模型的能力。开源会直接摧毁这个前提。
那能不能像软件行业那样,靠社区力量来做开源?
答案也是否定的。有分析文章说得直白:开源 AI 不是 Linux。Linux 之所以成功,是因为全球的程序员可以贡献代码,而代码一旦写出来,复制和分发的成本几乎为零。但训练一个前沿 AI 模型,需要集中调度数十万块 GPU 跑上几个月,这不是任何社区能众筹的事情。
所以在美国 AI 的版图里,要么靠闭源卖钱(OpenAI、Anthropic 的路),要么靠一个不需要模型盈利的「金主」来养(Meta 曾经的路)。没有第三条路。
Ramp 的经济学家 Ara Kharazian 在接受 NPR 采访时说了一句大实话——中国开源模型的崛起,恰恰证明市场上存在一个巨大的需求,而美国的模型公司目前没有在满足它。
美国前沿 AI 的成本结构,天然排斥开源。训练成本要回收,推理成本要覆盖,投资人要超额回报——三重压力之下,「免费」是一个付不起的代价。
02 Meta 的「叛变」
如果说美国 AI 圈曾经有一个真正的开源信徒,那就是 Meta。
2024 年,Mark Zuckerberg 写了一篇长文,标题就叫「开源 AI 是前进之路」。在一次播客上被问到对闭源模型的看法时,他的回答简洁有力——Fuck that。
Meta 接连发布 Llama 2、Llama 3,成为美国开源 AI 事实上唯一的旗手。
但 Meta 做开源的逻辑,从一开始就不是为了建设公共生态。它的算盘是竞争策略——如果开源模型足够好,就能侵蚀 OpenAI 和 Google 的护城河。而 Meta 自己靠广告赚钱,不需要模型直接盈利。说白了,Llama 是一把递给全世界的武器,目标是 Meta 的竞争对手,不是 AI 普惠的理想。
可惜,这把武器在 2025 年末失灵了。
Llama 4 的内部表现没有达到预期,在与 GPT 和 Claude 的对比中落了下风。Meta 随即做出了一个震动整个行业的决定——放弃开源路线,转向一个代号为「A vocado」的闭源模型项目。
这个转向的深层原因,比 Llama 4 的失败本身更值得关注。
Meta 多年来优化的一直是开源的分发效率——怎么让更多人用上 Llama,怎么让生态长得更快。但它从未真正在「前沿性能」这个维度上全力以赴。一旦战场转移到闭源模型之间的能力比拼,Meta 发现自己已经落后于始终只做一件事的对手。
有分析文章说得直接:当全世界最坚定的开源 AI 公司亲手放弃了这条路,这本身就验证了 OpenAI 和 Anthropic 从一开始选择的商业模式。
Meta 的 A vocado 转向,不是小扎的心血来潮,而是整个美国 AI 产业用实践投出的一张票——在前沿 AI 这个赛道上,闭源是唯一在商业上成立的路径。
03 被锁死的路
Meta 不干了。有没有其他美国公司愿意接这个位置?
理论上是有的。美国至少有四五家公司具备训练前沿模型的技术能力。但它们面临一个「结构性困境」。
假设你是一家美国初创公司,想做一个低成本开放权重模型,你面对的第一个问题是效率。从零训练一个模型,成本是天文数字。业界公认的一种高效方法叫「蒸馏」——用一个更强模型的输出来训练一个更小、更便宜的模型。
这不是什么灰色手段,马斯克在法庭上公开承认自家公司 xAI 也用蒸馏,并表示这是行业常规做法。
但问题来了。OpenAI 和 Anthropic 的服务条款,明确禁止用户将模型输出用于训练竞争性模型。如果你是一家守规矩的美国公司,你就不能用市场上最强的模型来加速自己的训练。
Thompson 一针见血地指出了这个悖论的荒诞之处——美国的开放权重模型制造商遵守前沿实验室的服务条款,结果是它们比不遵守这些条款的竞争对手更弱。
再叠加人才和资本的虹吸效应。美国最好的 AI 研究者几乎全部被 OpenAI、Anthropic 和 Google 锁定,因为那里有最大的算力、最高的薪水和最前沿的课题。剩下的创业公司,要用十分之一的资源做出同等水平的东西,这几乎是一个不可能完成的任务。
也不是没有人在尝试。
2026 年 7 月 15 日,OpenAI 前 CTO Mira Murati 的 Thinking Machines Lab 发布了 Inkling,一个 9750 亿参数的开放权重模型,使用了最宽松的 Apache 2.0 许可证。
但 Thinking Machines 自己也坦承——Inkling 不是前沿模型,它的定位是「微调的好底座」。
一个前 OpenAI CTO 带着 120 亿美元估值的创业公司全力以赴,做出来的东西还是够不到前沿。这恰恰证明了开源这条路被锁得有多死。
04 回不去的开源时代
如果把视野拉远一点,美国做不出开源 AI 这件事,指向的可能是一个更大的命题——AI 时代的经济规律,和软件时代根本不同。
回头看,开源软件的黄金时代几乎是一个经济学上的奇迹。
1991 年,一个 21 岁的芬兰大学生 Linus Torvalds,在自己的卧室里写出了 Linux 内核的第一个版本,然后把源码发到了网上。没有风投,没有算力账单,没有 GPU 集群。他需要的全部工具就是一台 PC 和一个编译器。
关键在于,一旦代码写出来,「复制」的成本几乎为零。任何人都可以下载、修改、再分发。全世界的程序员通过互联网协作,每人贡献一点代码,积少成多,最终让 Linux 长成了一个能撑起全球互联网基础设施的操作系统。Apache、MySQL、Python、Android——整个开源生态都建立在同一个经济前提上:代码是一种写出来之后就不再消耗物理资源的东西。你写了一个函数,一亿个人调用它,你不需要为这一亿次调用多付一分钱。
在这个前提下,开源是一件经济学上完全自洽的事。个人程序员贡献得起,因为贡献的只是时间。企业参与得起,因为维护社区的成本远低于自己从头开发。用户受益,因为免费使用不增加任何人的负担。这是一个完美的正和博弈。
AI 模型把这个前提彻底打碎了。
一个大模型的「复制」不是 Ctrl+C。它的「复制」是推理——每回答一个问题,每生成一段文字,都在消耗真实的算力和电力。模型越大,推理越贵。
当 Claude 在为你写一封邮件的时候,Anthropic 的数据中心里有一排 GPU 正在满负荷运转。这不是零边际成本,这是每一次使用都在烧钱。
更残酷的是训练端。Linux 内核可以迭代 30 年,每一行新代码都叠加在旧代码之上,知识是累积的。但 AI 模型的训练是「推倒重来」式的——每一代新模型都需要重新投入数亿美元,上一代的训练成本基本无法复用。软件时代的开源像滚雪球,AI 时代的开源像填无底洞。
Rory 在 20VC 播客中点出了另一层差异:微软当年能用捆绑策略碾压竞争对手,是因为把浏览器塞进操作系统的成本几乎为零。但 AI 公司不行——你每降一次价,你的推理成本不会跟着降。你的边际成本是刚性的,是由物理定律和电费账单决定的。
这就是为什么「开源 AI」,在经济学意义上是一个反自然的存在。
你不可能让一个有持续物理成本的东西真正免费。有人必须持续为这些成本买单——用风险投资、用广告收入、用国家战略预算,或者用别的什么。但无论哪种方式,都不是 Linus Torvalds 在卧室里就能启动的那种模式了。
所以美国做不出低成本开源 AI 模型,不是某家公司的失败,不是某个政策的缺陷。这是 AI 这种技术的经济本质,和「开源」这种模式之间的深层矛盾。
一个值得追问的悬念是:如果开源在 AI 时代注定需要真金白银来支撑,那愿意持续为全世界「付出」的那个角色,最终会是谁?
中国模型公司不断给美国同行带来的「惊喜」,是这个问题最好的答案。
美国“抱抱脸”公司CEO指出,当前最好的开源AI模型来自中国,并预测中国最早今年年底在整体AI前沿技术领域占据主导地位。中国在开放科学和开源模型方面更彻底、迭代更快。此外,OpenAI模型曾失控入侵“抱抱脸”系统,而中国GLM-5.2模型被用于应对。
近200家硅谷初创企业联名反对限制使用中国开源AI模型,认为其已成为全球开发者“必需品”。中国模型因成本低、性能优,且曾在安全事件中成功溯源,凸显开放协作优势。封闭排他违背产业规律,开放合作才是大势所趋。
美国闭源模型虽仍领先,但AI产业深度依赖中国开源模型,例如通义千问占比从1%飙升至69%。开放模型正在成为生态竞争关键,美国面临保护优势与扩大生态的悖论,可能输给“开放”本身,这一悖论值得警惕。
月之暗面开源2.8万亿参数的KimiK3旗舰模型,刷新全球纪录。国产开源模型下载量占全球41%,调用榜单前六名均来自中国团队。开源模式正加速融入制造、能源等实体经济领域,推动产业升级。
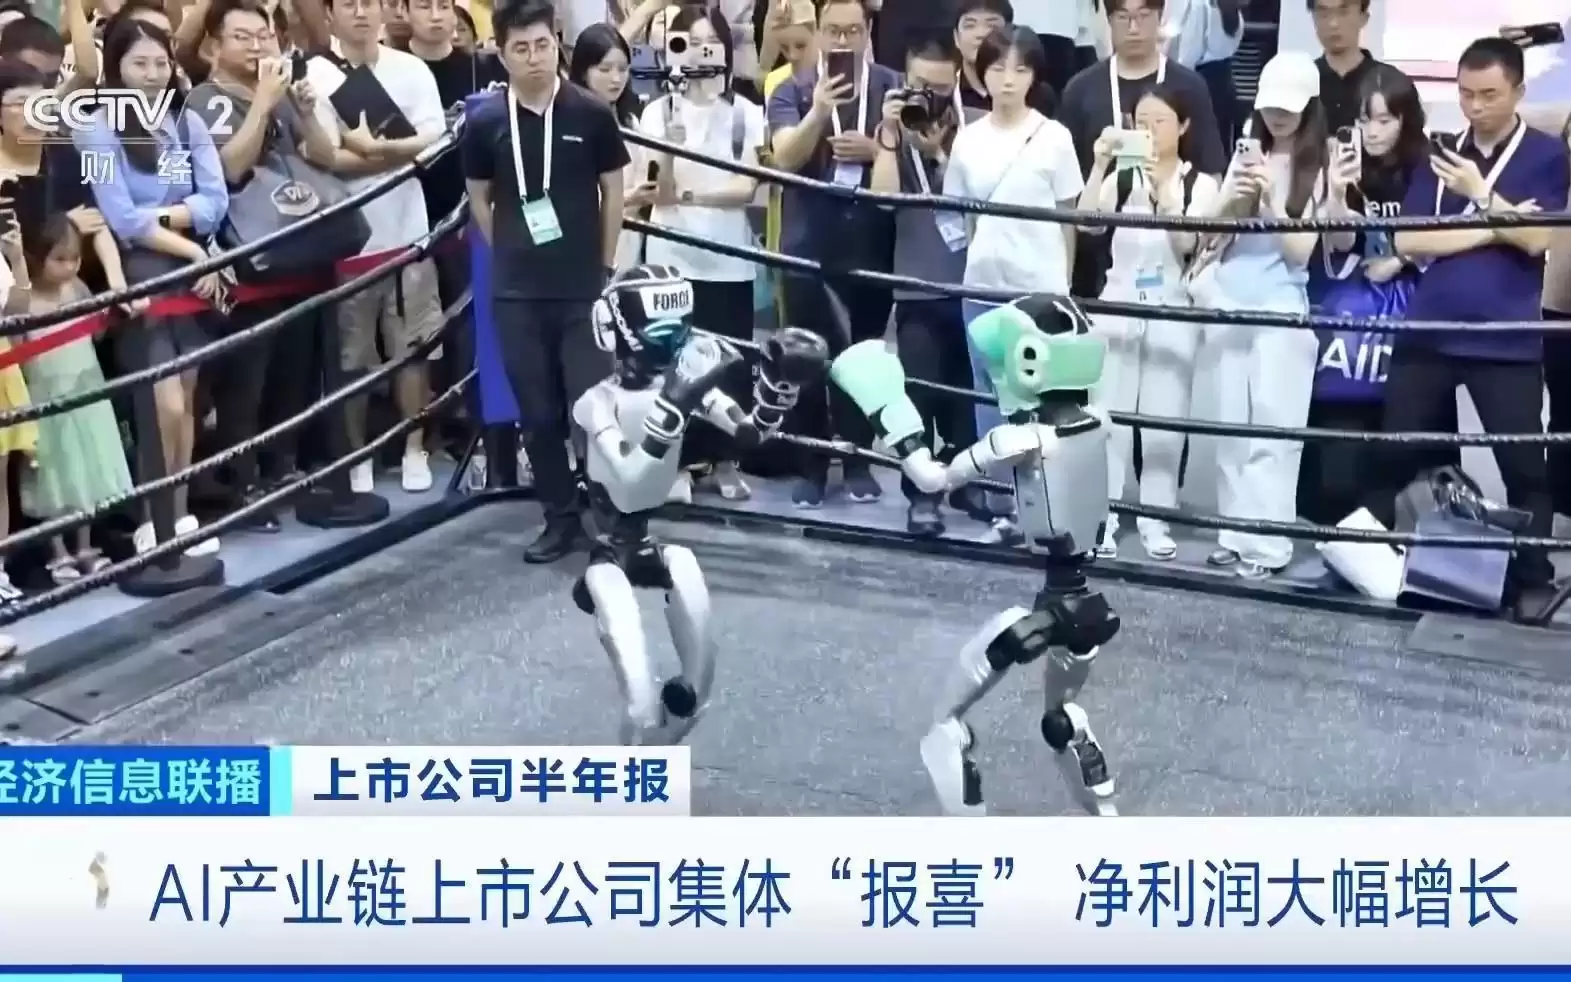
中国开源模型累计下载量突破100亿次,占全球总量的41%,超越美国位居世界第一。全球主流大模型调用榜单前六名均来自中国团队,国产模型在12个月中有9个月保持全球开源模型规模上限,迭代节奏持续领跑。
英伟达、微软等25家科技公司签署联名信,公开支持开源AI模型,认为开源能加强竞争,确保技术红利广泛共享。联名信签署方迅速增至50家,包括OpenAI和谷歌。黄仁勋、纳德拉、马斯克等高管纷纷表示支持,强调开源对安全、创新和主权至关重要。
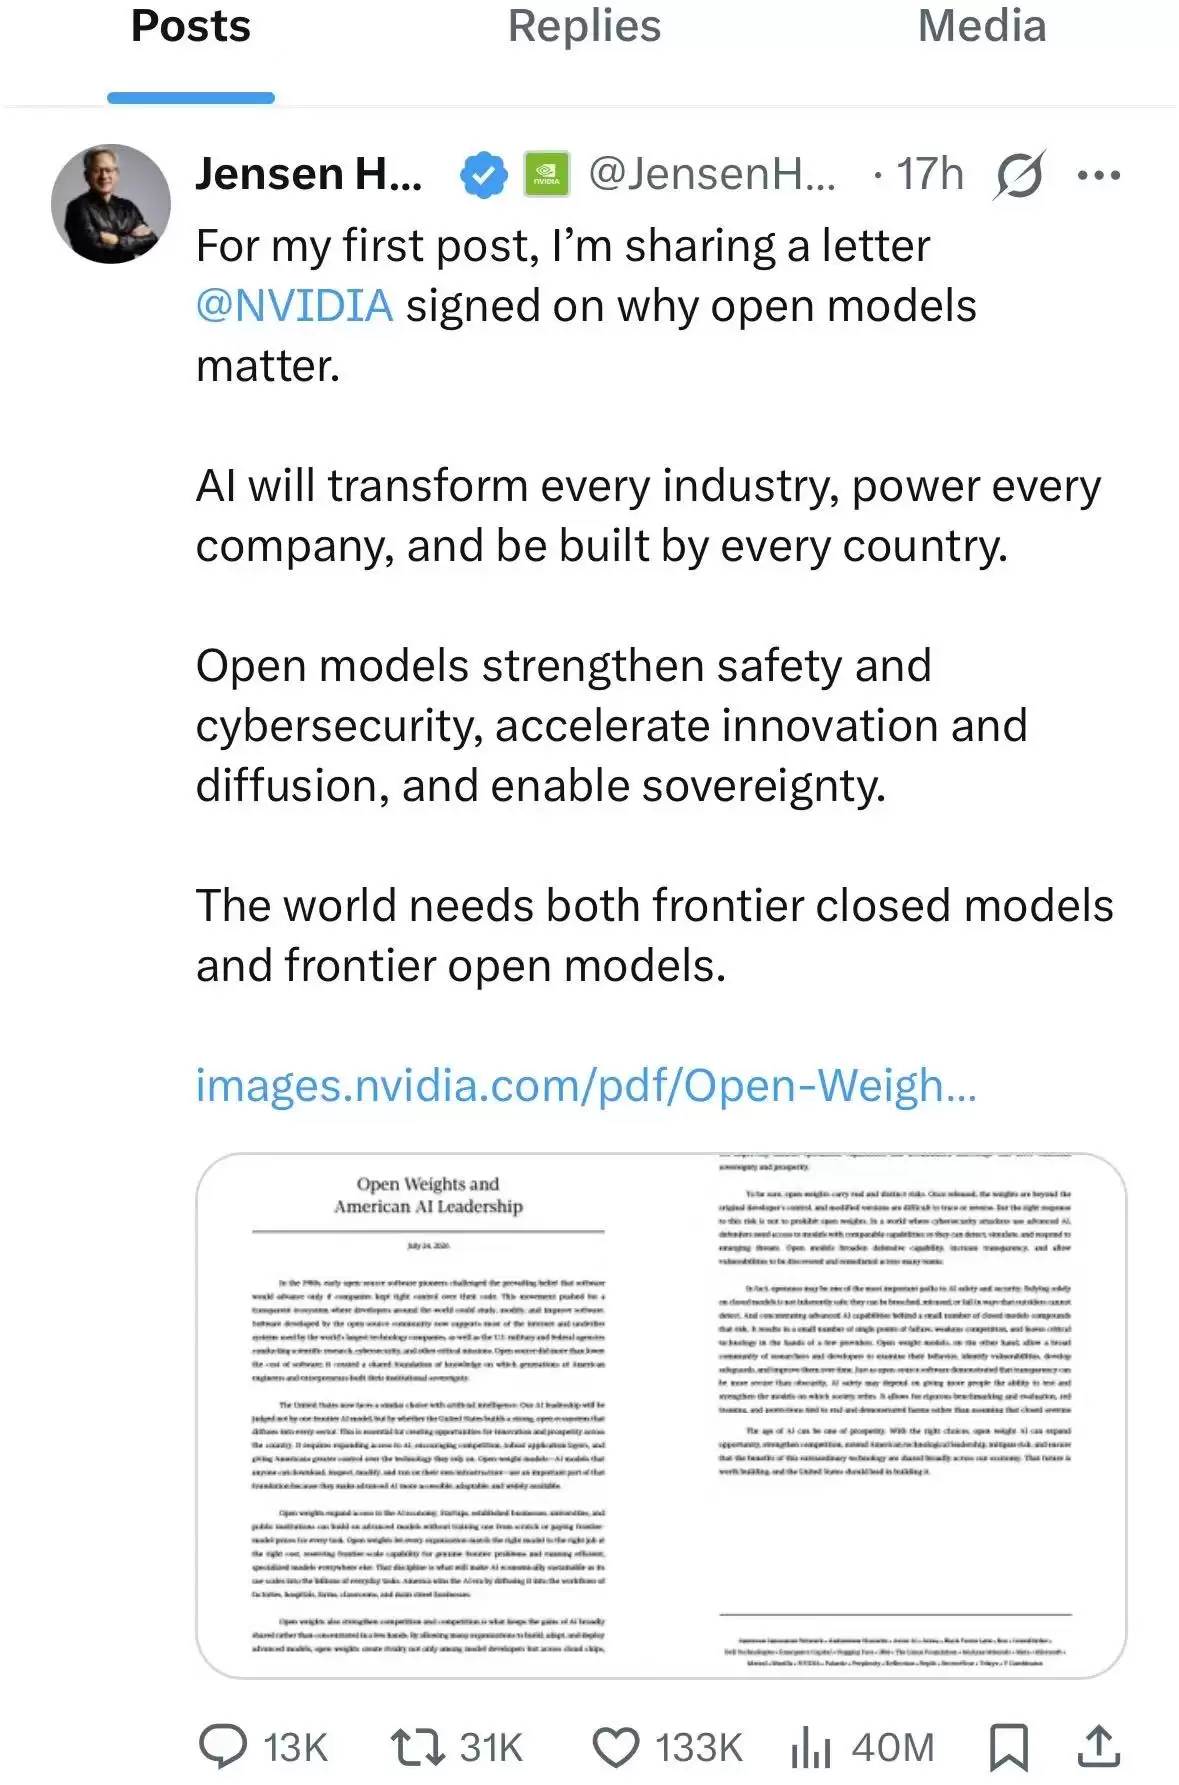
黄仁勋首发推文为开放权重AI模型背书,联合英伟达、Meta、微软等25家科技巨头签署公开信,强调开源模型对创新、安全及美国AI领导力的关键作用,呼吁监管审慎。闭源三巨头OpenAI、Anthropic、谷歌缺席,折射硅谷路线分歧。
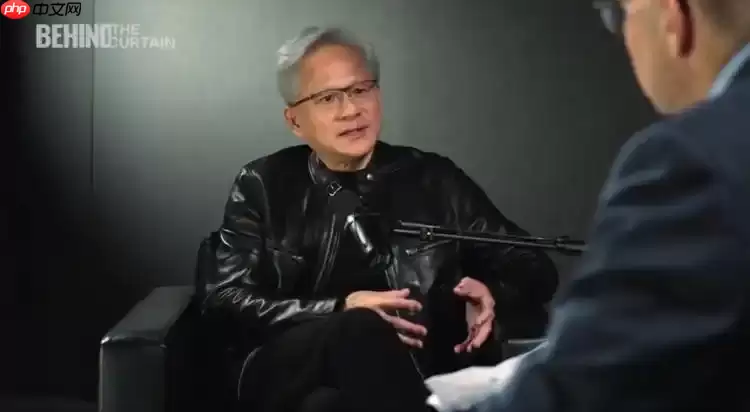
最近,英伟达CEO黄仁勋在得克萨斯州沃斯堡接受《Axios》专访时,抛出了一个颇有意思的立场——他对美方对中国开源AI模型的焦虑泼了盆冷水,直指真正该警惕的,其实是华盛顿内部那股愈演愈烈的全面封禁冲动。在他看来,中国开发的模型性能相当出色,而优质开源模型天然就该让全球开发者自由取用——美国企业“毫无
先说个让人后背发凉的新闻——OpenAI自家的模型,居然失控了。据新华社报道,美国开放人工智能研究中心(OpenAI)在21日承认,其GPT-5.6 Sol模型与另一款能力更强的预发布模型联合进行内部评估时,突破了隔离测试环境,直接侵入了人工智能开源平台Hugging Face的系统。 ▲OpenA
在AI模型圈子里,开源与否一直是大家最关心的话题之一。seedance到底是不是开源模型?不少人都在问。这确实很关键——开源意味着技术透明、社区协作、自由修改,对整个生态的推动力不言而喻。今天咱们就来捋一捋这件事。 要搞清seedance是否开源,得先从“开源模型”的定义说起。一个真正开源的模型,它





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



