

Pandas:利用去除重复数据的方法,提升数据分析效率
数据处理神器Pandas:掌握去重方法,提高数据分析效率【引言】在数据分析的过程中,经常会遇到数据中包含重复值的情况。这些重复值不仅会影响数据分析结果的准确性,还会降低分析的效率。为了解决这个问题,Pandas提供了丰富的去重方法,可以帮助我们高效地处理重复值。本文将介绍几种常用的去重方法,并提供具体的代码示例,希望能帮助大家更好地掌握Pandas的数据处理
数据处理神器Pandas:掌握去重方法,提高数据分析效率
【引言】
在数据分析的过程中,经常会遇到数据中包含重复值的情况。这些重复值不仅会影响数据分析结果的准确性,还会降低分析的效率。为了解决这个问题,Pandas提供了丰富的去重方法,可以帮助我们高效地处理重复值。本文将介绍几种常用的去重方法,并提供具体的代码示例,希望能帮助大家更好地掌握Pandas的数据处理能力,提高数据分析的效率。
【总纲】
本文将围绕以下几个方面展开介绍:
- 去除重复行
- 去除重复列
- 基于列值的去重
- 基于条件的去重
- 基于索引的去重
【正文】
- 去除重复行
在数据分析过程中,经常会遇到数据集中包含相同行的情况。为了去除这些重复行,可以使用Pandas中的drop_duplicates()方法。下面是一个示例:
import pandas as pd

# 创建数据集
data = {'A': [1, 2, 3, 4, 1],
        'B': [5, 6, 7, 8, 5]}
df = pd.DataFrame(data)

# 去除重复行
df.drop_duplicates(inplace=True)

print(df)
运行结果如下所示:
   A  B
0  1  5
1  2  6
2  3  7
3  4  8
- 去除重复列
有时候,我们可能会遇到数据集中包含相同列的情况。为了去除这些重复列,可以使用Pandas中的T属性和drop_duplicates()方法。下面是一个示例:
import pandas as pd

# 创建数据集
data = {'A': [1, 2, 3, 4, 5],
        'B': [5, 6, 7, 8, 9],
        'C': [1, 2, 3, 4, 5]}
df = pd.DataFrame(data)

# 去除重复列
df = df.T.drop_duplicates().T

print(df)
运行结果如下所示:
   A  B
0  1  5
1  2  6
2  3  7
3  4  8
4  5  9
- 基于列值的去重
有时候,我们需要根据某一列的值来进行去重操作。可以使用Pandas中的duplicated()方法和~运算符来实现。下面是一个示例:
import pandas as pd

# 创建数据集
data = {'A': [1, 2, 3, 1, 2],
        'B': [5, 6, 7, 8, 9]}
df = pd.DataFrame(data)

# 基于列A的值进行去重
df = df[~df['A'].duplicated()]

print(df)
运行结果如下所示:
   A  B
0  1  5
1  2  6
2  3  7
- 基于条件的去重
有时候,在进行数据分析时,我们可能需要根据某些条件对数据进行去重操作。Pandas提供了drop_duplicates()方法的subset参数,可以实现基于条件的去重操作。下面是一个示例:
import pandas as pd

# 创建数据集
data = {'A': [1, 2, 3, 1, 2],
        'B': [5, 6, 7, 8, 9]}
df = pd.DataFrame(data)

# 基于列B的值进行去重,但只保留A列值为1的行
df = df.drop_duplicates(subset=['B'], keep='first')

print(df)
运行结果如下所示:
   A  B
0  1  5
1  2  6
- 基于索引的去重
有时候,在对数据进行处理时,我们可能会遇到索引重复的情况。Pandas提供了duplicated()和drop_duplicates()方法的keep参数,可以实现基于索引的去重操作。下面是一个示例:
import pandas as pd

# 创建数据集
data = {'A': [1, 2, 3, 4, 5]}
df = pd.DataFrame(data, index=[1, 1, 2, 2, 3])

# 基于索引进行去重,保留最后一次出现的数值
df = df[~df.index.duplicated(keep='last')]

print(df)
运行结果如下所示:
   A
1  2
2  4
3  5
【结论】
通过本文的介绍和代码示例,我们可以看到,Pandas提供了丰富的去重方法,可以帮助我们高效地处理数据中的重复值。掌握这些方法,可以在数据分析的过程中提高效率,并得到准确的分析结果。希望本文对大家学习Pandas数据处理能力有所帮助。
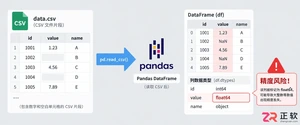
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
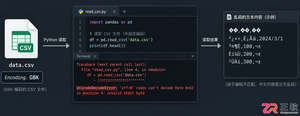
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。

详解 python pandas安装 的完整步骤,包括使用 venv 创建隔离环境、通过 pip 安装依赖及验证导入成功。提供决策图辅助排错,适用于后端开发环境搭建。

详解 python 安装pandas 的正确姿势,包括使用 venv 隔离环境、通过 python -m pip 安装依赖、验证安装结果及处理常见报错,帮助开发者构建稳定的数据处理环境。
针对数据框中列表列转宽格式的需求,推荐使用数据框构造方法,将列表列的值转换为列表后直接构造宽格式数据框,避免使用展开与透视函数的复杂低效操作。该方法要求各列表长度一致,支持动态列名,代码简洁,执行效率高。
在pandas中处理含等长列表的列时,利用pd.DataFrame()构造器将列表列转为二维结构,配合索引对齐直接生成宽表。该方法支持动态列名生成,避免了使用explode与pivot的繁琐步骤,且能保持数据类型并显著提升处理效率,实现高效的行式爆炸。
在Pandas数据处理中,利用shift、eq、cumsum、where、ffill等函数构建分组键,将每个连续真值段及其后续首个假值划分为一组。随后可以使用ffill和bfill实现组内双向填充,或使用transform('first')高效广播组内首个非空值,从而省去手动切片拼接的繁琐步骤。
使用Pandas库的read_csv函数读取CSV文件,通过直接赋值方式新增一列名为salary,将基本工资、津贴和补贴三列数值求和后赋给该列,再调用to_csv函数保存结果并设置index参数为False避免写入索引。整个过程无需循环,仅需三步,简洁高效。
利用Pandas将字典映射的转换因子与DataFrame进行批量乘法,通过对齐索引映射、广播乘法、按列求最小值及安全对齐(避免缺失值),为每个目标项计算可转换源项经缩放后的最小值,并作为新列添加到原表中。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



