

如何使用Siamese网络处理数据集不平衡问题(包含示例代码)
Siamese网络是一种用于度量学习的神经网络模型,它能够学习如何计算两个输入之间的相似度或差异度量。由于其灵活性,它在人脸识别、语义相似性计算和文本匹配等众多应用中广受欢迎。然而,当处理不平衡数据集时,Siamese网络可能会面临问题,因为它可能会过度关注少数类别的样本,而忽略大多数样本。为了解决这个问题,有几种技术可以使用。一种方法是通过欠采样或过采样来平衡数据集。欠采样是指从多数类别中随机删除一些样本,以使其与少数类别的样本数量相等。过采样则是通过复制或生成新的样本来增加少数类别的样本数量,使其与多
Siamese网络是一种用于度量学习的神经网络模型,它能够学习如何计算两个输入之间的相似度或差异度量。由于其灵活性,它在人脸识别、语义相似性计算和文本匹配等众多应用中广受欢迎。然而,当处理不平衡数据集时,Siamese网络可能会面临问题,因为它可能会过度关注少数类别的样本,而忽略大多数样本。为了解决这个问题,有几种技术可以使用。 一种方法是通过欠采样或过采样来平衡数据集。欠采样是指从多数类别中随机删除一些样本,以使其与少数类别的样本数量相等。过采样则是通过复制或生成新的样本来增加少数类别的样本数量,使其与多数类别的样本数量相等。这样可以有效地平衡数据集,但可能会导致信息损失或过拟合的问题。 另一种方法是使用权重调整。通过为少数类别的样本分配较高的权重,可以提高Siamese网络对少数类别的关注度。这样可以在不改变数据集的情况下,重点关注少数类别,从而提高模型的性能。 此外,还可以使用一些先进的度量学习算法来改进Siamese网络的性能,例如基于对抗生成网络的生成式对抗网络(GAN)
1.重采样技术
在不平衡数据集中,类别样本数量差异大。为平衡数据集,可使用重采样技术。常见的包括欠采样和过采样,防止过度关注少数类别。
欠采样是为了平衡多数类别和少数类别的样本量,通过删除多数类别的一些样本,使其与少数类别具有相同数量的样本。这种方法可以减少模型对多数类别的关注,但也可能会丢失一些有用的信息。
过采样是通过复制少数类别的样本来平衡样本不平衡问题,使得少数类别和多数类别具有相同数量的样本。尽管过采样可以增加少数类别样本数量,但也可能导致过拟合的问题。
2.样本权重技术
另一种处理不平衡数据集的方法是使用样本权重技术。这种方法可以为不同类别的样本赋予不同的权重,以反映其在数据集中的重要性。
一种常见的方法是使用类别频率来计算样本的权重。具体来说,可以将每个样本的权重设置为$$
w_i=\frac{1}{n_c\cdot n_i}
其中n_c是类别c中的样本数量,n_i是样本i所属类别中的样本数量。这种方法可以使得少数类别的样本具有更高的权重,从而平衡数据集。
3.改变损失函数
Siamese网络通常使用对比损失函数来训练模型,例如三元组损失函数或余弦损失函数。在处理不平衡数据集时,可以使用改进的对比损失函数来使模型更加关注少数类别的样本。
一种常见的方法是使用加权对比损失函数,其中少数类别的样本具有更高的权重。具体来说,可以将损失函数改为如下形式:
L=\frac{1}{N}\sum_{i=1}^N w_i\cdot L_i
其中N是样本数量,w_i是样本i的权重,L_i是样本i的对比损失。
4.结合多种方法
最后,为了处理不平衡数据集,可以结合多种方法来训练Siamese网络。例如,可以使用重采样技术和样本权重技术来平衡数据集,然后使用改进的对比损失函数来训练模型。这种方法可以充分利用各种技术的优点,并在不平衡数据集上获得更好的性能。
对于不平衡的数据集,有一种常见的解决方案是使用加权损失函数,其中较少出现的类别分配更高的权重。以下是一个简单的示例,展示如何在Keras中实现带有加权损失函数的Siamese网络,以处理不平衡数据集:
from keras.layers import Input, Conv2D, Lambda, Dense, Flatten, MaxPooling2D
from keras.models import Model
from keras import backend as K
import numpy as np

# 定义输入维度和卷积核大小
input_shape = (224, 224, 3)
kernel_size = 3

# 定义共享的卷积层
conv1 = Conv2D(64, kernel_size, activation='relu', padding='same')
pool1 = MaxPooling2D(pool_size=(2, 2))
conv2 = Conv2D(128, kernel_size, activation='relu', padding='same')
pool2 = MaxPooling2D(pool_size=(2, 2))
conv3 = Conv2D(256, kernel_size, activation='relu', padding='same')
pool3 = MaxPooling2D(pool_size=(2, 2))
conv4 = Conv2D(512, kernel_size, activation='relu', padding='same')
flatten = Flatten()

# 定义共享的全连接层
dense1 = Dense(512, activation='relu')
dense2 = Dense(512, activation='relu')

# 定义距离度量层
def euclidean_distance(vects):
    x, y = vects
    sum_square = K.sum(K.square(x - y), axis=1, keepdims=True)
    return K.sqrt(K.maximum(sum_square, K.epsilon()))

# 定义Siamese网络
input_a = Input(shape=input_shape)
input_b = Input(shape=input_shape)

processed_a = conv1(input_a)
processed_a = pool1(processed_a)
processed_a = conv2(processed_a)
processed_a = pool2(processed_a)
processed_a = conv3(processed_a)
processed_a = pool3(processed_a)
processed_a = conv4(processed_a)
processed_a = flatten(processed_a)
processed_a = dense1(processed_a)
processed_a = dense2(processed_a)

processed_b = conv1(input_b)
processed_b = pool1(processed_b)
processed_b = conv2(processed_b)
processed_b = pool2(processed_b)
processed_b = conv3(processed_b)
processed_b = pool3(processed_b)
processed_b = conv4(processed_b)
processed_b = flatten(processed_b)
processed_b = dense1(processed_b)
processed_b = dense2(processed_b)

distance = Lambda(euclidean_distance)([processed_a, processed_b])

model = Model([input_a, input_b], distance)

# 定义加权损失函数
def weighted_binary_crossentropy(y_true, y_pred):
    class1_weight = K.variable(1.0)
    class2_weight = K.variable(1.0)
    class1_mask = K.cast(K.equal(y_true, 0), 'float32')
    class2_mask = K.cast(K.equal(y_true, 1), 'float32')
    class1_loss = class1_weight * K.binary_crossentropy(y_true, y_pred) * class1_mask
    class2_loss = class2_weight * K.binary_crossentropy(y_true, y_pred) * class2_mask
    return K.mean(class1_loss + class2_loss)

# 编译模型,使用加权损失函数和Adam优化器
model.compile(loss=weighted_binary_crossentropy, optimizer='adam')

# 训练模型
model.fit([X_train[:, 0], X_train[:, 1]], y_train, batch_size=32, epochs=10, validation_data=([X_val[:, 0], X_val[:, 1]], y_val))
其中,weighted_binary_crossentropy函数定义了加权损失函数,class1_weight和class2_weight分别是类别1和类别2的权重,class1_mask和class2_mask是用于屏蔽类别1和类别2的掩码。在训练模型时,需要将训练数据和验证数据传递给模型的两个输入,并将目标变量作为第三个参数传递给fit方法。请注意,这只是一个示例,并不保证能够完全解决不平衡数据集的问题。在实际应用中,可能需要尝试不同的解决方案,并根据具体情况进行调整。

机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
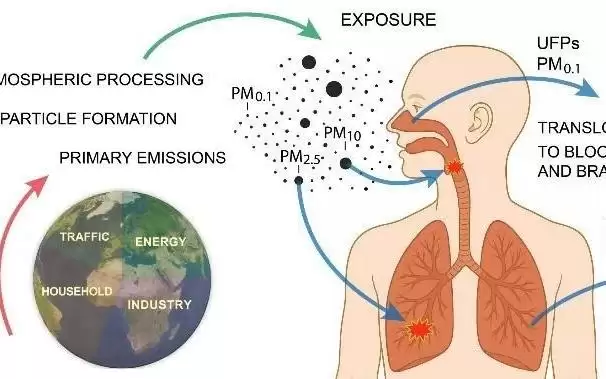
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化
机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。
少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



