

变分自动编码器的原理和实现步骤详解
变分自动编码器(VAE)是一种基于神经网络的生成模型。它的目标是学习高维数据的低维潜在变量表示,并利用这些潜在变量进行数据的重构和生成。相比传统的自动编码器,VAE通过学习潜在空间的分布,可以生成更真实且多样性的样本。下面将详细介绍VAE的实现方法。1.VAE的基本原理VAE的基本思想是通过将高维数据映射到低维的潜在空间,实现数据的降维和重构。它由编码器和解码器两个部分组成。编码器将输入数据x映射到潜在空间的均值μ和方差σ^2。通过这种方式,VAE可以在潜在空间中对数据进行采样,并通过解码器将采样结果重构

变分自动编码器(VAE)是一种基于神经网络的生成模型。它的目标是学习高维数据的低维潜在变量表示,并利用这些潜在变量进行数据的重构和生成。相比传统的自动编码器,VAE通过学习潜在空间的分布,可以生成更真实且多样性的样本。下面将详细介绍VAE的实现方法。
1.VAE的基本原理
VAE的基本思想是通过将高维数据映射到低维的潜在空间,实现数据的降维和重构。它由编码器和解码器两个部分组成。编码器将输入数据x映射到潜在空间的均值μ和方差σ^2。通过这种方式,VAE可以在潜在空间中对数据进行采样,并通过解码器将采样结果重构为原始数据。这种编码器-解码器结构使得VAE能够生成新的样本,并且在潜在空间中具有良好的连续性,使得相似的样本在潜在空间中距离较近。因此,VAE不仅可以用于降维和
\begin{aligned}
\mu &=f_{\mu}(x)\
\sigma^2 &=f_{\sigma}(x)
\end{aligned}
其中,f_{\mu}和f_{\sigma}可以是任意的神经网络模型。通常情况下,我们使用一个多层感知机(Multilayer Perceptron,MLP)来实现编码器。
解码器则将潜在变量z映射回原始数据空间,即:
x'=g(z)
其中,g也可以是任意的神经网络模型。同样地,我们通常使用一个MLP来实现解码器。
在VAE中,潜在变量$z$是从一个先验分布(通常是高斯分布)中采样得到的,即:
z\sim\mathcal{N}(0,I)这样,我们就可以通过最小化重构误差和潜在变量的KL散度来训练VAE,从而实现数据的降维和生成。具体来说,VAE的损失函数可以表示为:
\mathcal{L}=\mathbb{E}_{z\sim q(z|x)}[\log p(x|z)]-\beta\mathrm{KL}[q(z|x)||p(z)]其中,q(z|x)是后验分布,即给定输入x时潜在变量z的条件分布;p(x|z)是生成分布,即给定潜在变量$z$时对应的数据分布;p(z)是先验分布,即潜在变量z的边缘分布;\beta是一个超参数,用于平衡重构误差和KL散度。
通过最小化上述损失函数,我们可以学习到一个转换函数f(x),它可以将输入数据x映射到潜在空间的分布q(z|x)中,并且可以从中采样得到潜在变量z,从而实现数据的降维和生成。
2.VAE的实现步骤
下面我们将介绍如何实现一个基本的VAE模型,包括编码器、解码器和损失函数的定义。我们以MNIST手写数字数据集为例,该数据集包含60000个训练样本和10000个测试样本,每个样本为一张28x28的灰度图像。
2.1数据预处理
首先,我们需要对MNIST数据集进行预处理,将每个样本转换成一个784维的向量,并将其归一化到[0,1]的范围内。代码如下:
# python

import torch

import torchvision.transforms as transforms

from torchvision.datasets import MNIST

# 定义数据预处理

transform = transforms.Compose([
    transforms.ToTensor(),  # 将图像转换成Tensor格式
    transforms.Normalize(mean=(0.
2.2 定义模型结构
接下来,我们需要定义VAE模型的结构,包括编码器、解码器和潜在变量的采样函数。在本例中,我们使用一个两层的MLP作为编码器和解码器,每层的隐藏单元数分别为256和128。潜在变量的维度为20。代码如下:
import torch.nn as nn

class VAE(nn.Module):
    def __init__(self, input_dim=784, hidden_dim=256, latent_dim=20):
        super(VAE, self).__init__()

        # 定义编码器的结构
        self.encoder = nn.Sequential(
            nn.Linear(input_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, hidden_dim//2),
            nn.ReLU(),
            nn.Linear(hidden_dim//2, latent_dim*2)  # 输出均值和方差
        )

        # 定义解码器的结构
        self.decoder = nn.Sequential(
            nn.Linear(latent_dim, hidden_dim//2),
            nn.ReLU(),
            nn.Linear(hidden_dim//2, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, input_dim),
            nn.Sigmoid()  # 输出范围在[0, 1]之间的概率
        )

    # 潜在变量的采样函数
    def sample_z(self, mu, logvar):
        std = torch.exp(0.5*logvar)
        eps = torch.randn_like(std)
        return mu + eps*std

    # 前向传播函数
    def forward(self, x):
        # 编码器
        h = self.encoder(x)
        mu, logvar = h[:, :latent_dim], h[:, latent_dim:]
        z = self.sample_z(mu, logvar)

        # 解码器
        x_hat = self.decoder(z)
        return x_hat, mu, logvar
在上述代码中,我们使用一个两层的MLP作为编码器和解码器。编码器将输入数据映射到潜在空间的均值和方差,其中均值的维度为20,方差的维度也为20,这样可以保证潜在变量的维度为20。解码器将潜在变量映射回原始数据空间,其中最后一层使用Sigmoid函数将输出范围限制在[0, 1]之间。
在实现VAE模型时,我们还需要定义损失函数。在本例中,我们使用重构误差和KL散度来定义损失函数,其中重构误差使用交叉熵损失函数,KL散度使用标准正态分布作为先验分布。代码如下:
# 定义损失函数
def vae_loss(x_hat, x, mu, logvar, beta=1):
    # 重构误差
    recon_loss = nn.functional.binary_cross_entropy(x_hat, x, reduction='sum')

    # KL散度
    kl_loss = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp())

    return recon_loss + beta*kl_loss
在上述代码中,我们使用交叉熵损失函数计算重构误差,使用KL散度计算潜在变量的分布与先验分布之间的差异。其中,\beta是一个超参数,用于平衡重构误差和KL散度。
2.3 训练模型
最后,我们需要定义训练函数,并在MNIST数据集上训练VAE模型。训练过程中,我们首先需要计算模型的损失函数,然后使用反向传播算法更新模型参数。代码如下:
# python
# 定义训练函数

def train(model, dataloader, optimizer, device, beta):
    model.train()
    train_loss = 0

for x, _ in dataloader:
    x = x.view(-1, input_dim).to(device)
    optimizer.zero_grad()
    x_hat, mu, logvar = model(x)
    loss = vae_loss(x_hat, x, mu, logvar, beta)
        loss.backward()
        train_loss += loss.item()
        optimizer.step()

return train_loss / len(dataloader.dataset)
现在,我们可以使用上述训练函数在MNIST数据集上训练VAE模型了。代码如下:
# 定义模型和优化器
model = VAE().to(device)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

# 训练模型
num_epochs = 50
for epoch in range(num_epochs):
    train_loss = train(model, trainloader, optimizer, device, beta=1)
    print(f'Epoch {epoch+1}/{num_epochs}, Train Loss: {train_loss:.4f}')

# 测试模型
model.eval()
with torch.no_grad():
    test_loss = 0
    for x, _ in testloader:
        x = x.view(-1, input_dim).to(device)
        x_hat, mu, logvar = model(x)
        test_loss += vae_loss(x_hat, x, mu, logvar, beta=1).item()
    test_loss /= len(testloader.dataset)
    print(f'Test Loss: {test_loss:.4f}')
在训练过程中,我们使用Adam优化器和\beta=1的超参数来更新模型参数。在训练完成后,我们使用测试集计算模型的损失函数。在本例中,我们使用重构误差和KL散度来计算损失函数,因此测试损失越小,说明模型学习到的潜在表示越好,生成的样本也越真实。
2.4 生成样本
最后,我们可以使用VAE模型生成新的手写数字样本。生成样本的过程非常简单,只需要在潜在空间中随机采样,然后将采样结果输入到解码器中生成新的样本。代码如下:
# 生成新样本
n_samples = 10
with torch.no_grad():
    # 在潜在空间中随机采样
    z = torch.randn(n_samples, latent_dim).to(device)
    # 解码生成样本
    samples = model.decode(z).cpu()
    # 将样本重新变成图像的形状
    samples = samples.view(n_samples, 1, 28, 28)
    # 可视化生成的样本
    fig, axes = plt.subplots(1, n_samples, figsize=(20, 2))
    for i, ax in enumerate(axes):
        ax.imshow(samples[i][0], cmap='gray')
        ax.axis('off')
    plt.show()
在上述代码中,我们在潜在空间中随机采样10个点,然后将这些点输入到解码器中生成新的样本。最后,我们将生成的样本可视化展示出来,可以看到,生成的样本与MNIST数据集中的数字非常相似。
综上,我们介绍了VAE模型的原理、实现和应用,可以看到,VAE模型是一种非常强大的生成模型,可以学习到高维数据的潜在表示,并用潜在表示生成新的样本。
机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。
持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能

刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变

机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
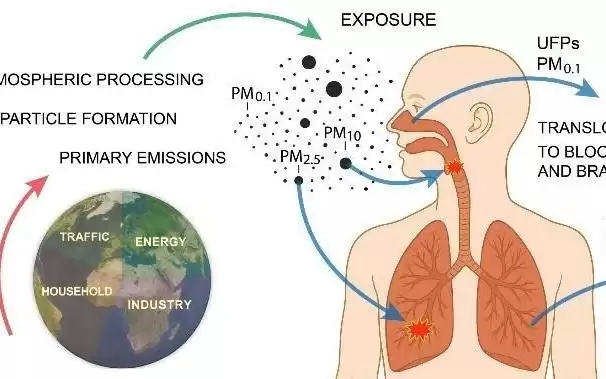
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
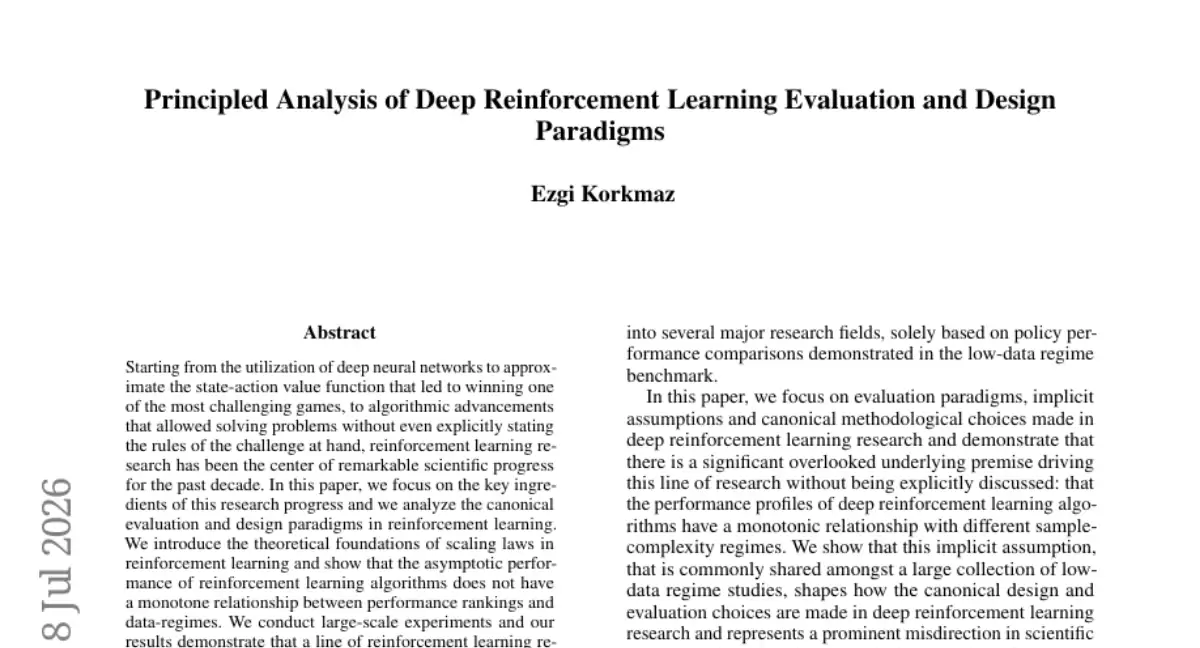
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化

机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。

少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。







Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
