

深入探讨零样本学习(ZSL)的定义和解读
零样本学习(ZSL)是一种机器学习范例,利用预先训练的深度学习模型来推广新类别的样本。它的核心思想是将已有的训练实例中的知识转移到测试实例的分类任务中。具体而言,零样本学习技术通过学习中间的语义层和属性,然后在推理过程中应用这些知识来预测新的数据。这种方法允许机器学习模型在没有先前见过的类别上进行分类,实现了对未知类别的识别能力。通过零样本学习,模型可以从有限的训练数据中获得更广泛的泛化能力,提高了在现实世界中面对新问题的适应性。需要注意,零样本学习中训练和测试集是不相交的。零样本学习是迁移学习的一个子领

零样本学习(ZSL)是一种机器学习范例,利用预先训练的深度学习模型来推广新类别的样本。它的核心思想是将已有的训练实例中的知识转移到测试实例的分类任务中。具体而言,零样本学习技术通过学习中间的语义层和属性,然后在推理过程中应用这些知识来预测新的数据。这种方法允许机器学习模型在没有先前见过的类别上进行分类,实现了对未知类别的识别能力。通过零样本学习,模型可以从有限的训练数据中获得更广泛的泛化能力,提高了在现实世界中面对新问题的适应性。
需要注意,零样本学习中训练和测试集是不相交的。
零样本学习是迁移学习的一个子领域,主要应用于特征和标签空间完全不同的情况。与常见的同构迁移学习不同,零样本学习不仅仅是微调预训练模型,它需要从无任何样本的情况下学习如何处理新的问题。零样本学习的目标是通过利用已有知识和经验,将这些知识迁移到新的领域中,以便解决新问题。这种异构迁移学习对于处理没有标签或很少标签的情况非常有用,因为它可以通过利用已有的标签信息,来进行预测和分类。因此,零样本学习具有很大的潜力,在许多现实世界的应用中发挥重要作用。
零样本学习数据分类
可见类(Seen Classes):用于训练深度学习模型的数据类,比如已标记的训练数据。
不可见类(Unseen Classes):现有深度模型需要概括的数据类,比如未被标记的训练数据。
辅助信息:由于没有属于不可见类的标记实例可用,因此需要一些辅助信息来解决零样本学习问题。此类辅助信息应包含所有不可见类的信息。
零样本学习还依赖于已标记的可见类和不可见类训练集。可见类和不可见类都在称为语义空间的高维向量空间中相关,其中来自可见类的知识可以转移到不可见类。
零样本学习的阶段
零样本学习涉及训练和推理的两个阶段:
训练:获取有关标记数据样本集的知识。
推理:扩展先前获得的知识,将提供的辅助信息用于新的类集。
零样本学习方法
基于分类器的方法
现有的基于分类器的方法通常采用一对多的解决方案来训练多类零样本分类器。也就是说,对于每个看不见的类,训练一个二进制的一对一分类器。根据构建分类器的方法,我们进一步将基于分类器的方法分为三类。
①对应方法
对应方法旨在通过每个类的二元一对一分类器与其对应的类原型之间的对应关系来构造不可见类的分类器。每个类在语义空间中只有一个对应的原型。因此,这个原型可以看作是这个类的“表示”。同时,在特征空间中,对于每一类,都有一个对应的二元一对一分类器,也可以看作是该类的“表征”。对应方法旨在学习这两种“表示”之间的对应函数。
②关系方法
方法旨在基于不可见类的类间和类内关系来构造分类器或不可见类。在特征空间中,可以利用可用数据学习所看到的类的二进制一对一分类器。同时,可以通过计算相应原型之间的关系来获得可见类和不可见类之间的关系。
③组合方法
组合方法描述了通过组合用于构成类的基本元素的分类器来为不可见类构造分类器的思想。
在组合方法中,认为存在一个构成类的“基本元素”列表。可见类和不可见类中的每个数据点都是这些基本元素的组合。体现在语义空间中,认为每个维度代表一个基本元素,每个类原型表示对应类的这些基本元素的组合。
类原型的每个维度取1或0,表示类是否具有相应的元素。因此,这一类方法主要适用于语义空间。
基于实例的方法
基于实例的方法旨在首先获得不可见类的标记实例,然后使用这些实例来训练零样本分类器。根据这些实例的来源,现有的基于实例的方法可以分为三个子类:
①投影方法
投影方法的思想是通过将特征空间实例和语义空间原型投影到共享空间中来获得不可见类的标记实例。
在属于可见类的特征空间中有标记的训练实例。同时,在语义空间中存在可见类和不可见类的原型。特征和语义空间是实数空间,实例和原型是其中的向量。从这个角度来看,原型也可以被视为带标签的实例。因此,我们在特征空间和语义空间中标记了实例。
②实例借用方法
这些方法通过从训练实例中借用来处理为不可见类获取标记实例。实例借用方法基于类之间的相似性。有了这些相似类的知识,就可以识别属于未见类的实例。
③合成方法
合成方法是通过使用不同的策略合成伪实例来获得不可见类的标记实例。为了合成伪实例,假定每个类的实例遵循某种分布。首先,需要估计不可见类的分布参数。然后,合成不可见类的实例。
零样本学习的局限
与其他概念一样,零样本学习也有其局限性。以下是在实践中应用零样本学习面临的一些最常见的挑战。
1.偏差
在训练阶段,模型只能访问可见类的数据和标签。这会使模型将测试期间不可见类的数据样本预测为可见类。如果在测试期间,模型对来自可见和不可见类的样本进行评估,则偏差问题会变得更加突出。
2.领域转移
零样本学习模型的开发主要是为了在这些数据逐渐可用时将预训练模型扩展到新类。因此,领域转移问题在零样本学习中很常见。当训练集和测试集中数据的统计分布明显不同时,会发生领域转移。
3.中心问题
中心问题与最近邻搜索相关的维数灾难有关。在零样本学习中,中心问题的发生有两个原因。
输入和语义特征都存在于高维空间中。当这样一个高维向量被投影到一个低维空间时,方差会减少,导致映射点被聚类为一个中心。
在零样本学习中广泛使用的岭回归会引发中心问题。它会导致预测出现偏差,即无论如何查询,大部分都只预测了几个类。
4.信息损失
在对可见类进行训练时,模型仅学习用于区分这些可见类的重要属性。而一些潜在信息可能存在于可见类中,如果它们对决策过程没有重大贡献,则不会被学习到。但是,此信息在不可见类的测试阶段很重要。这就会导致信息损失。
针对开发者关心的商汤大模型服务费用问题,本文详细梳理了免费试用资源的领取方式、按Token计费的阶梯价格以及企业级私有化部署的收费逻辑,帮助用户根据业务规模选择合适的使用方案。
机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。
持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科
当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变

机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
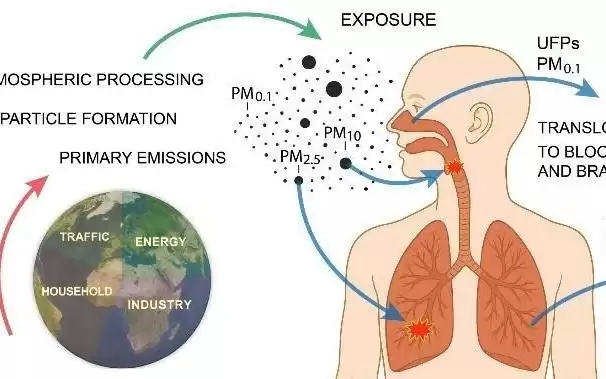
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
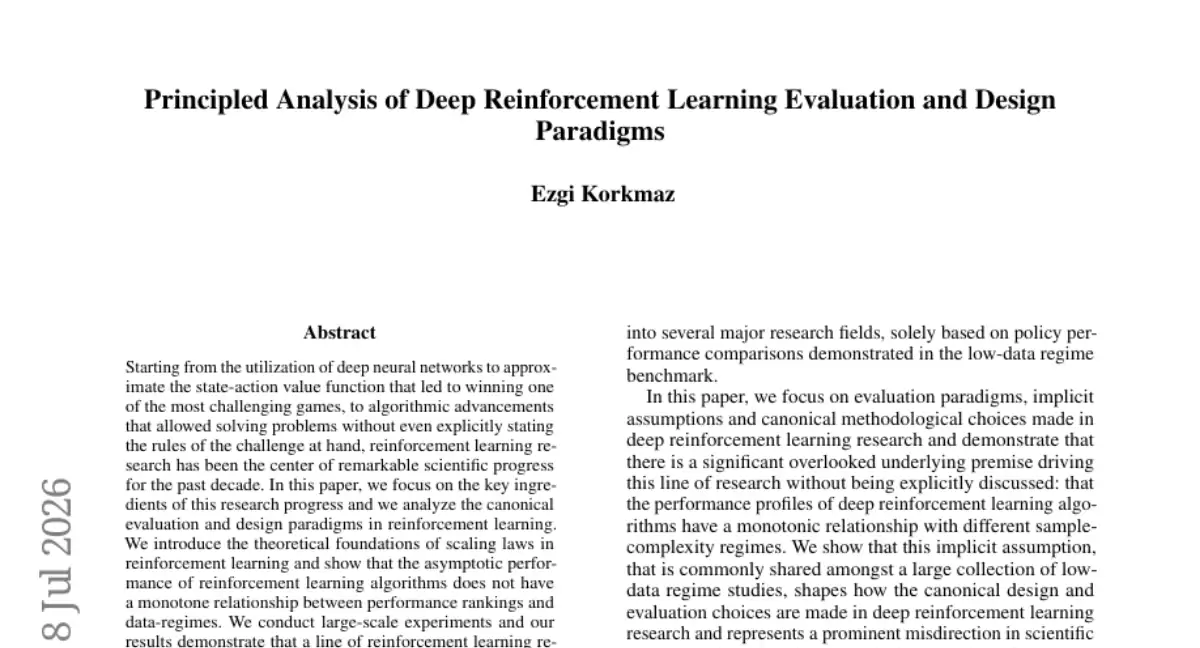
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化
机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。
少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。




WPS Office是一款面向macOS用户的综合办公套件,将文字处理、电子表格、演示文稿、PDF工具、模板与云协作整合在同一应用中。它兼容常见Microsoft Office格式,支持Intel及Apple芯片Mac,基础功能可免费使用,

Shapr3D是一款面向工业设计、机械工程、建筑概念和三维打印工作流的CAD软件。Mac版采用Parasolid建模内核,支持草图约束、实体建模、工程图、可视化渲染及常见CAD格式交换,并可通过账户在多台设备之间同步项目。

REAPER是Cockos开发的数字音频工作站,提供多轨音频与MIDI录制、剪辑、处理、混音和母带制作工具。Mac版兼容Intel与Apple芯片,支持AU、VST、VST3、CLAP等插件格式,并提供高度可定制的工作流程。

Adobe Photoshop 是面向摄影师、设计师和内容创作者的专业图像处理工具,可在 Windows 上完成照片修饰、选区抠图、图层合成、文字排版、绘画及生成式编辑。软件采用订阅授权,由 Creative Cloud 管理安装、更新与许

Adobe InDesign 是面向印刷与数字出版的专业页面排版工具,可制作书籍、杂志、宣传册、海报、交互式 PDF 和电子书。它提供精细的文字样式、多页面管理、印前检查及多格式输出能力,并能与 Photoshop、Illustrator

Adobe Illustrator 是用于绘制矢量图形、插画、图标、徽标和版式的专业设计工具。它以路径和锚点为核心,作品放大后仍能保持清晰,并提供画板、文字、渐变、图像描摹及精确变换等功能,适合品牌视觉、印刷物料、数字界面和商业插画创作。