

探讨pandas在数据清洗和预处理方面的应用方法
利用pandas进行数据清洗和预处理的方法探讨引言:在数据分析和机器学习中,数据的清洗和预处理是非常重要的步骤。而pandas作为Python中一个强大的数据处理库,具有丰富的功能和灵活的操作,能够帮助我们高效地进行数据清洗和预处理。本文将探讨几种常用的pandas方法,并提供相应的代码示例。一、数据读取首先,我们需要读取数据文件。pandas提供了许多函数
利用pandas进行数据清洗和预处理的方法探讨
引言:
在数据分析和机器学习中,数据的清洗和预处理是非常重要的步骤。而pandas作为Python中一个强大的数据处理库,具有丰富的功能和灵活的操作,能够帮助我们高效地进行数据清洗和预处理。本文将探讨几种常用的pandas方法,并提供相应的代码示例。
一、数据读取
首先,我们需要读取数据文件。pandas提供了许多函数来读取各种格式的数据文件,包括csv、Excel、SQL数据库等。以读取csv文件为例,可以使用read_csv()函数。
import pandas as pd

# 读取csv文件
df = pd.read_csv('data.csv')
二、数据观察
在进行数据清洗和预处理之前,我们需要先观察数据的整体情况。pandas提供了一些方法来快速查看数据的基本信息。
查看数据的前几行。
df.head()
查看数据的基本统计信息。
df.describe()
查看数据的列名。
df.columns
三、处理缺失值
处理缺失值是数据清洗的重要一步,而pandas提供了一些方法来处理缺失值。
判断缺失值。
df.isnull()
删除包含缺失值的行或列。
# 删除包含缺失值的行
df.dropna(axis=0)

# 删除包含缺失值的列
df.dropna(axis=1)
缺失值填充。
# 使用指定值填充缺失值
df.fillna(value)

# 使用均值填充缺失值
df.fillna(df.mean())
四、处理重复值
重复值会对数据分析和建模产生干扰,因此我们需要处理重复值。
判断重复值。
df.duplicated()
删除重复值。
df.drop_duplicates()
五、数据转换
数据转换是预处理的重要一环,pandas提供了很多方法来进行数据转换。
数据排序。
# 按某一列升序排序
df.sort_values(by='column_name')

# 按多列升序排序
df.sort_values(by=['column1', 'column2'])
数据归一化。
# 使用最小-最大缩放(Min-Max Scaling)
df_scaled = (df - df.min()) / (df.max() - df.min())
数据离散化。
# 使用等宽离散化(Equal Width Binning)
df['bin'] = pd.cut(df['column'], bins=5)
六、特征选择
根据任务的需要,我们需要选择合适的特征进行分析和建模。pandas提供了一些方法来进行特征选择。
按列选择特征。
# 根据列名选择特征
df[['column1', 'column2']]

# 根据列的位置选择特征
df.iloc[:, 2:4]
根据条件选择特征。
# 根据条件选择特征
df[df['column'] > 0]
七、数据合并
当我们需要合并多个数据集时,可以使用pandas提供的方法进行合并。
按行合并。
df1.append(df2)
按列合并。
pd.concat([df1, df2], axis=1)
八、数据保存
最后,当我们处理完数据后,可以将处理后的数据保存到文件中。
# 保存到csv文件
df.to_csv('processed_data.csv', index=False)

# 保存到Excel文件
df.to_excel('processed_data.xlsx', index=False)
结论:
本文介绍了利用pandas进行数据清洗和预处理的一些常用方法,包括数据读取、数据观察、处理缺失值、处理重复值、数据转换、特征选择、数据合并以及数据保存。通过pandas强大的功能和灵活的操作,我们能够高效地进行数据清洗和预处理,为后续的数据分析和建模打下坚实的基础。同学们在实际应用中可以根据具体的需求选择合适的方法,并结合实际代码进行使用。
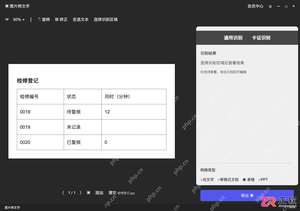
面向需要利用WPS AI从图片中提取结构化数据的办公用户,解决OCR识别中常见的字符误读、网格错位及数据类型丢失问题。本文以检修登记表为例,详解从原图矫正、相似字符(如0与O)排查、空白值与零值区分,到导出后设置文本格式及公式核验的全流程。通过规范图像预处理和严格的后期校验步骤,确保提取数据的准确性与可用性,避免前导零丢失或统计偏差。
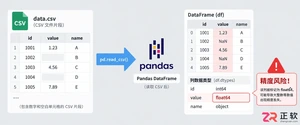
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
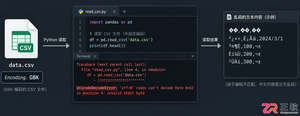
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
数据清洗中过度使用Stream操作会导致内存内耗严重,原因包括惰性求值引发全量物化、中间对象链加重GC负担、装箱拆箱使内存翻倍,以及分支反复遍历同一数据。传统循环仅占用恒定内存,建议采用按需供给、单次遍历和原生数组优化。
数据清洗中,文本格式不统一是常见难题。SUBSTITUTE函数能精准替换指定内容,适用于多种场景:可进行基础单次替换;通过参数选择替换第N次出现的字符;通过嵌套实现批量符号统一;结合CHAR函数清理不可见字符;其区分大小写的特性利于精准控制。掌握这些用法能有效解决多数文本清洗问题。
Excel透视表结果不对劲?十有八九是源数据在“捣鬼”。一套标准的“纠错六步法”送给你:先揪出错误数据,再清理那些看不见的字符,接着修复文本数字和混乱的日期格式,然后摆平缺失值和异常值,之后果断删除重复记录,最后别忘了刷新并验证你的透视表。 有没有遇到过这种情况?在Excel里埋头苦干,好不容易做出
选用 LongAdder 而非 AtomicInteger 是因高并发下其分段累加机制可避免 CAS 争抢,实测性能提升 5–8 倍;需在业务规则失败处统一调用 increment(),确保语义准确,并在任务完成后调用 sum() 获取最终值。 为什么不用 AtomicInteger 而选 Long
在数据清洗管道中实现“跳过错误记录+生成错误报告”双机制的方法是:1.在每个关键步骤使用try-except块捕获异常,确保流程不中断;2.在except块中记录错误信息至日志文件或数据库;3.通过continue或默认值跳过错误记录;4.将机制集成到所有数据转换环节;5.定期分析错误报告并优化清洗规则。对于错误报告格式,小数据量可选CSV/JSON,大数据量适合数据库表。在Spark中可通过try-except捕获异常并结合广播变量或mapPartitions方法收集错误信息。应对数据质量问题导致的数据
条件编译在C++中用于根据不同条件编译代码,适用于跨平台开发、调试和优化。使用方法包括:1.使用#ifdef、#ifndef等预处理指令控制代码编译。2.根据宏定义编译特定代码,如调试日志或不同平台的头文件。3.优化性能,如选择不同的数据结构。然而,需注意过度使用可能导致代码难以维护和测试,影响可移植性。
PHP数据清洗是将脏数据转换为干净数据的过程,脏数据包括格式不统一、缺失值、重复项、错误数据等。解决方案包括字符串处理(trim(),str_replace(),strtolower(),preg_replace())、数组操作(array_unique(),array_filter(),array_map())、类型转换(intval(),floatval(),strval())、数据验证(正则表达式或自定义函数)以及缺失值处理(isset(),empty())。针对乱码问题,需确保PHP文件、数据库和





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



