

abbyy finereader怎么加字体 字体导入与识别设置
是一种图片文字识别软件。FineReader提供快速、准确、方便的方式来扫描文件、PDF格式、数字或移动电话图像转换成可编辑的格式
解决 ABBYY FineReader PDF 找不到字体的问题。本教程详解如何在 Windows 系统中安装字体,并在 FineReader OCR 编辑器中设置输出字体,区分字体缺失与识别错误,确保文档排版与文字准确性。
在 ABBYY FineReader PDF 中遇到“找不到字体”或希望指定特定字体输出时,很多用户会尝试在软件内部寻找“导入字体”的按钮。实际上,FineReader 并不直接管理字体库,而是调用 Windows 系统已安装的字体。要实现自定义字体输出,关键在于先在 Windows 中完成字体安装,再在软件的 OCR 设置中指定该字体。这种做法能确保识别后的文本在导出为 Word 或 PDF 时保持预期的排版风格,同时避免因字体缺失导致的乱码或方框。
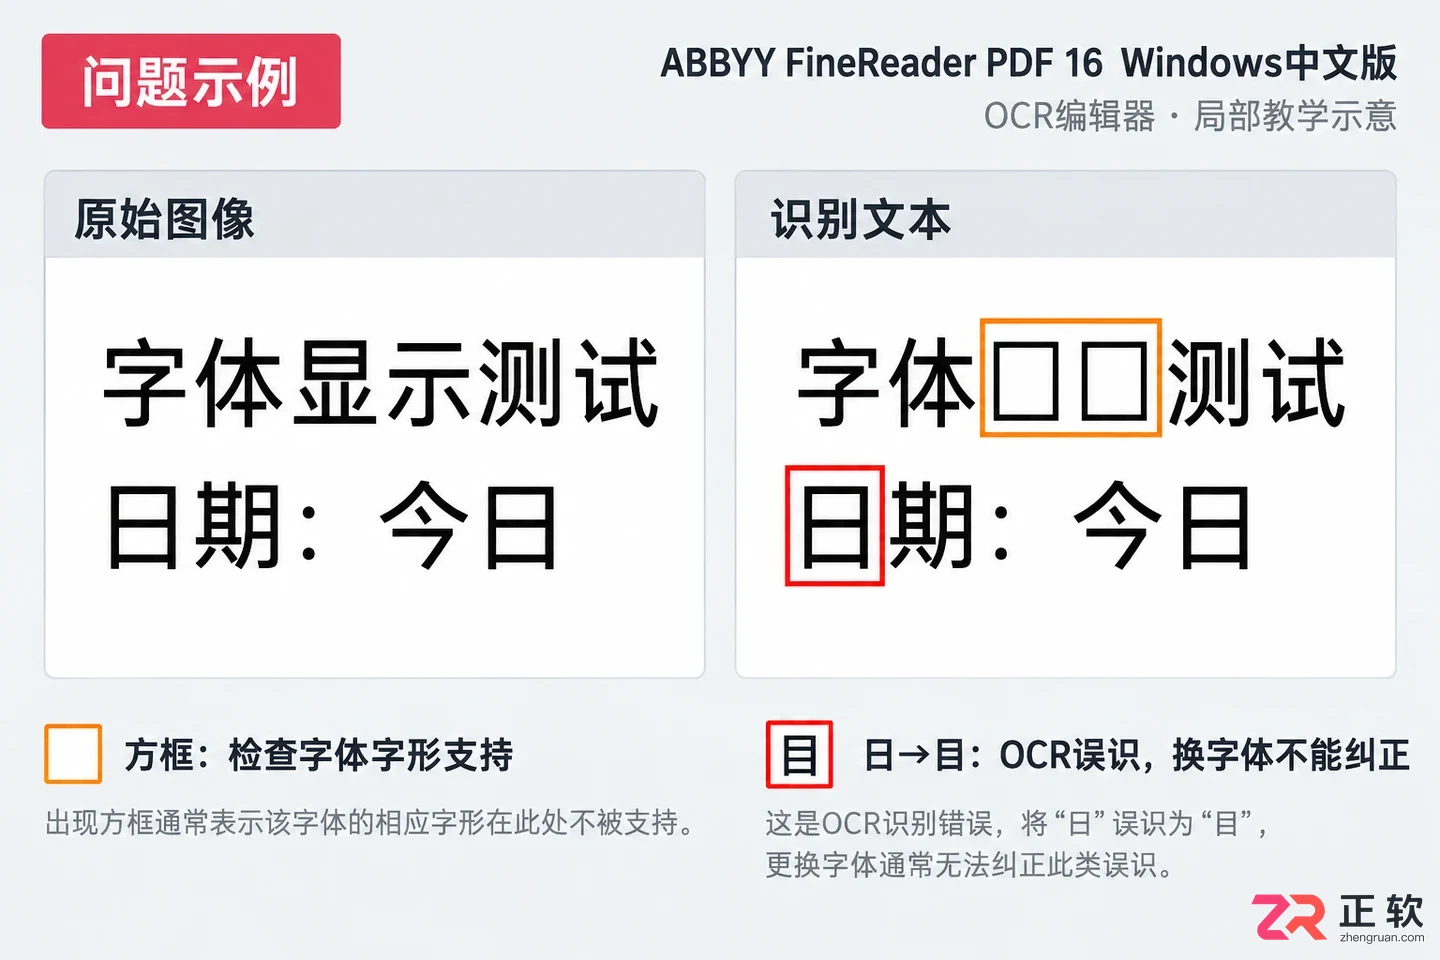
识别结果与原图对比:左侧为原扫描件,右侧为识别文本,高亮显示因字体缺失出现的方框及字符误识情况
需要明确的是,安装字体主要解决的是“字形显示”问题,而非“字符识别”准确率。如果原文是“日”,识别结果变成了“目”,这是 OCR 引擎对笔画的判断错误,更换字体无法修正;但如果识别内容正确,只是字形不符合要求或显示为方框,则通过以下步骤设置即可解决。
1. 在 Windows 系统中安装字体
FineReader 读取的是 Windows 系统的字体列表,因此第一步必须确保目标字体已正确安装在当前登录的用户账户下。
从合法渠道获取字体文件(通常为 .ttf 或 .otf 格式)。如果文件在压缩包内,请先解压到本地文件夹。在文件资源管理器中,右键点击字体文件,选择【安装】;或者双击打开字体预览窗口,点击顶部的【安装】按钮。
对于需要管理员权限的环境,可能需要确认 UAC 提示。安装完成后,建议打开 Windows 的【设置】>【个性化】>【字体】,搜索刚才安装的字体名称,确认其状态为“已安装”。注意,字体文件名可能与实际显示的字体家族名不同,后续在软件中查找时应使用家族名。
2. 重启 FineReader 并进入 OCR 编辑器
字体安装后,正在运行的 FineReader 可能无法立即刷新字体列表。保存当前工作,完全关闭 ABBYY FineReader PDF,然后重新启动软件。
打开包含测试扫描页的项目,进入【OCR 编辑器】界面。这是进行精细识别设置和排版调整的核心工作区。如果直接在主界面查看,可能无法访问详细的字体选择选项。
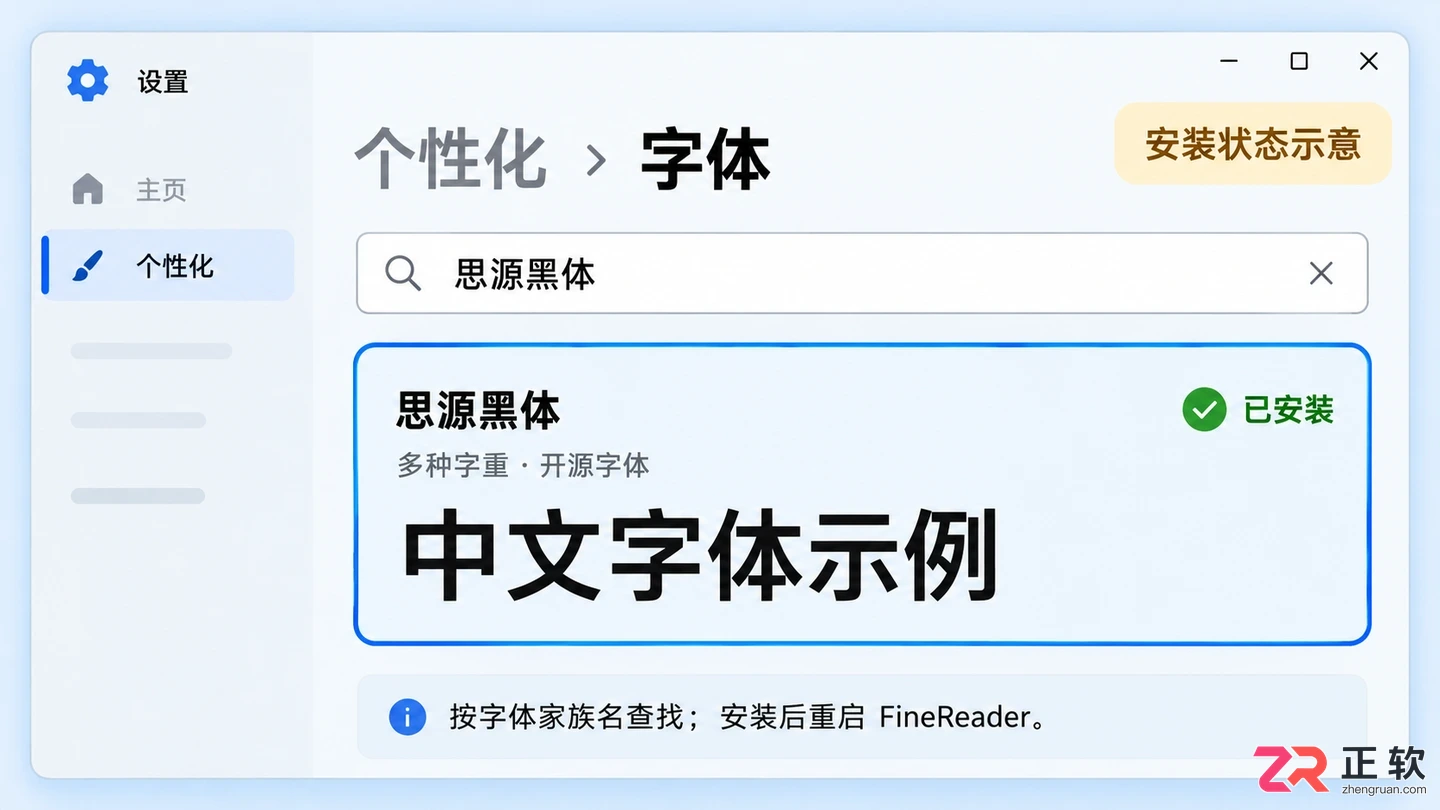
Windows 字体设置界面,确认目标字体已显示为“已安装”状态
3. 在选项中指定输出字体
在 OCR 编辑器中,点击菜单栏的【工具】,选择【选项】。在弹出的对话框中,切换到【OCR】选项卡。
找到【字体】区域,点击【选择字体】按钮。此时会弹出一个字体列表窗口,这里列出了所有 Windows 系统可用且 FineReader 支持的字体。在列表中找到你刚才安装的新字体,选中它并点击【确定】。
请注意,这里选择的字体将作为识别结果的默认输出字体。这并不会改变原始扫描图像的外观,而是决定当你把识别结果导出为可编辑文档(如 DOCX)时,文字所使用的字形。
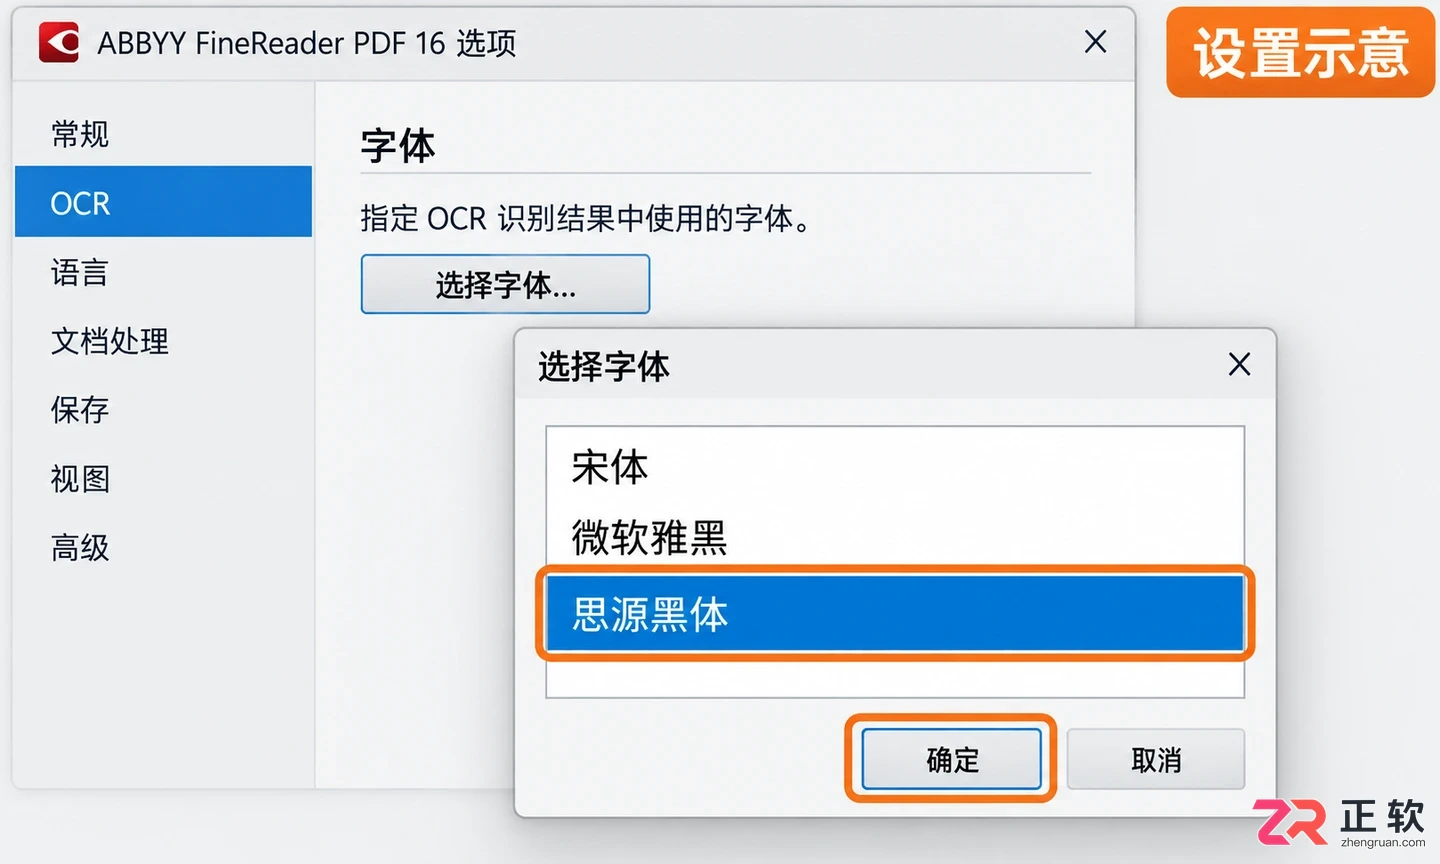
在【工具】>【选项】>【OCR】选项卡中点击【选择字体】,从系统列表中选取新安装的字体
如果列表中仍未出现新字体,请返回 Windows 字体设置检查安装是否成功,或确认字体格式是否为 FineReader 支持的 TrueType 或 OpenType。不要尝试将字体文件复制到 FineReader 的安装目录,这种操作无效且可能导致软件不稳定。
4. 核对语言设置并重新识别
字体设置完成后,必须重新执行识别操作才能生效。在重新识别前,务必检查【文档语言】设置。例如,中文文档中夹杂英文和数字时,应选择“中文+英文”或相应的混合语言包。仅更改字体不会自动纠正因语言包选择错误导致的识别偏差。
选中需要处理的页面或文本块,点击【重新识别】。软件会使用新的字体设置和语言配置生成文本层。
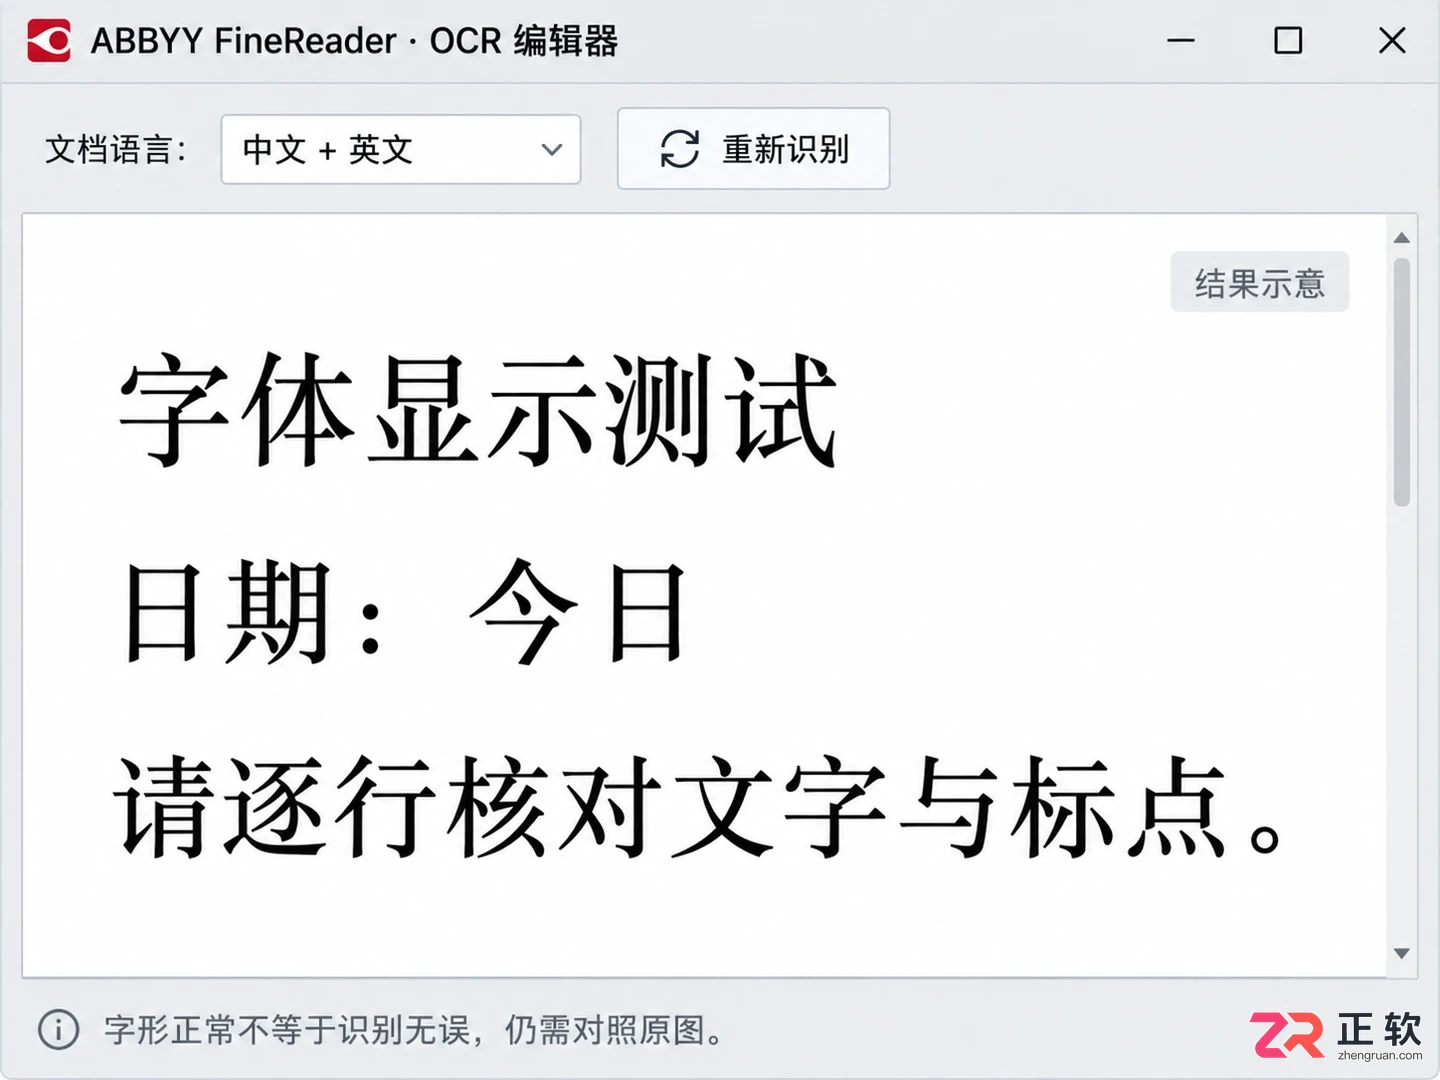
重新识别后,文本使用了指定字体,字形显示正常且无乱码
识别完成后,逐行对照原图与识别结果。重点检查生僻字、标点符号以及数字。此时应确认两点:一是文字内容是否准确(排除 OCR 误识),二是字形是否符合预期(排除字体缺失)。如果发现特定字符仍显示为方框,可能是该字体本身不包含这些字符的字形,需更换支持更全的字体家族。
5. 区分字体设置与 OCR 训练
在处理特殊符号、装饰性字形或手写体时,用户可能会混淆“添加字体”与“OCR 训练”。FineReader 中的【使用训练以识别新字符】功能,是通过提供样本来教引擎识别未知的字形结构,这与安装 TTF/OTF 字体是完全不同的两个概念。
对于清晰的印刷体文档,通常不需要启用训练功能。如果反复出现相同的特殊字符识别错误,应先检查扫描分辨率和图像清晰度,再考虑是否使用训练工具。错误地启用训练或使用未校对的样本,反而可能污染识别引擎,导致后续页面出现更多错误。
6. 导出验证与文件保留
最后,将识别结果导出为需要的格式(如 Microsoft Word 或 PDF)。打开导出的文件,检查目标字体是否被正确应用,段落排版和换行是否在可接受范围内。不同的输出格式对字体的嵌入和支持能力不同,建议在最终分发前进行预览。
如果文档需要在其他电脑上编辑,请确保对方电脑也安装了相同的字体,或者在导出 PDF 时选择嵌入字体(需遵守字体许可协议)。保留原始的扫描件、FineReader 项目文件(.frdoc)以及最终导出的副本,以便日后修改或追溯。至此,字体添加与设置流程完成,既保证了视觉效果的统一,又确保了文字内容的可编辑性。
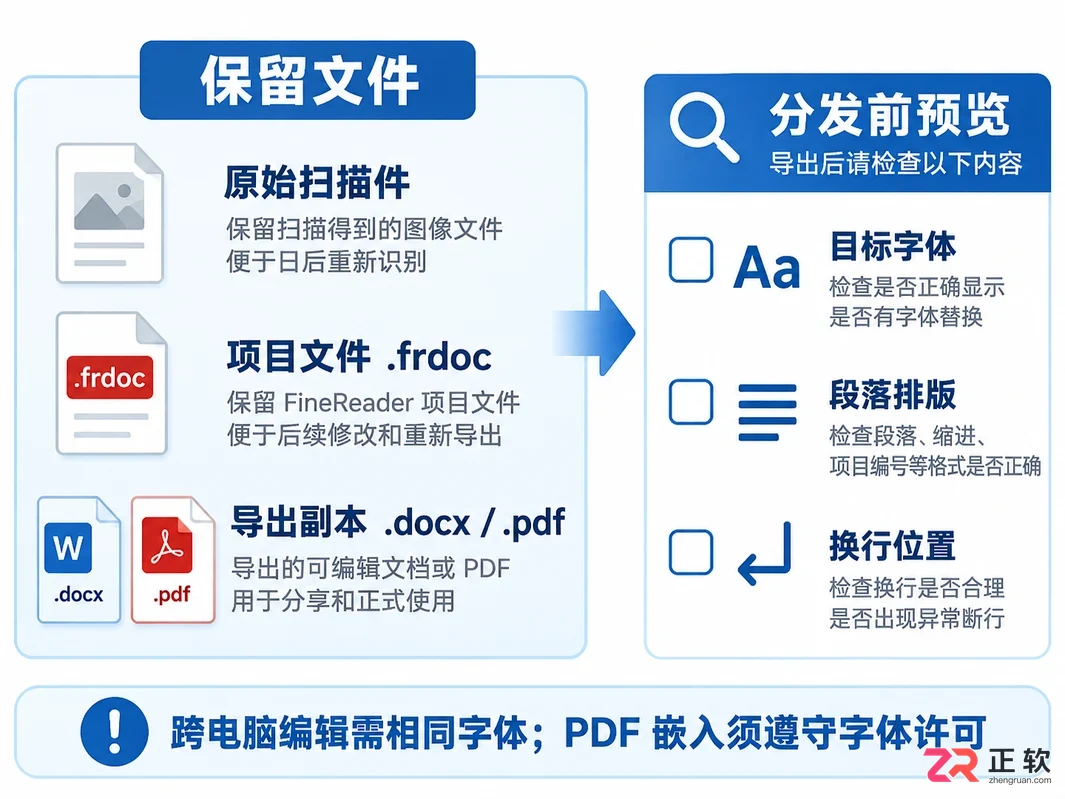
6. 导出验证与文件保留
面向寻求免费正版阅读体验的用户,番茄小说提供海量玄幻、言情等题材网文,支持离线下载与多端同步。针对无法注册、登录方式受限及本地书导入等常见痛点,本文详解安卓最新版v7.0.3.32的下载安装步骤、离线缓存操作、本地TXT导入方法以及账号异常排查指南,帮助用户快速上手并享受无广告干扰的沉浸式阅读。
在Xshell终端中通过SSH连接Linux服务器,学习使用mkdir命令创建目录。包含确认当前路径、创建多层子目录、处理特殊命名及权限错误排查的详细步骤。
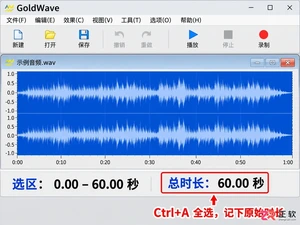
学习如何在 GoldWave 中将音乐速度降低至 80% 并保存。涵盖临时试听调速、时间伸缩效果设置、Similarity 与 FFT 算法选择及结果验证,适合制作慢速练习音频。
面向使用Luminar Neo进行人像精修的用户,解决衣物左右不对称及褶皱明显的痛点。本文介绍利用仿制工具微调衣物形状以实现视觉对称的操作步骤,并详解通过降低阴影饱和度、调整结构AI减弱纹理对比,以及结合仿制工具覆盖深层褶皱的两种去皱方案,帮助用户在无需切换软件的情况下提升画面质感。
面向需要高精度导航与实景浏览的用户,介绍谷歌地图的核心价值。针对日常出行中定位不准、路况不明及隐私数据残留痛点,本文详解其多模式视图、智能路线规划及实时路况更新功能。重点提供删除搜索历史记录的具体操作路径,涵盖从进入设置到选择时间范围清除数据的完整步骤,帮助用户在享受便捷导航的同时有效管理个人隐私。
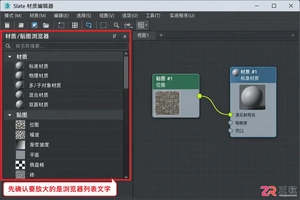
3ds Max材质编辑器中的文字看不清?本教程教你区分是面板太窄还是系统缩放过低,通过调整Windows显示设置和优化界面布局,让材质贴图浏览器的字体清晰易读,同时避免界面错位。
处理PDF复制数学公式变乱码,需先公式复制失败常因为符号使用专用字体或没有正确Unicode映射。本文结合真实步骤图说明分别复制普通文字与公式,确认问题只发生在数学符号、少量公式用Word公式或LaTeX重建,不要继续用乱码字符、大量公式使用数学OCR,对上下标、分数、根号和矩阵逐项校对,并补。
深入解析 Node.js 20 原生内置 .env 文件支持的工作机制,详解命令行系统环境变量、多文件覆盖、代码运行时赋值与默认兜底的完整优先级规则及实际工程应用。
在Windows版Photoshop中,如果画笔工具只能画画却看不到笔尖圆圈,可能是Caps Lock开启了精确光标模式,或者首选项中的绘画光标被设为“标准”。本文详解如何恢复正常的笔刷轮廓显示。
学习使用 ABBYY FineReader PDF 16 将多张 JPG 图片一次性转换为单个多页 PDF。涵盖文件排序、合并设置、OCR 语言选择及结果验证步骤,确保输出文档清晰且可搜索。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



