

使用机器学习数据探索和可视化技巧来分析图像中物体检测的数据
近年来,人们对深入理解机器学习数据(ML-data)的重要性有了更深刻的认识。然而,由于检测大型数据集通常需要大量的人力和物力投入,因此在计算机视觉领域的广泛应用仍然需要进一步的开发。通常,在物体检测(ObjectDetection,属于计算机视觉的一个子集)中,通过定义边界框,来定位图像中的物体,不仅可以识别物体,还能够了解物体的上下文、大小、以及与场景中其他元素的关系。同时,针对类的分布、物体大小的多样性、以及类出现的常见环境进行全面了解,也有助于在评估和调试中发现训练模型中的错误模式,从而更有针对性
近年来,人们对深入理解机器学习数据(ML-data)的重要性有了更深刻的认识。然而,由于检测大型数据集通常需要大量的人力和物力投入,因此在计算机视觉领域的广泛应用仍然需要进一步的开发。
通常,在物体检测(Object Detection,属于计算机视觉的一个子集)中,通过定义边界框,来定位图像中的物体,不仅可以识别物体,还能够了解物体的上下文、大小、以及与场景中其他元素的关系。同时,针对类的分布、物体大小的多样性、以及类出现的常见环境进行全面了解,也有助于在评估和调试中发现训练模型中的错误模式,从而更有针对性地选择额外的训练数据。
在实践中,我往往会采取如下方法:
- 利用预训练的模型或基础模型的增强功能,为数据添加结构。例如:创建各种图像嵌入,并采用 t-SNE 或 UMAP 等降维技术。这些都可以生成相似性的地图,从而方便数据的浏览。此外,使用预先训练的模型进行检测,也可以方便提取上下文。
- 使用能够将此类结构与原始数据的统计和审查功能整合在一起的可视化工具。
下面,我将介绍如何使用Renumics Spotlight,来创建交互式的对象检测可视化。作为示例,我将试着:
- 为图像中的人物探测器建立可视化。
- 可视化包括相似性地图、筛选器和统计数据,以便浏览数据。
- 通过地面实况(Ground Truth)和 Ultralytics YOLOv8 的检测详细,查看每一张图像。

在Renumics Spotlight上的目标可视化。资料来源:作者创建
下载COCO数据集中的人物图像
首先,通过如下命令安装所需的软件包:
!pip install fiftyone ultralytics renumics-spotlight
利用FiftyOne的可恢复性下载功能,您可以从COCO 数据集处下载各种图像。通过简单的参数设置,我们即可下载包含一到多个人物的 1,000 幅图像。具体代码如下:
importpandasaspdimportnumpyasnpimportfiftyone.zooasfoz# 从 COCO 数据集中下载 1000 张带人的图像dataset = foz.load_zoo_dataset( "coco-2017"、split="validation"、label_types=[ "detections"、],classes=["person"]、 max_samples=1000、dataset_name="coco-2017-person-1k-validations"、)
接着,您可以使用如下代码:
def xywh_too_xyxyn(bbox): "" convert from xywh to xyxyn format """ return[bbox[0], bbox[1], bbox[0] + bbox[2], bbox[1] + bbox[3]].行 = []fori, samplein enumerate(dataset):labels = [detection.labelfordetectioninsample.ground_truth.detections] bboxs = [...bboxs = [xywh_too_xyxyn(detection.bounding_box) fordetectioninsample.ground_truth.detections]bboxs_persons = [bboxforbbox, labelin zip(bboxs, labels)iflabel =="person"] 行。row.append([sample.filepath, labels, bboxs, bboxs_persons])df = pd.DataFrame(row, columns=["filepath","categories", "bboxs", "bboxs_persons"])df["major_category"] = df["categories"].apply( lambdax:max(set(x) -set(["person"]), key=x.count) if len(set(x)) >1 else "only person"。)
将数据准备为 Pandas DataFrame,其中的列包括有:文件路径、边框盒(bounding boxe)类别、边框盒、边框盒包含的人物、以及主要类别(尽管有人物),以指定图像中人物的上下文:

然后,您可以通过 Spotlight 将其可视化:
From renumics import spotlightspotlight.show(df)
您可以使用检查器视图中的添加视图按钮,并在边框视图中选择bboxs_persons和filepath,以显示带有图像的相应边框:

嵌入丰富的数据
要使得数据具有结构性,我们可以采用各种基础模型的图像嵌入(即:密集向量表示)。为此,您可以使用 UMAP 或 t-SNE 等进一步降维技术,将整个图像的Vision Transformer(ViT)嵌入应用到数据集的结构化,从而提供图像的二维相似性图。此外,您还可以使用预训练对象检测器的输出结果,按照包含对象的大小或数量,对数据进行分类,进而构建数据。由于 COCO 数据集已经提供了此方面的信息,因此我们完全可以直接使用它。
由于Spotlight 集成了对google/vit-base-patch16-224-in21k(ViT)模型和UMAP 的支持,因此当您使用文件路径创建各种嵌入时,它将会被自动应用:
spotlight.show(df, embed=["filepath"])
通过上述代码,Spotlight 将各种嵌入进行计算,并应用 UMAP 在相似性地图中显示结果。其中,不同的颜色代表了主要的类别。据此,您可以使用相似性地图来浏览数据:

预训练YOLOv8的结果
可用于快速识别物体的Ultralytics YOLOv8,是一套先进的物体检测模型。它专为快速图像处理而设计,适用于各种实时检测任务,特别是在被应用于大量数据时,用户无需浪费太多的等待时间。
为此,您可以首先加载预训练模型:
From ultralytics import YOLOdetection_model = YOLO("yolov8n.pt")并执行各种检测:
detections = []forfilepathindf["filepath"].tolist():detection = detection_model(filepath)[0]detections.append({ "yolo_bboxs":[np.array(box.xyxyn.tolist())[0]forboxindetection.boxes]、 "yolo_conf_persons": np.mean([np.array(box.conf.tolist())[0]. forboxindetection.boxes ifdetection.names[int(box.cls)] =="person"]), np.mean(]), "yolo_bboxs_persons":[np.array(box.xyxyn.tolist())[0] forboxindetection.boxes ifdetection.names[int(box.cls)] =="person],"yolo_categories": np.array([np.array(detection.names[int(box.cls)])forboxindetection.boxes], "yolo_categories": np.array(),})df_yolo = pd.DataFrame(detections)在12gb的GeForce RTX 4070 Ti上,上述过程在不到20秒的时间内便可完成。接着,您可以将结果包含在DataFrame中,并使用Spotlight将其可视化。请参考如下代码:
df_merged = pd.concat([df, df_yolo], axis=1)spotlight.show(df_merged, embed=["filepath"])
下一步,Spotlight将再次计算各种嵌入,并应用UMAP到相似度图中显示结果。不过这一次,您可以为检测到的对象选择模型的置信度,并使用相似度图在置信度较低的集群中导航检索。毕竟,鉴于这些图像的模型是不确定的,因此它们通常有一定的相似度。

当然,上述简短的分析也表明了,此类模型在如下场景中会遇到系统性的问题:
- 由于列车体积庞大,站在车厢外的人显得非常渺小
- 对于巴士和其他大型车辆而言,车内的人员几乎看不到
- 有人站在飞机的外面
- 食物的特写图片上有人的手或手指
您可以判断这些问题是否真的会影响您的人员检测目标,如果是的话,则应考虑使用额外的训练数据,来增强数据集,以优化模型在这些特定场景中的性能。
小结
综上所述,预训练模型和 Spotlight 等工具的使用,可以让我们的对象检测可视化过程变得更加容易,进而增强数据科学的工作流程。您可以使用自己的数据去尝试和体验上述代码。
译者介绍
陈峻(Julian Chen),51CTO社区编辑,具有十多年的IT项目实施经验,善于对内外部资源与风险实施管控,专注传播网络与信息安全知识与经验。
原文标题:How to Explore and Visualize ML-Data for Object Detection in Images,作者:Markus Stoll
链接:https://itnext.io/how-to-explore-and-visualize-ml-data-for-object-detection-in-images-88e074f46361。
机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。
持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能

刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变

机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
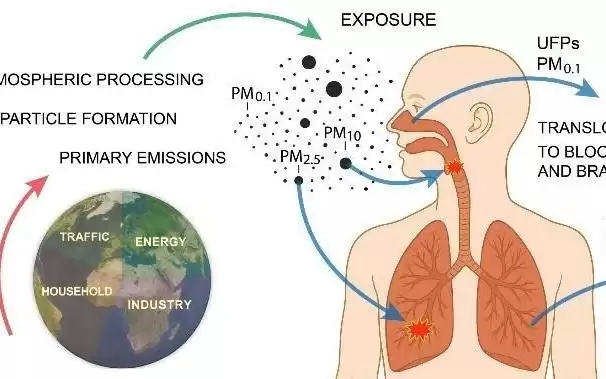
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
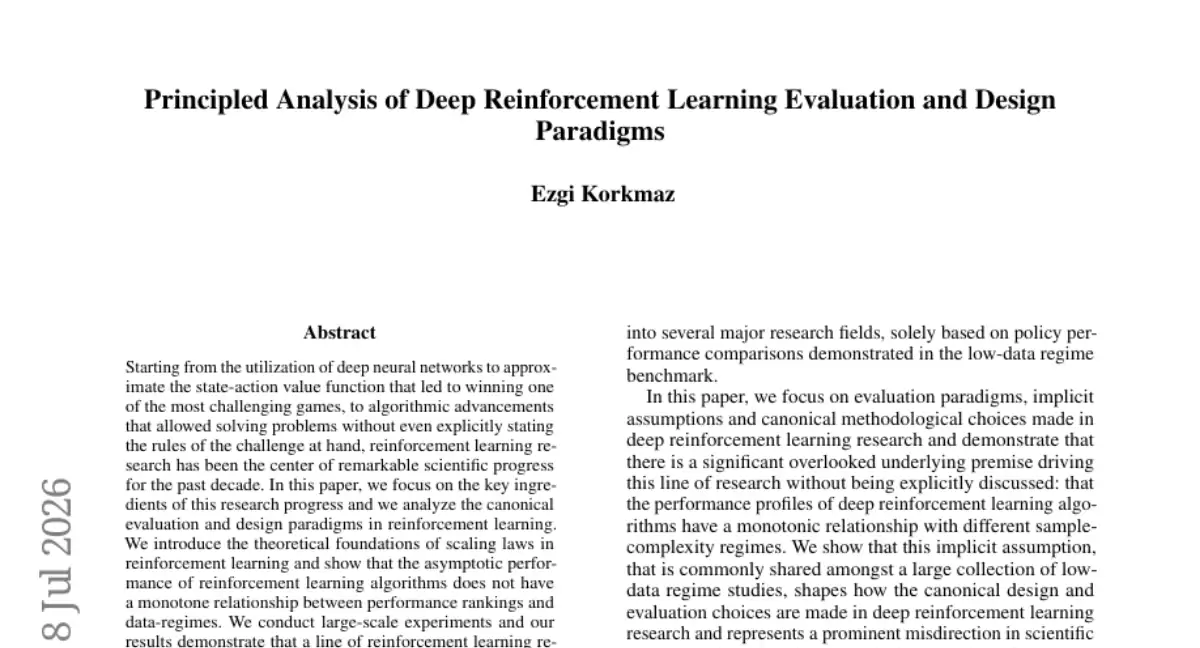
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化

机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。

少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。







Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
