

Blackwell
OGS团队使用影驰HOFOCLAB版RTX5090D,更换晶振并液氮冷却,核心频率达4002MHz,成为Blackwell架构首款破4GHz显卡,GPUPI测试以35.377秒刷新纪录。
英伟达在犹他州完成测试,将BlackwellAI芯片与瓦拉公司Ward250反应堆对接供电,验证了核能作为算力基荷能源的技术可行性。该反应堆额定热功率100千瓦,峰值250千瓦,仅能支撑不到一个标准AI机架,属原理验证。双方计划建设小型数据中心,探索核能供电与闭环液冷技术。
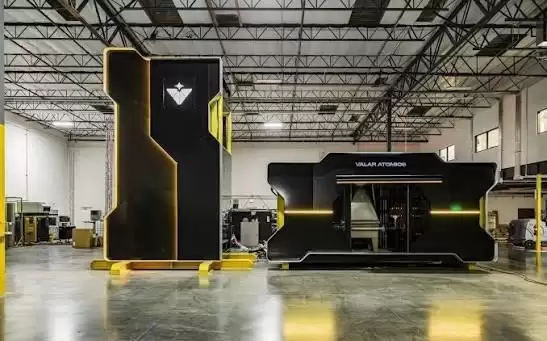
美国核能初创公司Valar在犹他州用Ward250先进反应堆为英伟达Blackwell芯片供电,系美国首次。双方计划共建小型数据中心,验证核能供电与闭环液冷技术以摆脱电网和水资源依赖。该反应堆已临界,但行业仍处起步阶段,尚无商业运营。
人工智能云计算公司科维克斯签署多年期协议,为领先人工智能企业提供搭载英伟达布莱克威尔图形处理器及量子二号无限带宽网络的集群,股价盘前一度飙升近百分之百,凸显顶级人工智能算力资源稀缺性。
苹果公司计划于2028年推出M7Ultra芯片,配备最高一点五太字节统一内存,AI性能对标Blackwell架构,内存带宽或突破每秒一太字节。为适应高功耗,MacStudio将大幅重构内部结构与散热系统,但发货时间受内存芯片供应制约。
英伟达持续优化Blackwell平台,GB200NVL72运行DeepSeekR1模型每兆瓦吞吐量三个月翻4倍,优化成果可跨模型复用。GB300训练性能六个月提升1.5倍,扩展效率接近理论上限。新一代Rubin平台加速部署,软件优化延长了硬件生命周期。
Cursor团队在BlackwellGPU上重构MoE生成机制,采用输出中心的WarpDecode,绕过传统专家中心路径的内存低效,实现高效推理。推理速度提升至1.84倍,吞吐量达到118-121tokens/s,输出精度接近FP32标准,提升至1.4倍。该成果显著优化了模型部署效率与性能。
联想发布ThinkStationP4工作站,首次将AMD3DV-Cache技术引入专业领域。该产品搭载AMD锐龙Pro9000系列处理器与NVIDIARTXPro6000Blackwell专业显卡,采用液冷散热,支持256GBDDR5内存及多硬盘扩展。其紧凑机身兼顾高性能与低噪音,并通过多项专业软件认证与环保标准,面向工程、设计及AI密集型应用。


火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。




