

Rubin备受期待之际,英伟达持续优化Blackwell,GB200能效三个月翻4倍
英伟达持续优化Blackwell平台,GB200NVL72运行DeepSeekR1模型每兆瓦吞吐量三个月翻4倍,优化成果可跨模型复用。GB300训练性能六个月提升1.5倍,扩展效率接近理论上限。新一代Rubin平台加速部署,软件优化延长了硬件生命周期。
英伟达正在用一套持续的软件栈优化,给Blackwell平台“续命”——在延长其生命周期、让老客户不急着换代的同时,也为下一代Rubin架构的规模化落地悄悄蓄力。
就在新一代Rubin平台加速部署的当口,英伟达透露了一个相当亮眼的数据:仅用三个月,GB200 NVL72在运行DeepSeek R1 0528模型时的每兆瓦算力吞吐量(TPS/MW)就翻了4倍。这背后,是四个月内完成的38项重大优化,超过25万次模拟配置筛选,以及累计140万GPU小时的实测验证。
与此同时,GB300“Blackwell Ultra”平台在AI训练基准测试中也拿出了新纪录。256卡规模下,GB300 NVL72在DeepSeek-V3 671B预训练任务中,达到了每GPU 1648 TFLOPs的吞吐量——这不仅是全球最高,还比GB200的606 TFLOPs提升了约3倍。更值得留意的是,这个数字在过去六个月里,已经累计增长了1.5倍。
GB200能效大幅跃升,优化覆盖90%以上模型
具体到GB200 NVL72,英伟达表示,针对该平台的系列优化,使其在运行DeepSeek R1 0528(1K输入/1K输出配置)时,每兆瓦算力吞吐量在三个月内实现了4倍增长。
支撑这一提升的,是四个月内完成的38项重大优化迭代。这些优化经过超过25万次模拟配置筛选,并累计消耗140万GPU小时进行实测验证。英伟达特别指出,其中超过90%的优化成果可以跨模型复用,适用于其AI产品组合中的其他模型,并非专为单一任务量身定制。
这意味着什么?现有数据中心客户无需更换硬件,只需要通过软件升级,就能获得显著的能效收益。对于算力成本高度敏感的超大规模云厂商和企业客户来说,这显然具有直接的经济价值。
GB300刷新训练纪录,六个月性能提升1.5倍
在AI训练侧,GB300 NVL72同样展现出了强劲的性能势头。256卡规模下,基于Megatron Core框架对DeepSeek-V3 671B模型进行预训练,GB300 NVL72实现了每GPU 1648 TFLOPs的吞吐量,较此前GB200的606 TFLOPs提升约3倍,并创下该任务的全球最高纪录。
更值得关注的是,这一数字并非静止的硬件极限。GB300 NVL72在Megatron Core框架下的表现,已从2025年11月的1088 TFLOPs/GPU增长至2026年6月的1648 TFLOPs/GPU,六个月内累计提升约1.5倍。
在主流AI框架的协同优化方面,英伟达与PyTorch及JAX社区的深度合作同样带来了显著增益。在TorchTitan(PyTorch原生训练栈)上,GB300 NVL72对DeepSeek-V3 671B的训练性能,相较未优化基线配置提升了6倍——从199 TFLOPs/GPU跃升至1197 TFLOPs/GPU。JAX框架下的提升幅度更为突出,截至2026年7月,每GPU吞吐量达到4082 Tokens/s,对应1025 TFLOPs/GPU,较2026年1月的418 Tokens/s提升了约10倍。
扩展效率接近理论上限,800 Gb/s网络是关键
大规模训练场景下的扩展效率,历来是衡量AI基础设施实用性的核心指标之一。英伟达披露,在256至1024卡的扩展区间内,GB300 NVL72在三大主流框架下均维持了接近理论上限的扩展效率:Megatron Core达到98.5%,TorchTitan与JAX均达到97%。
英伟达将这一扩展表现归因于NVL72机架内置的800 Gb/s Scale-Out网络芯片。高速互联直接决定了多机训练中的通信开销,进而影响整体扩展效率。可以说,这个网络能力,是支撑上述跨框架高效率表现的核心基础设施组件。
Rubin平台加速落地,Blackwell优化仍在持续
上述优化进展发布之际,英伟达的下一代Vera Rubin平台已进入全球部署阶段。据报道,Vera Rubin NVL72在Token吞吐量上相较Blackwell实现了约10倍提升——GB200 NVL72约为80,000 Tokens/s,而Vera Rubin NVL72在同等150MW功耗下可达800,000 Tokens/s。
不过,Blackwell平台已经在全球无数数据中心完成了部署。英伟达的策略,其实与之前Hopper世代如出一辙:在新平台推进的同时,持续通过软件优化挖掘已部署硬件的潜力。这样做的逻辑很清晰——不仅延长了现有客户的硬件投资回报周期,也进一步强化了英伟达在AI基础设施生态中的平台黏性。对于市场而言,在Blackwell与Rubin双线并进的格局下,英伟达正在逐步构筑起一道竞争对手难以在短期内逾越的软件护城河。
OGS团队使用影驰HOFOCLAB版RTX5090D,更换晶振并液氮冷却,核心频率达4002MHz,成为Blackwell架构首款破4GHz显卡,GPUPI测试以35.377秒刷新纪录。
英伟达在犹他州完成测试,将BlackwellAI芯片与瓦拉公司Ward250反应堆对接供电,验证了核能作为算力基荷能源的技术可行性。该反应堆额定热功率100千瓦,峰值250千瓦,仅能支撑不到一个标准AI机架,属原理验证。双方计划建设小型数据中心,探索核能供电与闭环液冷技术。
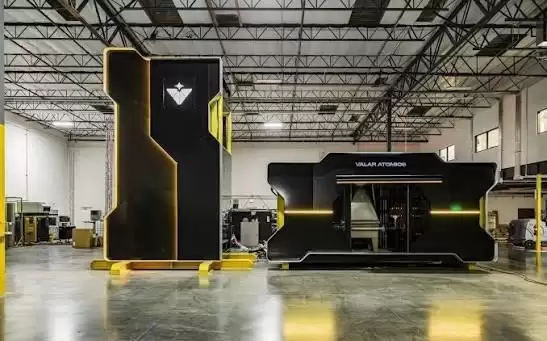
美国核能初创公司Valar在犹他州用Ward250先进反应堆为英伟达Blackwell芯片供电,系美国首次。双方计划共建小型数据中心,验证核能供电与闭环液冷技术以摆脱电网和水资源依赖。该反应堆已临界,但行业仍处起步阶段,尚无商业运营。
人工智能云计算公司科维克斯签署多年期协议,为领先人工智能企业提供搭载英伟达布莱克威尔图形处理器及量子二号无限带宽网络的集群,股价盘前一度飙升近百分之百,凸显顶级人工智能算力资源稀缺性。
苹果公司计划于2028年推出M7Ultra芯片,配备最高一点五太字节统一内存,AI性能对标Blackwell架构,内存带宽或突破每秒一太字节。为适应高功耗,MacStudio将大幅重构内部结构与散热系统,但发货时间受内存芯片供应制约。
Cursor团队在BlackwellGPU上重构MoE生成机制,采用输出中心的WarpDecode,绕过传统专家中心路径的内存低效,实现高效推理。推理速度提升至1.84倍,吞吐量达到118-121tokens/s,输出精度接近FP32标准,提升至1.4倍。该成果显著优化了模型部署效率与性能。
联想发布ThinkStationP4工作站,首次将AMD3DV-Cache技术引入专业领域。该产品搭载AMD锐龙Pro9000系列处理器与NVIDIARTXPro6000Blackwell专业显卡,采用液冷散热,支持256GBDDR5内存及多硬盘扩展。其紧凑机身兼顾高性能与低噪音,并通过多项专业软件认证与环保标准,面向工程、设计及AI密集型应用。
梳理苹果10月Mac与iPad新品的配置线索,包括触屏MacBook Pro的OLED屏幕与M5芯片、iMac的4.5K显示升级及iPad mini的存储选项,为选购提供参考。
华为Mate 70 Pro开箱要看哪些细节?查看包装型号与HarmonyOS标识、机身外观和欢迎语言界面,并通过华为官方产品入口核对信息。
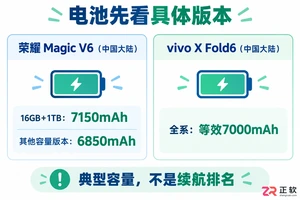
面对荣耀Magic V6和vivo X Fold6两款主流横向大折叠旗舰,参数表往往让人眼花缭乱。本文不堆砌数据,而是聚焦影像拍摄习惯、不同存储版本的电池容量真相以及多窗口软件适配的实际操作。通过具体的场景化对比和到店体验建议,帮助你在购买前理清核心差异,避免被单一参数误导,做出更符合个人使用习惯的选择。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



