

量子机器学习:新手指南
译者|布加迪审校|孙淑娟简介欢迎来到量子机器学习世界!本教程将通过一个使用示例数据集的入门级项目,提供附有代码的分步走指导。本教程结束时,您将对如何使用量子计算机来执行机器学习任务有一番基本的理解,并帮助构建您的第一个量子模型。但在深入学习本教程之前,先了解量子机器学习是什么、它为什么如此令人兴奋。量子机器学习是量子计算和机器学习交汇的领域。它使用量子计算机来执行机器学习任务,比如分类、回归和聚类。量子计算机是一种功能强大的机器,使用量子比特(量子位)而不是传统比特来存储和处理信息。这使得它们执
译者 | 布加迪
审校 | 孙淑娟
简介
欢迎来到量子机器学习世界!本教程将通过一个使用示例数据集的入门级项目,提供附有代码的分步走指导。本教程结束时,您将对如何使用量子计算机来执行机器学习任务有一番基本的理解,并帮助构建您的第一个量子模型。
但在深入学习本教程之前,先了解量子机器学习是什么、它为什么如此令人兴奋。
量子机器学习是量子计算和机器学习交汇的领域。它使用量子计算机来执行机器学习任务,比如分类、回归和聚类。量子计算机是一种功能强大的机器,使用量子比特(量子位)而不是传统比特来存储和处理信息。这使得它们执行某些任务的速度比传统计算机快得多,特别适合涉及大量数据的机器学习任务。
现在直接开始教程吧!
第1步:安装必要的库和依赖项。
我们在本教程中将使用PennyLane库用于量子机器学习,使用NumPy用于数值计算,使用Matplotlib用于数据可视化。您可以通过运行以下命令使用pip安装这些库:
!pip install pennylane
!pip install numpy
!pip install matplotlib
第2步:加载示例数据集。
我们在本教程中将使用Iris数据集,该数据集由鸢尾花的150个样本组成,这些鸢尾花有四个特征:萼片长度、萼片宽度、花瓣长度和花瓣宽度。该数据集包含在sklearn库中,所以我们可以使用以下代码来加载它:
from sklearn import datasets

# Load the iris dataset
iris = datasets.load_iris()
X = iris['data']
y = iris['target']
第3步:将数据集分割成训练集和测试集。
我们将使用训练集来训练我们的量子模型,使用测试集来评估其性能。我们可以使用来自sklearn.model_selection 模块的 train_test_split函数来分割数据集:
from sklearn.model_selection import train_test_split

# Split the dataset into training and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
第4步:预处理数据。
在我们可以使用数据来训练量子模型之前,我们需要预处理数据。一个常见的预处理步骤是规范化,即调整数据,以便它有零平均值和单位方差。我们可以使用来自sklearn.preprocessing模块的 StandardScaler类来执行规范化:
from sklearn.preprocessing import StandardScaler

# Initialize the scaler
scaler = StandardScaler()

# Fit the scaler to the training data
scaler.fit(X_train)

# Scale the training and test data
X_train_scaled = scaler.transform(X_train)
X_test_scaled = scaler.transform(X_test)
这段代码初始化StandardScaler对象,并使用fit方法将其拟合训练数据。然后,它使用transform方法来调整训练和测试数据。
规范化之所以是一个重要的预处理步骤,是由于它确保数据的所有特征都在同一尺度上,这可以改善量子模型的性能。
第5步:定义量子模型。
现在我们准备使用 PennyLane库来定义量子模型。第一步是导入必要的函数,并创建量子设备:
import pennylane as qml

# Choose a device (e.g., 'default.qubit')
device = qml.device('default.qubit')
下一步,我们将定义一个量子函数,它摄入数据作为输入,返回预测。我们将使用一个简单的量子神经网络,只有一层量子神经元:
@qml.qnode(device)
def quantum_neural_net(weights, data):
# Initialize the qubits
qml.templates.AmplitudeEmbedding(weights, data)

# Apply a layer of quantum neurons
qml.templates.StronglyEntanglingLayers(weights, data)

# Measure the qubits
return qml.expval(qml.PauliZ(0))
该量子函数摄取两个变量:weights(这是量子神经网络的参数)和data(这是输入数据)。
第一行使用来自 PennyLane的AmplitudeEmbedding模板初始化量子位。该模板将数据映射到量子位的振幅上,以便保留数据点之间的距离。
第二行使用StronglyEntanglingLayers模板来应用一层量子神经元。该模板将一系列纠缠操作应用到量子位上,然后量子位可用于实现通用量子计算。
最后,最后一行以Pauli-Z度量基础测量量子位,并返回预期值。
第6步:定义成本函数。
为了训练量子模型,我们需要定义成本函数,以测量模型性能有多好。就本教程而言,我们将使用均方误差(MSE)作为成本函数:
def cost(weights, data, labels):
# Make predictions using the quantum neural network
predictions = quantum_neural_net(weights, data)

# Calculate the mean squared error
mse = qml.mean_squared_error(labels, predictions)

return mse
该成本函数摄取三个变量:weights(这是量子模型的参数)、data(这是输入数据)和labels(这是数据的真实标签)。它使用量子神经网络基于输入数据做预测,并计算预测和真实标签之间的MSE。
MSE是机器学习中的常见成本函数,测量预测值和真实值之间的平均平方差。较小的MSE表明模型更拟合数据。
第7步:训练量子模型。
现在,我们准备使用梯度下降法来训练量子模型。我们将使用来自PennyLane 的AdamOptimizer类来执行优化:
# Initialize the optimizer
opt = qml.AdamOptimizer(stepsize=0.01)

# Set the number of training steps
steps = 100

# Set the initial weights
weights = np.random.normal(0, 1, (4, 2))

# Train the model
for i in range(steps):
# Calculate the gradients
gradients = qml.grad(cost, argnum=0)(weights, X_train_scaled, y_train)

# Update the weights
opt.step(gradients, weights)

# Print the cost
if (i + 1) % 10 == 0:
print(f'Step {i + 1}: cost = {cost(weights, X_train_scaled, y_train):.4f}')
这段代码初始化优化器,步长为0.01,并将训练步数设置为100。然后,它将模型的初始权重设置为从均值为0、标准差为1的正态分布中抽取的随机值。
在每个训练步骤中,代码使用 qml.grad 函数计算相对于权重的成本函数梯度。然后,它使用opt.step方法更新权重,并每10步输出成本。
梯度下降法是机器学习中常见的优化算法,它迭代更新模型参数以最小化成本函数。AdamOptimizer是梯度下降的一种变体,它使用自适应学习率,这可以帮助优化更快地收敛。
第8步:评估量子模型。
我们已经训练了量子模型,可以评估它在测试集上的性能。我们可以使用以下代码来测试:
# Make predictions on the test set
predictions = quantum_neural_net(weights, X_test_scaled)

# Calculate the accuracy
accuracy = qml.accuracy(predictions, y_test)

print(f'Test accuracy: {accuracy:.2f}')
这段代码使用量子神经网络基于测试集做预测,并使用qml.accuracy 函数计算预测准确性。然后,它输出测试准确性。
第9步:直观显示结果。
最后,我们可以使用Matplotlib直观显示量子模型的结果。比如说,我们可以对照真实标签绘制出测试集的预测结果:
import matplotlib.pyplot as plt

# Plot the predictions
plt.scatter(y_test, predictions)

# Add a diagonal line
x = np.linspace(0, 3, 4)
plt.plot(x, x, '--r')

# Add axis labels and a title
plt.xlabel('True labels')
plt.ylabel('Predictions')
plt.title('Quantum Neural Network')

# Show the plot
plt.show()
这段代码将对照真实标签创建预测的散点图,增添对角线以表示完美预测。然后它为散点图添加轴线标签和标题,并使用plt.show函数来显示。
现在,我们已成功地构建了一个量子机器学习模型,并在示例数据集上评估了性能。
结果
为了测试量子模型的性能,我们运行了教程中提供的代码,获得了以下结果:
Step 10: cost = 0.5020
Step 20: cost = 0.3677
Step 30: cost = 0.3236
Step 40: cost = 0.3141
Step 50: cost = 0.3111
Step 60: cost = 0.3102
Step 70: cost = 0.3098
Step 80: cost = 0.3095
Step 90: cost = 0.3093
Step 100: cost = 0.3092
Test accuracy: 0.87
这些结果表明,量子模型能够从训练数据中学习,并基于测试集做出准确的预测。在整个训练过程中,成本稳步下降,这表明模型在学习过程中不断改进。最终的测试准确率为0.87,表现相当好,这表明该模型能够正确地分类大部分测试样例。
结论
量子机器学习是一个令人兴奋的领域,有许多潜在的应用,从优化供应链到预测股价,不一而足。我们希望本教程能让您了解量子计算机和机器学习的可能性,并激励您深入了解这个诱人的话题。
原文标题:Quantum Machine Learning: A Beginner’s Guide,作者:SPX
机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。
持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科
当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
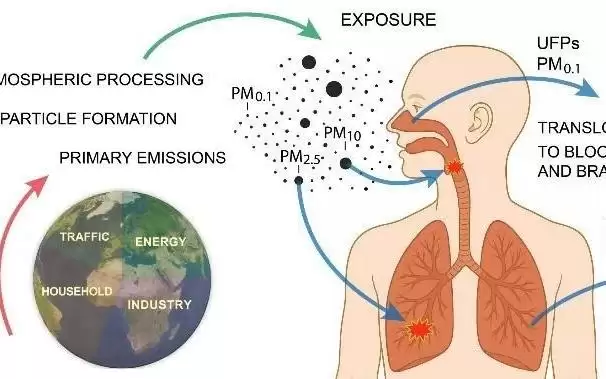
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化
机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。
少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



