

奎芯科技唐睿:Chiplet加速国产芯片研发
AI与芯片设计绑定,利润向硬件公司高度倾斜,Chiplet成国产芯破局关键。编辑|全球AI芯片峰会9月17日,2025全球AI芯片峰会在上海举行,在峰会主论坛上,奎芯科技联合创始兼副总裁唐睿以《Chiplet,AI算力的基石》为主题发表演讲。当前AI革命与过往互联网产业发展不同,利润高度向硬件环节倾斜。唐睿称,随着模型尺寸不断变大、算力需求飙升,科技企业的CAPEX(资本性支出)大幅增长且逐渐取代OPEX(运营性支出)成为主流趋势,这是因为AI整体的性能与互联带宽、内
AI 与芯片设计绑定,利润向硬件公司高度倾斜,Chiplet 成国产芯破局关键。
编辑 | 全球 AI 芯片峰会
9 月 17 日,2025 全球 AI 芯片峰会在上海举行,在峰会主论坛上,奎芯科技联合创始兼副总裁唐睿以《Chiplet,AI 算力的基石》为主题发表演讲。
当前 AI 革命与过往互联网产业发展不同,利润高度向硬件环节倾斜。唐睿称,随着模型尺寸不断变大、算力需求飙升,科技企业的 CAPEX(资本性支出)大幅增长且逐渐取代 OPEX(运营性支出)成为主流趋势,这是因为 AI 整体的性能与互联带宽、内存容量深度绑定。
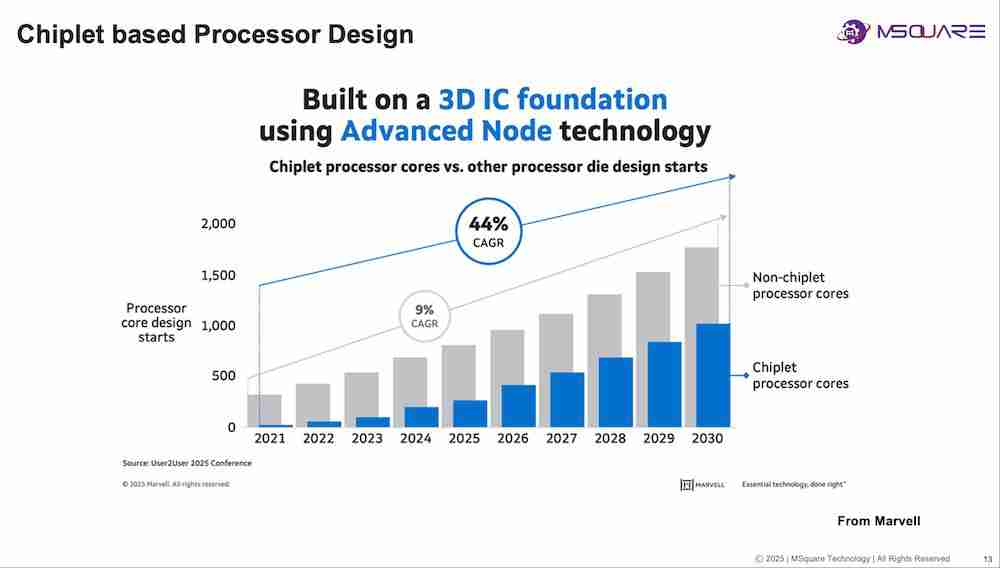
同时,当下芯片设计周期远跟不上 AI 算力或者模型发展的需求,在唐睿看来,基于 Chiplet 的设计能加快芯片研发迭代。2021 年 -2030 年处理器预计研发项目数量年化增长约 9%,但基于 Chiplet 的设计年化增长率高达 44%,预计 2030 年占比超一半。
基于这一现状,奎芯打造了基于 UCle 标准接口 IP 的国产化完整解决方案,研发了两代 UCle IP,第一代为 16GT/s,第二代为 32GT/s,且在标准封装实现。这些 IP 具有高性能、低功耗、灵活性等优势,能为芯片快速迭代提供支持。
以下为唐睿的演讲实录:
ChatGPT 爆发到现在只有不到三年时间,芯片设计周期一般至少两到三年,所以芯片设计的周期远远跟不上 AI 算力或者 AI 模型发展的需求。
怎么才能加快芯片的研发速度、提升芯片研发的周期?Chiplet 是长期的趋势,还可以增加下游芯片设计公司的迭代速度。
01.
硬件公司获得大部分利润
科技公司资本性支出大涨
首先介绍一下 AI 产业的发展趋势。
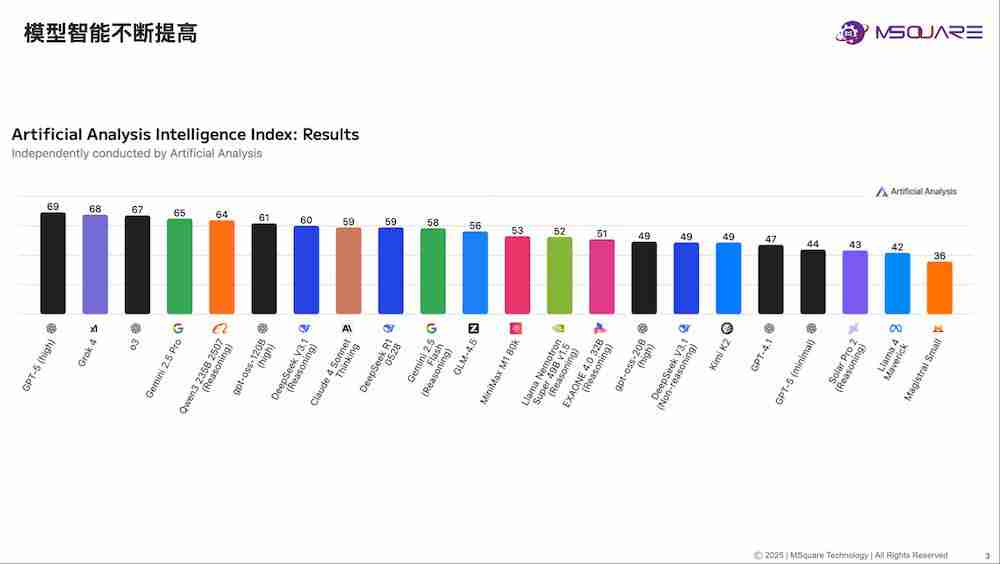
目前的模型智能化程度越来越高,下图是 AI 基准测试提供商 Artificial Analysis 所给出的最新模型智能水平综合排名。
该排名综合了十项测试标准,包括数学基准测试 AIME 以及推理能力的 Benchmark 等。排名第一的 GPT-5 发布于今年 8 月,排名第二的 Grok 4 发布于今年 7 月,以及国产通义千问、DeepSeek-V3.1 等模型也发布不久,这说明模型的性能更新日新月异。
在整个 AI 产业中,哪些公司或者哪些相关的产业在挣钱?
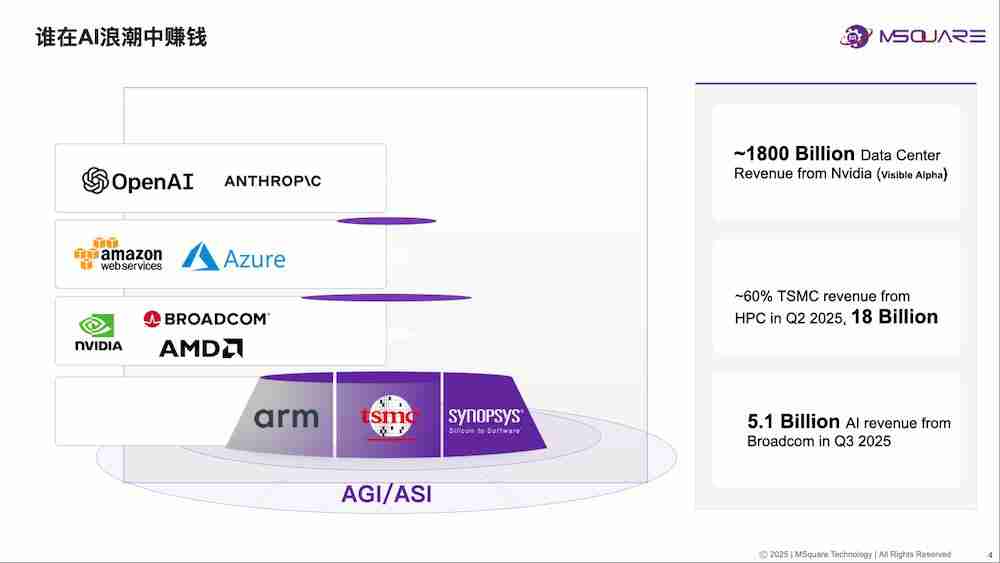
AI 革命和此前互联网产业革命略有不同。因为目前仍是硬件公司获得大部分利润,一些分析师预计今年英伟达的数据中心营收会达到 1800 亿美元(折合人民币约 1.3 万亿元);博通最新的第三季度财报显示,其数据中心相关的 AI 硬件营收是 52 亿美元(折合人民币约 370 亿元);台积电今年第二季度的 HPC 营收也超过 180 亿美元(折合人民币约 1279 亿元),占总营收的 80%。
而最上层的应用层,如 OpenAI、Anthropic 的 ARR(年度经常性收入)并不是很高。今年 7 月,OpenAI 最新 ARR 数据是 120 亿美元(折合人民币约 853 亿元)左右,Anthropic 大概在 50 亿美元(折合人民币约 355 亿元)左右。
其余数据中心相关公司获取了大部分的行业利润和营收,包括 EDA 和 IP 公司。
为了实现 AGI,五大科技巨头的资本支出非常惊人。
到今年第二季度,五大科技公司的 CAPEX(资本性支出)已经飙升到 970 亿美元一个季度。除了这五大科技公司,刚刚上市的 CoreWave 今年预计 CAPEX 达到 230 亿美元,此外甲骨文在最新财报会议中透露,预计 2026 年的资本支出达到 350 亿美元震惊业界,这主要是因为 OpenAI 与其签订合同,预计 2030 年甲骨文云营收达到 1440 亿美元。
这个趋势印证了一个变化,这些公司的财报显示,公司 OPEX(经营性支出)在这几年几乎没有增加,甚至还有略微下降,这可能与公司裁员有关,也说明CAPEX 取代 OPEX 的现象已经在发生。
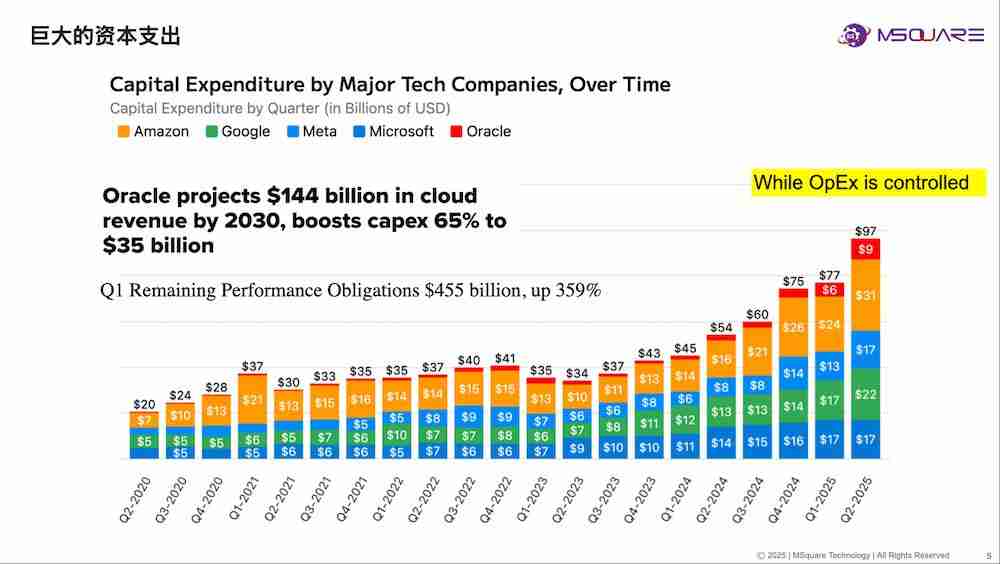
到 2025 年 6 月,美国数据中心的支出已经接近于办公室建设支出,大概都在 400 亿美元左右,这也进一步验证了大公司 CAPEX 超过 OPEX 的趋势。
为什么需要这么大的 CAPEX?因为模型尺寸不断变大,虽然闭源模型的尺寸可能不完全透明和公开,但开源模型尺寸非常惊人,如 Kimi K2 的总参数规模达到 1 万亿。这样的模型尺寸就意味着需要庞大的算力资源去支撑模型训练,整体算力需求每年以 4 倍的速度增长。
除了算力,模型训练和推理对内存、互联带宽的需求也在不断提升。
目前AI 整体的性能还是被互联带宽以及内存容量所绑定。
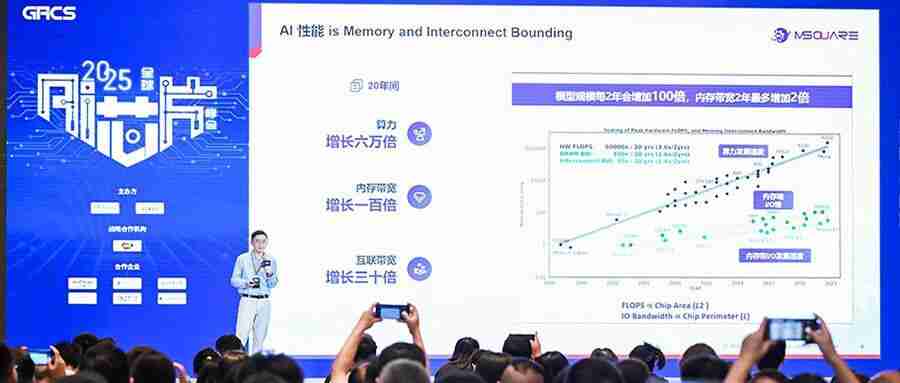
下面是一张比较老生常谈的图,20 年间芯片算力提升了 6 万倍,但是内存带宽只增加了 100 倍、互联带宽只增加了 30 倍。
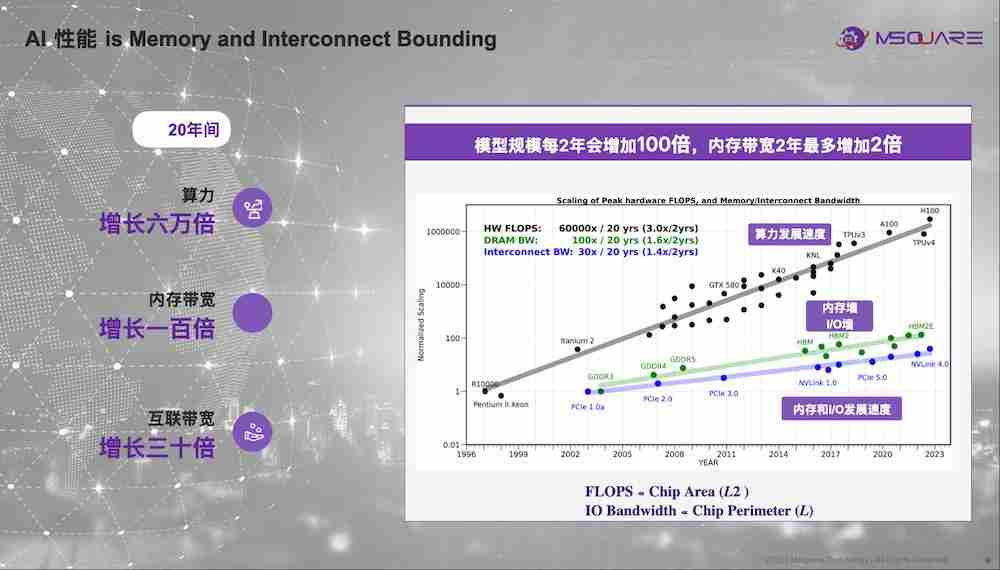
这背后的原因是,算力与芯片面积成正比,IO 的带宽或接触内存的 Beachfront 与芯片周长成正比,带宽会随着芯片周长线性增加,但算力可以随周长增长呈几何平方增加,因此带宽永远跟不上算力的增长。
02.
基于 UCle 标准接口 IP
打造国产化完整解决方案
下面介绍一下奎芯的 IP 和 Chiplet 产业。
最新的主流 AI 芯片非常重视互联带宽和内存容量,包括英伟达的 GB300、AMD 的 MI355X 都采用了最新的 HBM3E 内存。NVLink 的带宽已经高达大概 3.6TB/s,Infinity Fabric 接近于 1TB 互联带宽。
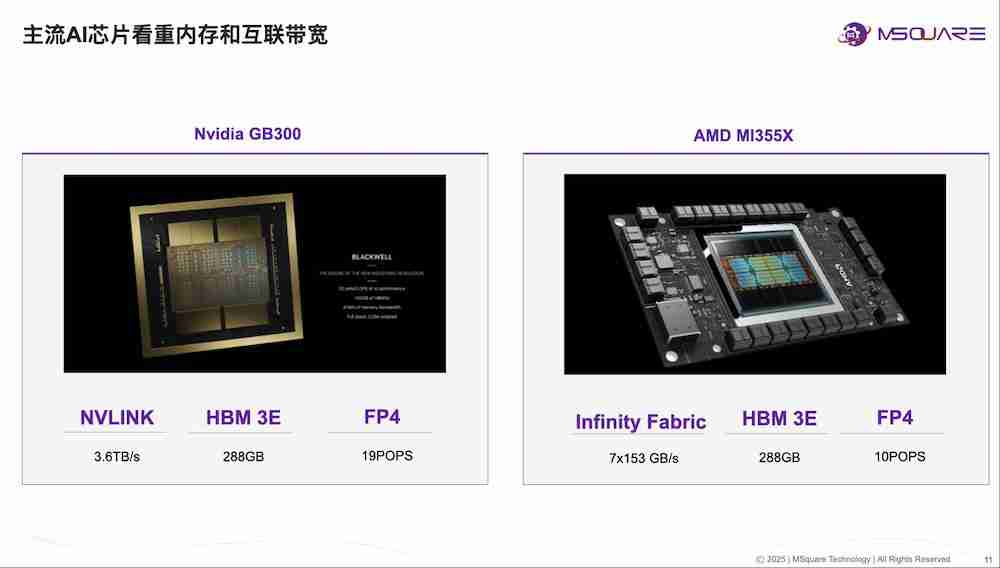
整个数据中心中,CPU 之间或 XPU 之间的互联、XPU 和 Switch 之间的互联以及整个数据中心的 Scale-Out 和 Scale-Up,都离不开互联 IP 的支撑。
目前芯片设计逐步走向 Chiplet 化,Marvell 的数据显示,近十年整体芯片的数量年化增长约为 9% 左右,但是基于 Chiplet 设计的芯片数量年化增长为 44%。2021 年,Chiplet base 的设计只占很小部分,预计到 2030 年占比将超过一半。
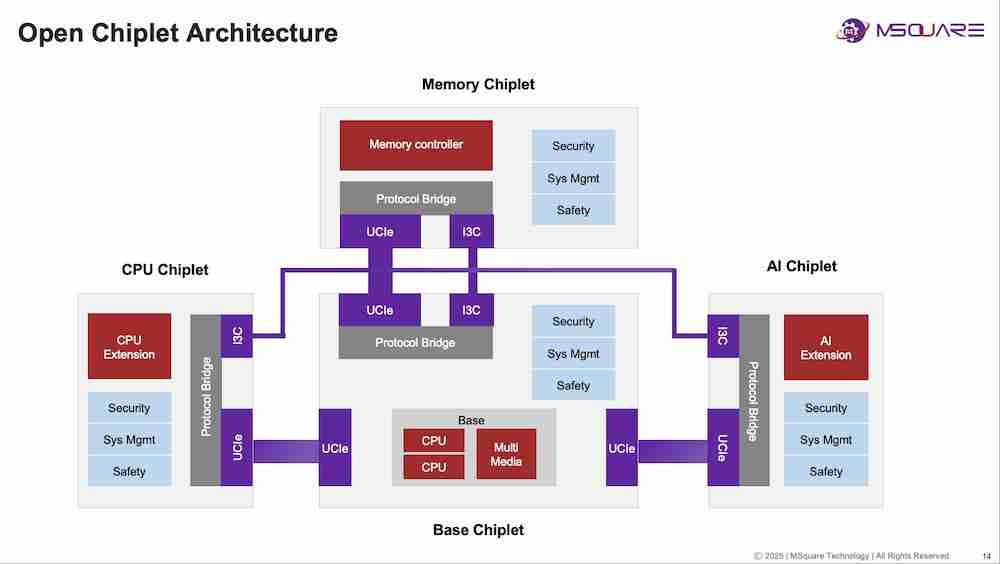
Open Chiplet Architecture(芯粒架构开放标准)的构想是,未来会有 CPU Chiplet、Memory Chiplet、Base Chiplet、AI Chiplet,构成各家合作共赢的生态,这些 Chiplet 都可以通过 UCIe 的 IP 进行连接。
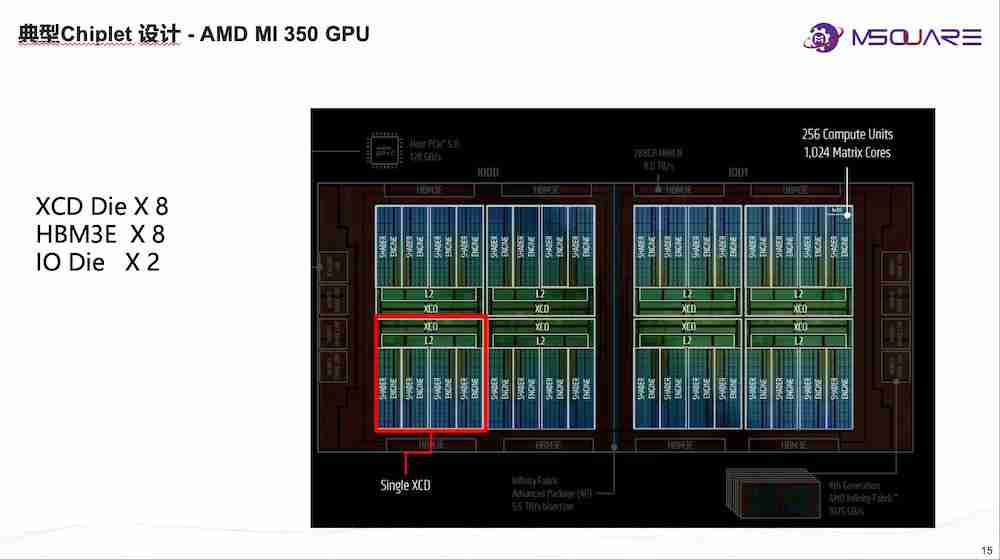
下图是一个典型的基于 Chiplet 设计的芯片,这是 AMD 最新 GPU,有 8 个计算 Die、8 个 HBM3E 及两块很大的 IO Die。
奎芯在 UCIe IP 以及 Chiplet 相关领域的布局:
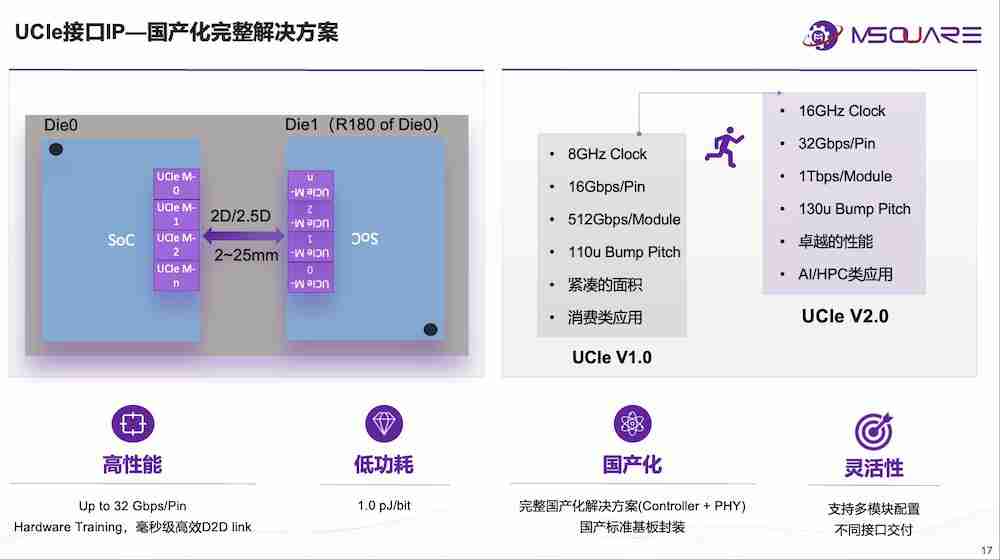
首先奎芯研发了 UCIe IP,因为 UCIe IP 是连接 Chiplet Die 的基础,所有的 Chiplet 小芯片都可以通过 UCIe IP 去进行互联。奎芯 UCIe IP 具备高性能、低功耗、国产化以及灵活性等优势。
目前,奎芯已经研发了两代 IP,第一代速度为 16Gbps,第二代为 32Gbps。第二代的 32Gbps 基于标准封装实现,这在国内相当领先且功耗相对比较低,基本上可以控制在 1.0 pJ/bit。
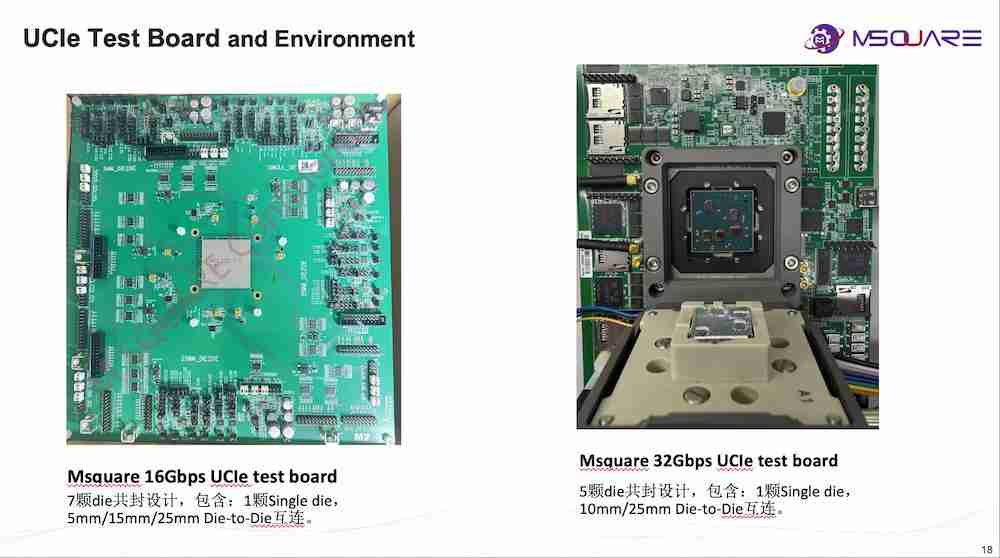
两块 IP 已经进行了测试,最新的 32Gbps 测试板采用 5 颗 Die 共封设计,包含 1 颗 Single Die,10mm、25mm Die-to-Dia 互连。25mm 的 UCIe IP 测试的眼图结果,奎芯实现了 72 小时无误码率,眼的宽度达到 0.75UI。
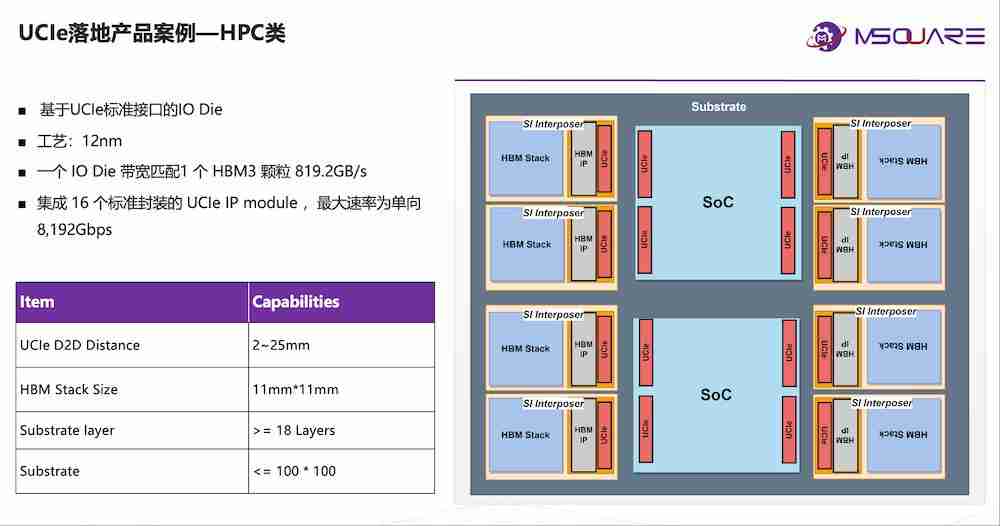
奎芯的 UCIe IP 以及 Chiplet 已经有客户。下图是其 HPC 领域客户,结合奎芯的 IO Die,可以帮助客户实现 HBM 内存和 SoC 之间的解耦。一个 IO Die、SoC 上,都对应集成了 16 个标准封装的 UCIe IP 模组,单向速率可以完全匹配或超过 HBM3 的带宽要求。该企业在整个芯片设计中,采用了奎芯 8 对 UCIe IP。
下面是奎芯 ML100 IO Die 的设计,这是其整体交付给客户 Chiplet Base Design 的一部分。
奎芯采用 HBM 颗粒和 IO Die 在 interposer(中介层)上实现共封,但是 IO Die UCIe 和 SoC 内 UCIe 是通过 Substrate 进行互连。
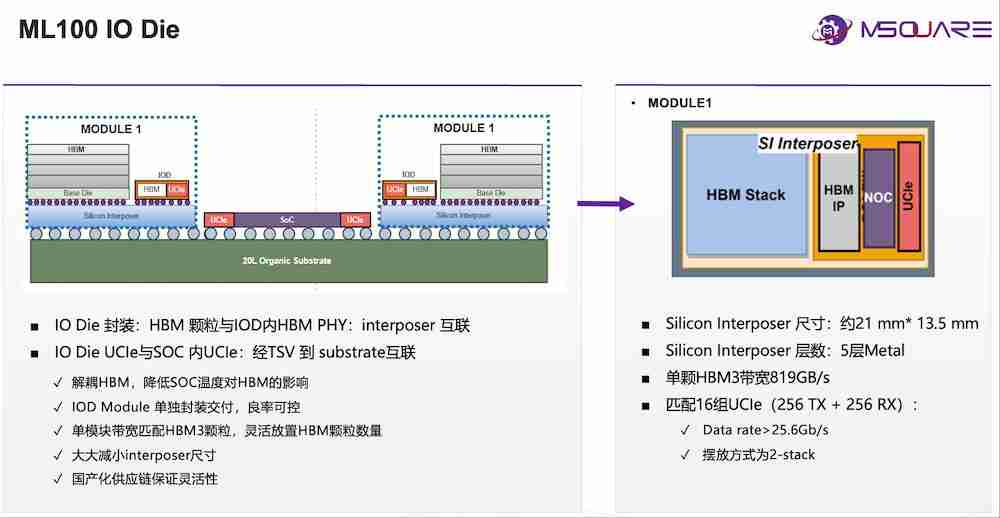
这有如下几点好处:第一是可以解耦 HBM,降低 SoC 的温度对 HBM 性能的影响;第二是 IO Die 模组涵盖了 HBM 颗粒,可以实现单独封装交付,良率可控;第三是因为排除了紧耦合,单位 SoC 的边长可以连接的 HBM 颗粒数量稍多,可进行灵活配置,同时因为 Interpose 只用于 IO Die 和 HBM3 颗粒之间互联,使得整体 Interposer 面积缩小;第四是国产化供应链的解决方案,保证了供应链的灵活性。
下图右边可以看到 Interposer 的尺寸以及用了多少 Metal,最后匹配整体速率,与 UCIe IP 结合实现相对完美的速率匹配。这是奎芯基于 UCIe 的互连扩展方案示意图。
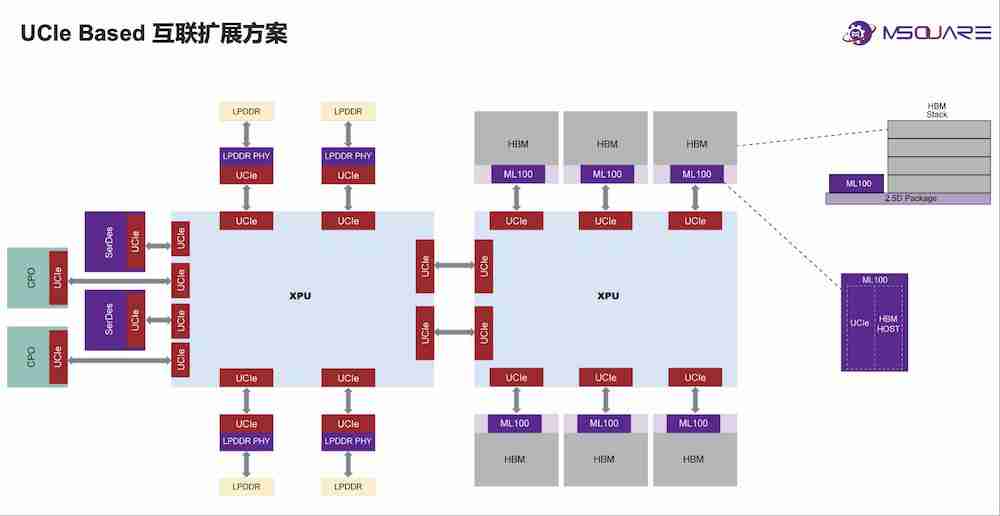
之前很多嘉宾谈到了分离 Prefill(预填充)和 Decode(解码)这两块的计算,在芯片设计领域也要考虑 Prefill 和 Decode 的计算分离。用 IO Die 去连接不同的内存是经济实惠的方案,那 Prefill 采用 GDDR 和 LPDDR 就够了。
基于奎芯的整体解决方案,企业只需要在 SoC 端或者计算芯片上放置其 UCIe IP 就可以,在 IO Die 上,可以基于企业所需要的内存,在 UCIe 到 HBM 的 IO Die 以及 UCIe 到 LPDDR 的 IO Die 之间做切换,方便于企业后面接外置内存进行直接切换,在 SoC 上不用放置不同的 PHY,可以节省 SoC 面积,同时也可以把 SoC 的面积更多利用来仿真计算单元。
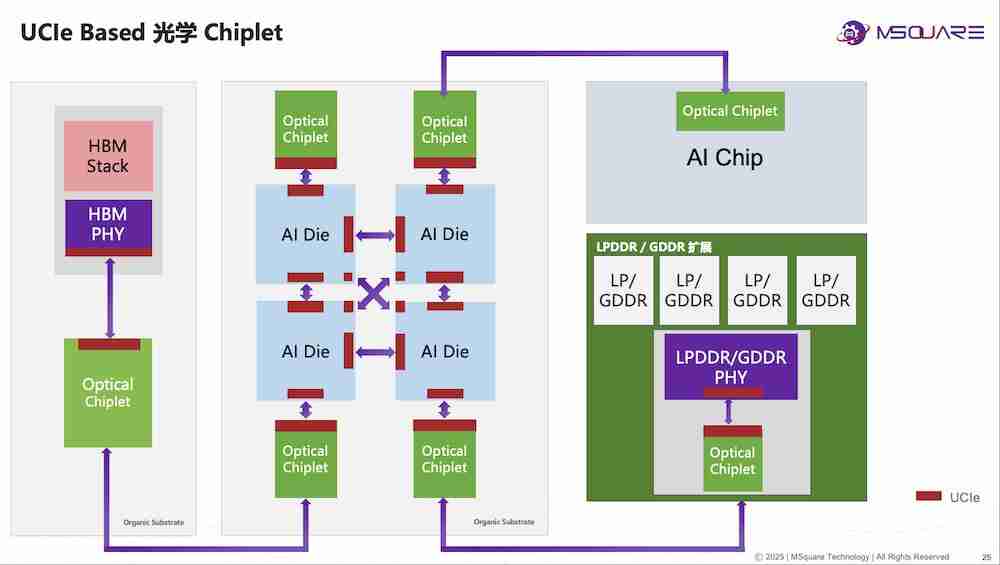
奎芯也在规划研发 UCIe 到 SerDes 的 Chiplet,以及 UCIe 到 Optical Chiplet 的解决方案。
03.
解读四大长期趋势
建立 AI 硬件基础服务设施平台公司
最后介绍关于奎芯的未来产品规划以及愿景。
奎芯看到五到十年的长期趋势包括:
CPO 在逐步取代 LPO 和 NPO;CPO 从 Switch 端转向 XPU 之间互联、XPU 和内存之间互联;基于 HBM4 各大内存厂家都提出了 Base Die 的概念,可能不需要 Phy;国内有很多 Emerging 3D 内存技术、Flash 技术,都会对 Base Die 提出更高要求。
奎芯正在与海外客户研讨基于 Optical Chiplet 的内存以及互联扩展方案,包括用 Optical 部分解决现在的连线瓶颈,最后连接到 SoC 端或者是 AI 计算端,仍采用 UCIe IP,但是在内存端可以做自由切换。
这一方案脱离了合封限制,用 GDDR 可能是更经济有效的方案,甚至可以用 LP/GDDR 来做内存,只要在带宽上满足对 Prefill 或者 Decode 不同阶段的内存需求。
XPU 之间如果通过 Optical 互联,可以提升带宽瓶颈,真正意义上突破了周长受限模式。
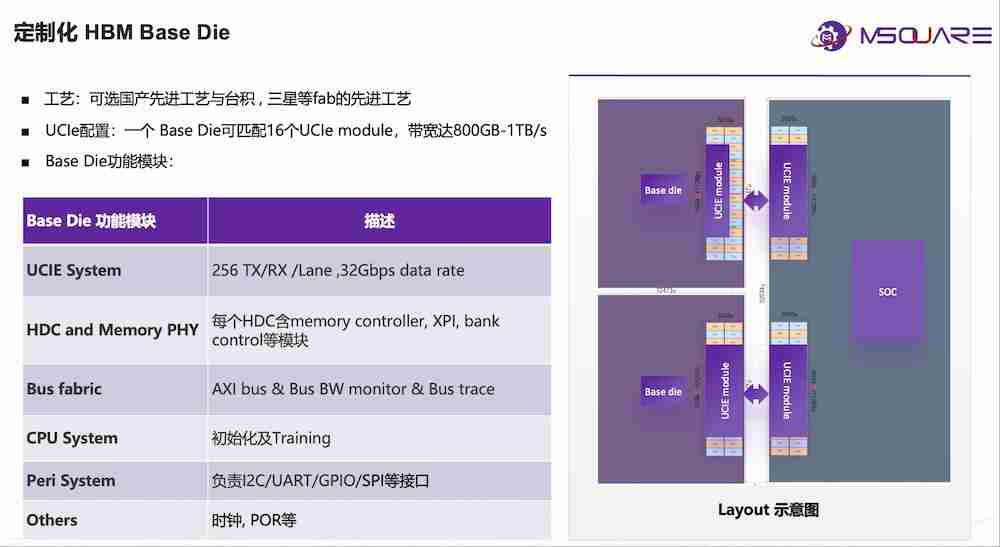
奎芯也在与国内内存厂商研讨基于新型内存定制 Base Die 的方案,还是通过 UCIe IP 连接芯片。
其带宽稍微低于 HBM,但大大节省了成本,同时这种方案采用标准封装,省掉了 Interposer 的设计和制造成本,整体上可以降低整体 AI 系统成本。再加上方案采用国内 3D 堆叠的 DRAM,成本明显低于标准 HBM,供应链相对可控。
其它海外内存大厂还在积极推进 HBM4 Base Die 的研发,这一块奎芯也在于海外大厂共同探讨合作,这里面的细节与 Base Die 的设计有异曲同工的相似之处。
最后是奎芯的愿景和使命。
奎芯是以互联 IP 起家的公司,未来希望凭借丰富的 IP 组合,建立领先的 AI 硬件基础服务设施平台公司,来引领 AI 和 Chiplet 领域的创新。
客户只要提供自己与自己算法强相关的核心计算 Die,其它的非核心的 Die,像 IO Die 也好,基本的计算 Die 也好,以及 2.5D 封装设计也好,都可以交给奎芯去做。这样的商业模式,特别适合现在大模型的快速迭代速度,以及比较感兴趣自己核心算法迭代的大模型公司或者互联网公司做一些更快速的芯片的迭代。
谢谢大家!
以上是唐睿演讲内容的完整整理。
荣耀MagicOS 11定于9月15日发布,作为行业首个商用系统级Agent Harness架构的操作系统,Magic 9系列将首发搭载。新版YOYO支持最长上百步长程任务及40余项条件触发,10月开启Beta预览版招募。
华强北销售商反馈,年初以来主流手机品牌基本全线涨价,涨幅最低400元,最高达1000-1500元。涨价主因是全球存储芯片及电容等元器件成本上升,运行内存与机身存储价格涨幅超100%。尽管整体市场承压,国产折叠屏手机1-8月销量约450万台(新形态超135万台,同比增29%),AI手机成为厂商发力重点。
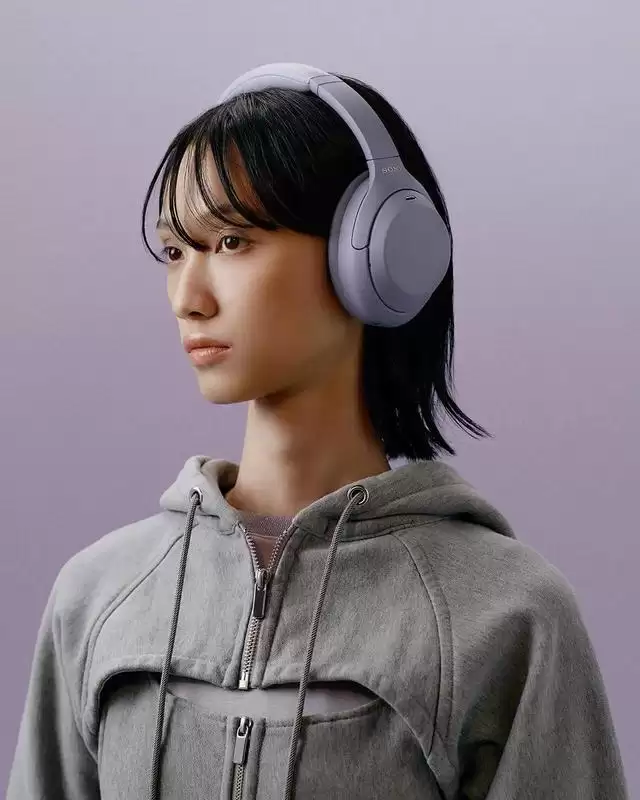
索尼发布WH-1000XM4C头戴式降噪耳机,复刻了XM4的经典四向折叠便携设计。该机型在保留QN1处理器和30小时续航的基础上,全面升级了USB-C高速充电、无损音频直连、蓝牙多点连接及AI降噪通话功能,旨在满足对便携性有极高要求的用户群体。
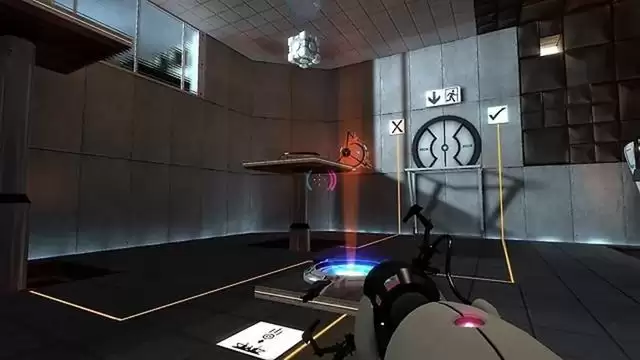
OpenAI GPT-6 Astra 模型通过 MCP 协议与 SourcePauseTool 控制《传送门》游戏,完成 3336 次工具调用并自主通关。实验耗时约 24 小时,API 成本约 571 美元,展示了多模态 AI 在 3D 解谜领域的突破性进展。
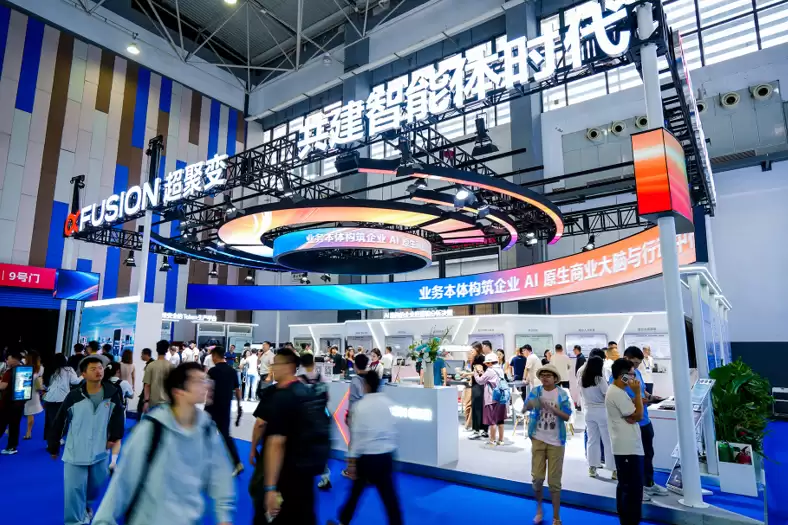
本文解析超聚变在2026数博会发布的“智企”范式,重点阐述如何通过Token生产平台(Token Factory)与企业业务本体建模,实现从简单AI工具调用到企业应用架构系统性重构的演进。文章详细拆解了智能体编排、数字孪生及生态协同等关键技术路径,为AI时代企业数字化转型提供可落地的参考方案。
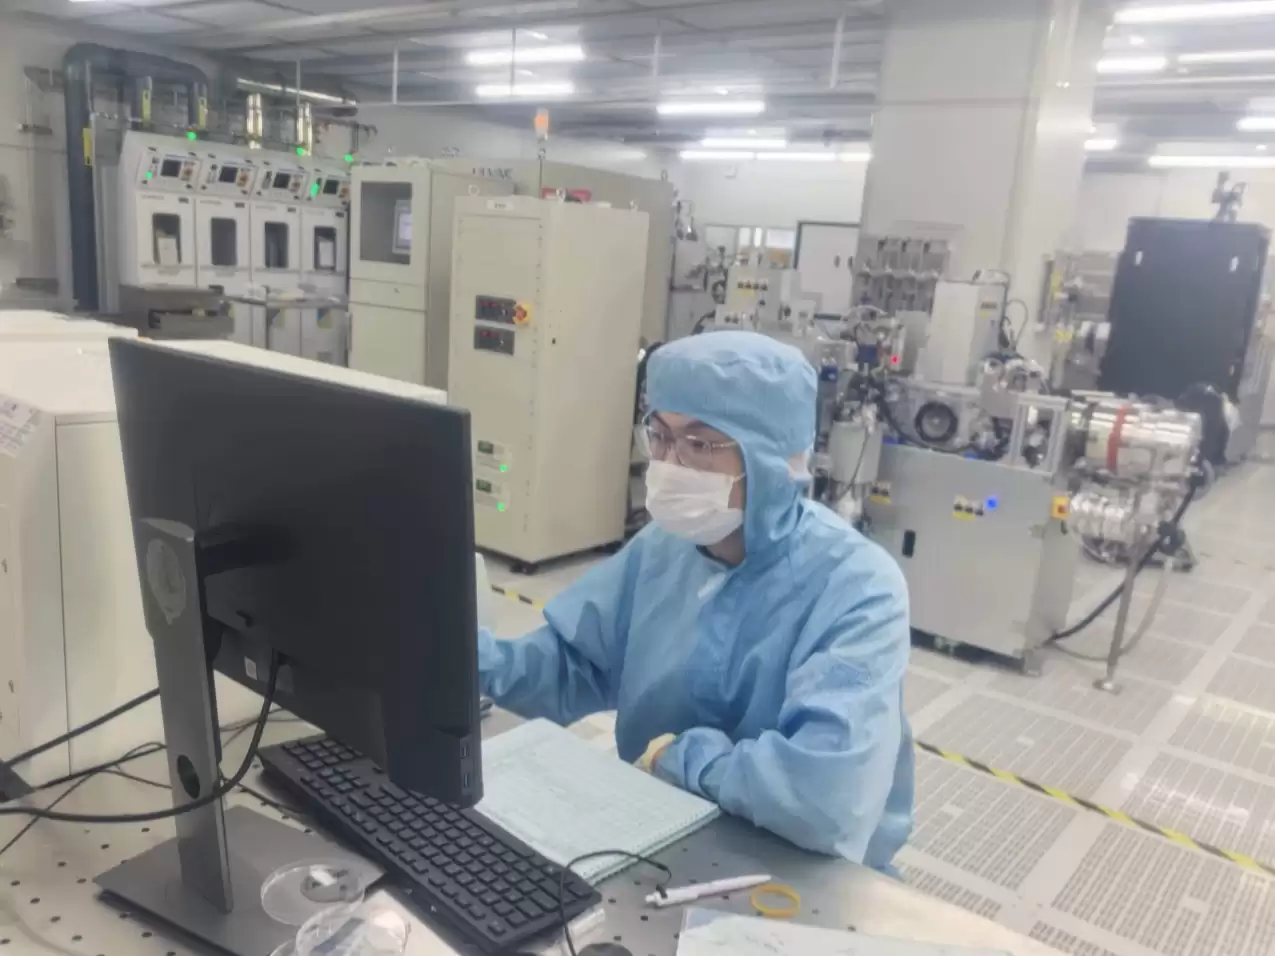
南京邮电大学“光擎智算”团队联合南京大学,攻克GaN基Micro-LED器件技术,成功搭建实验室级光计算验证系统。团队自主研发的5×5 Micro-LED光电计算阵列芯片已进入流片封装阶段,实现了图像识别等算力任务验证,推动光计算技术从理论走向工程落地。

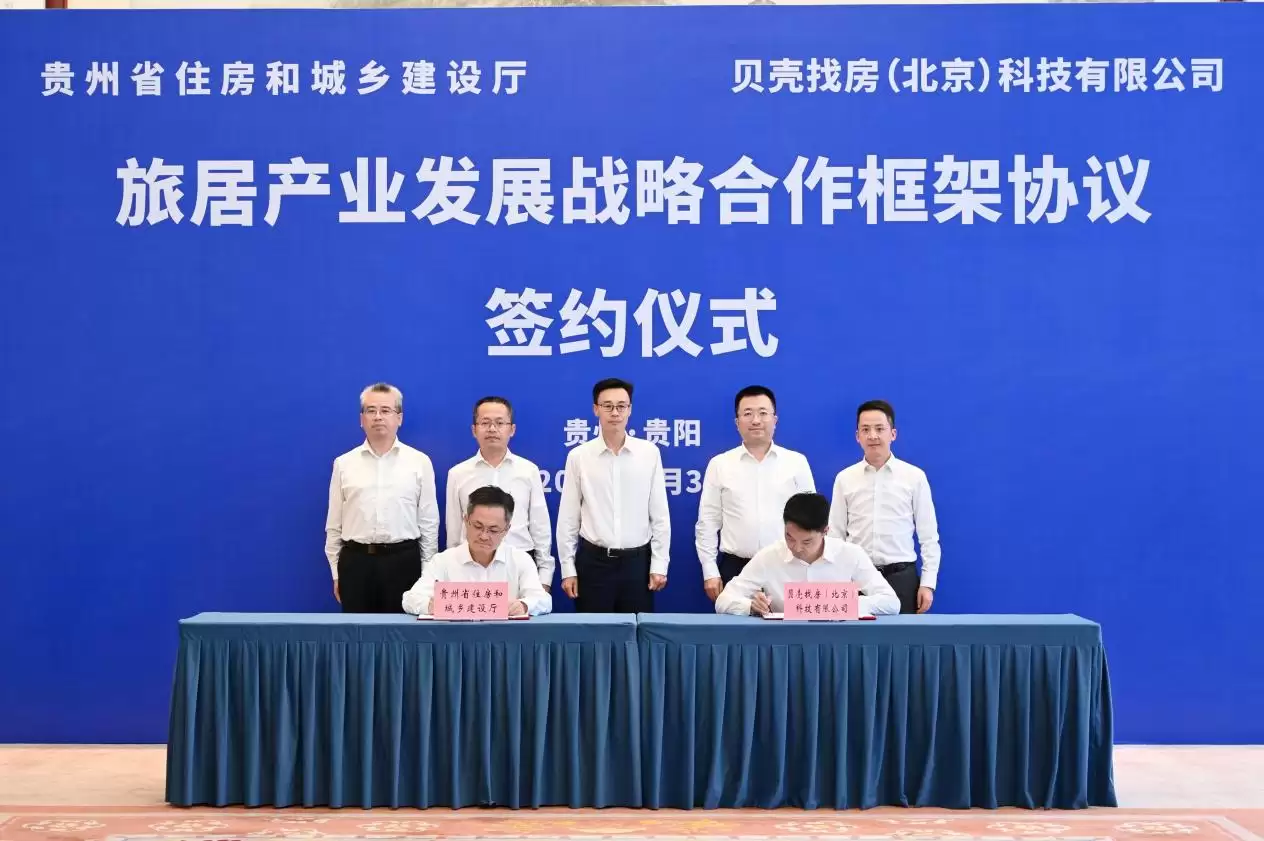
9月3日,贵州省住建厅与贝壳集团在贵阳签署《旅居产业发展战略合作框架协议》,旨在打造全国旅居样板。合作涵盖平台建设、标准共建、人才培育、存量资产盘活及品牌推广五大维度,依托贝壳近600家门店及4000余名经纪人资源,强化贵州旅居服务供给,促进房地产市场平稳健康发展。
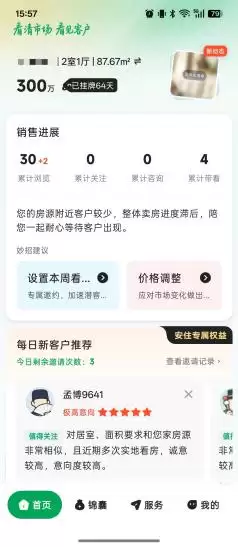
本文解析上海链家推出的“安住APP”功能,该工具允许业主在贝壳/链家挂牌后主动管理房源。通过实时查看销售进展、发送看房邀约及获取AI策略,业主可缩短成交周期。数据显示试点期间平均成交7天,最短1天。适用于希望提高信息透明度、主动参与卖房过程的业主。

2026年6月工信部等七部门印发《促进平台经济大中小企业协同发展行动方案》,明确平台经济是数字技术赋能的实体经济。针对流量垄断与“数字租金”问题,专家主张治理重心应从静态整改转向推动平台能力向中小企业外溢,通过算法透明、接口开放及数据可迁移,打破封闭生态,实现创新与规范并重的高质量发展。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
