

系统应用
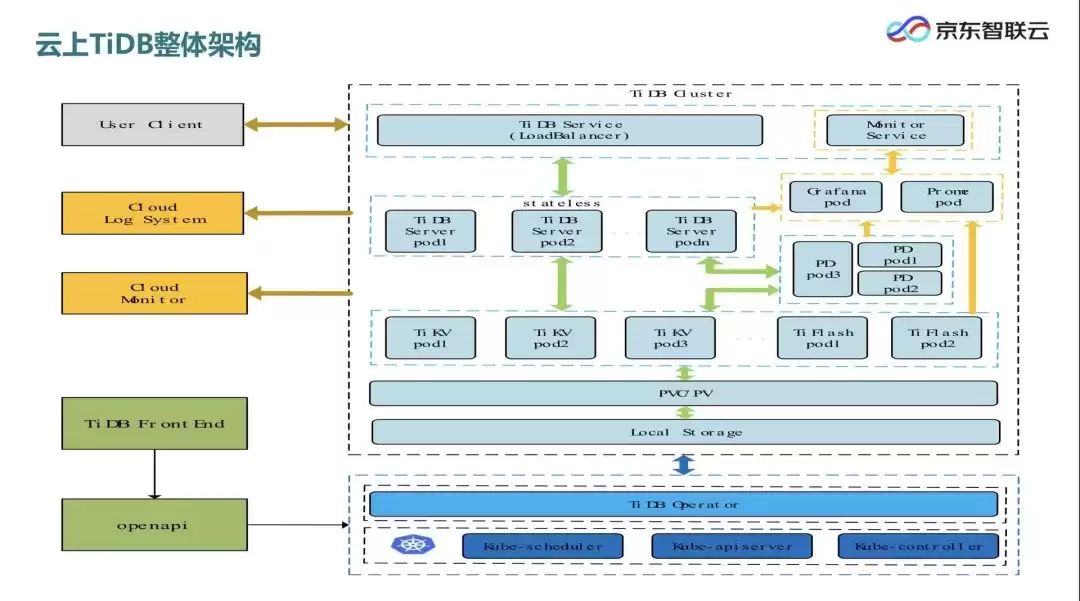
对于任何一家业务快速成长的企业来说,应对峰值流量冲击,一直是摆在技术团队面前的一大难题。面对海量数据,数据库及业务团队都希望做到“无感扩容”,但流行的分库、分表方案在扩容速度和一致性上经常不能满足需求。行业期待着性能强大、简单易用的全新数据库方案,从根本上解决企业面对流量高峰时的数据库性能瓶颈。行业
自从2009年入职百度以来,已经经历了11年了,我自己从一线研发工程师开始,也逐步成长成为了带领复杂技术方向的技术负责人。10年多的工作历程,让我有幸经历了大范围的技术演变,特别是云计算和云原生技术从朦胧到普及,对工程师和架构师的要求也发生了不少变化。趁着自己入职11周年的日子,结合我自己在百度的
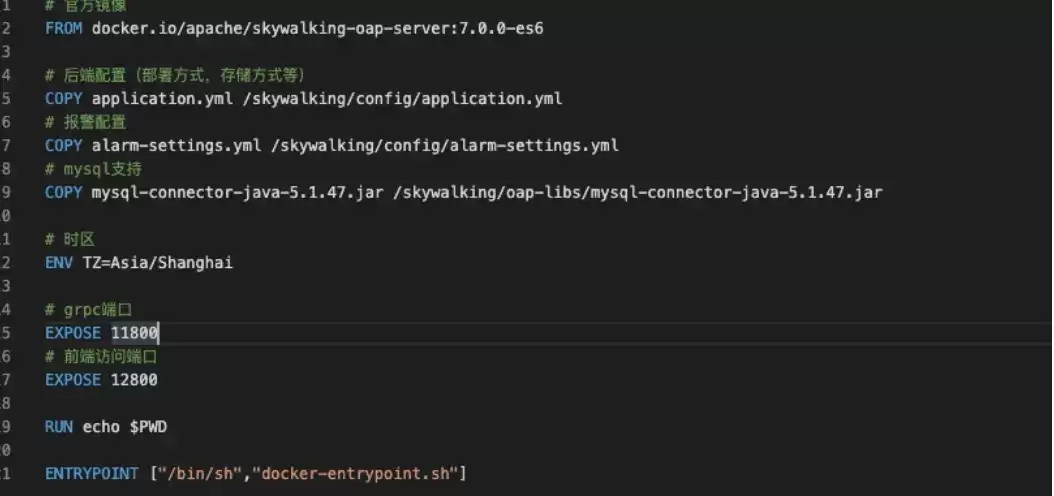
1.搭建1.构建Skywalking-docker镜像Skywalking支持下载zip包安装,但是推荐使用docker进行安装更加方便。Skywalking在Docker Hub提供了官方镜像,我们只需要引用在此基础上进行扩展即可。Skywalking-oap(服务端,接受埋点信息和计算)Skyw
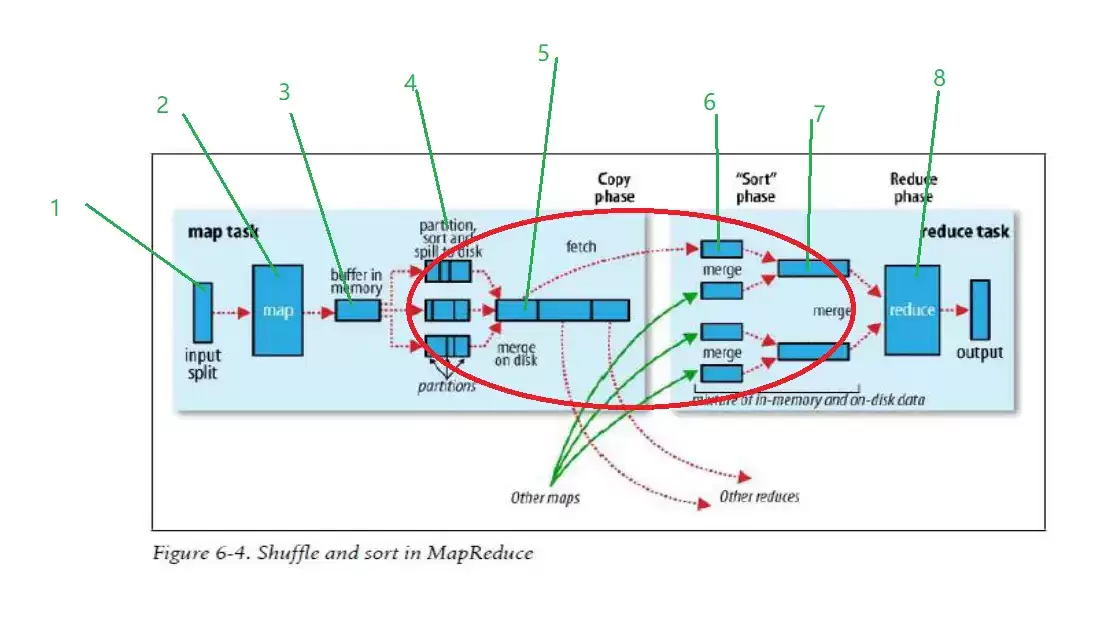
1.思考熟悉hadoop中mapreduce原理的人,都知道整个流程的运行原理。其中涉及至少三次排序,分别是溢写快速排序、溢写归并排序和reduce拉取归并排序,而且排序是默认的,也就是天然排序。那为什么要这么设计呢?先给出结论:为了整体更稳定,输出满足多数需求。前者体现在采用的是sortShuff
技术的成熟度源自大规模的实践,在 Ja va 领域,阿里将自身的实践源源不断的反哺给微服务技术体系;在 Node.js 领域,阿里正掀起了前所未有的前端革命浪潮,将实践反哺给 Serverless 技术体系,并逐渐拓展到其他多语言体系和后端 BaaS 上。Serverless云研发平台,乃阿里巴巴集
在 KubeVela 项目发布以后,很多国内外的社区同学们都会问到一个类似的问题:KubeVela 的体验真的非常棒,可以说是 Kubernetes 上的 Heroku 了。这么看来, KubeVela 跟 Heroku 这样的 PaaS 产品到底是不是一类项目呢?今天,我们就专门来聊一个这个话题:
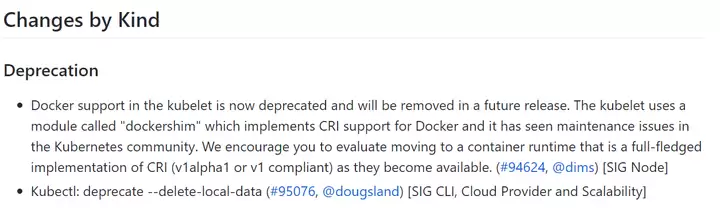
近日,Kubernetes 在1.20版本中 的 ChangeLog 提到,将废弃 Docker 作为容器运行时。 kubelet 中的 Docker 支持功能现已弃用,并将在之后的版本中被删除。Kubelet 之前使用的是一个名为 dockershim 的模块,用以实现对 Docker 的 CRI
本文系云原生应用最佳实践杭州站活动演讲稿整理。杭州站活动邀请了 Apache APISIX 项目 VP 温铭、又拍云平台开发部高级工程师莫红波、蚂蚁金服技术专家王发康、有赞中间件开发工程师张超,分享云原生落地应用的经验心得,以下是莫红波《微服务架构下 CI/CD 如何落地》分享内容。莫红波,又拍云平
TiDB 使用 Prometheus 和 Grafana 提供了非常详细的监控指标。在遇到各种性能或稳定性问题时,这些监控一般是问题的关键线索。但详尽的细节监控指标使用门槛较高,刚入门的 TiDB DBA 可能难以上手,例如:如何快速了解当前集群最耗时的是哪类操作?发现写入耗时很长,如何进一步定位原
在互联网上的各类网站中,无论大小,基本上都会有一个搜索框,用来给用户对内容进行搜索,小到站点搜索,大到搜索引擎搜索。从简单的来说,搜索功能确实很简单,一个简单的select语句就可以实现数据的搜索。而从复杂的来看,无论是搜索的精度还是搜索的效率,都是有很深的研究范围的。对于简单的搜索功能来说,一个s
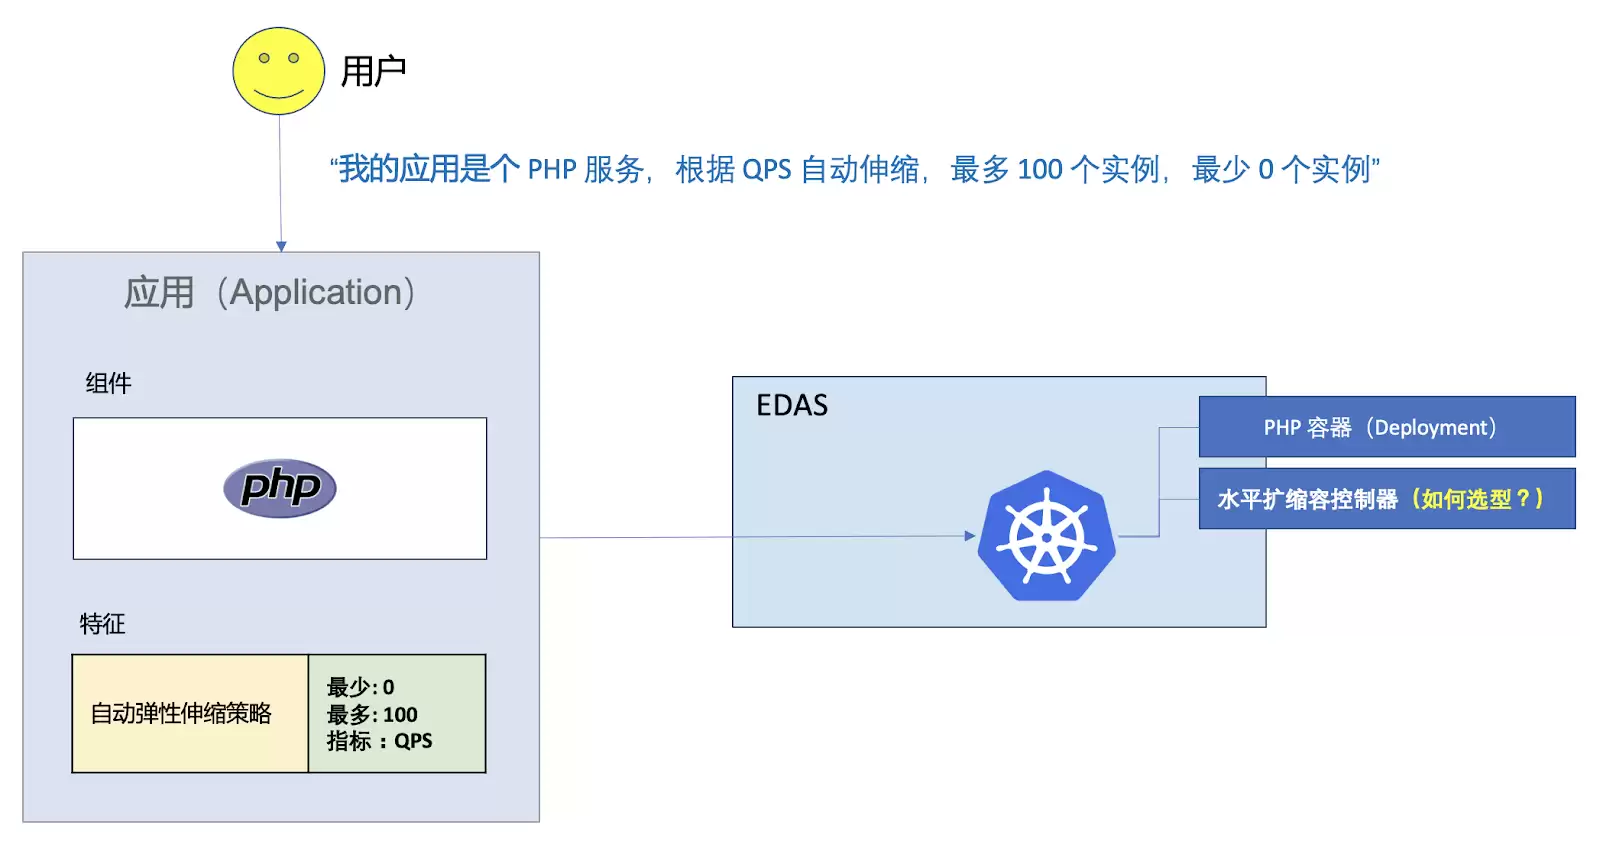
导读:在云原生技术栈逐渐普及之后,如何能够以效率更高、用户更容易接纳的方式落地 Kubernetes 技术体系,让云原生的发挥出真正的价值,正在迅速成为大家津津乐道的一个话题和全新的挑战。而伴随着大家对云原技术的关注点从“怎么用”逐渐上升到“怎么用的更好’上来,CNCF 应用交付领域小组(CNCF
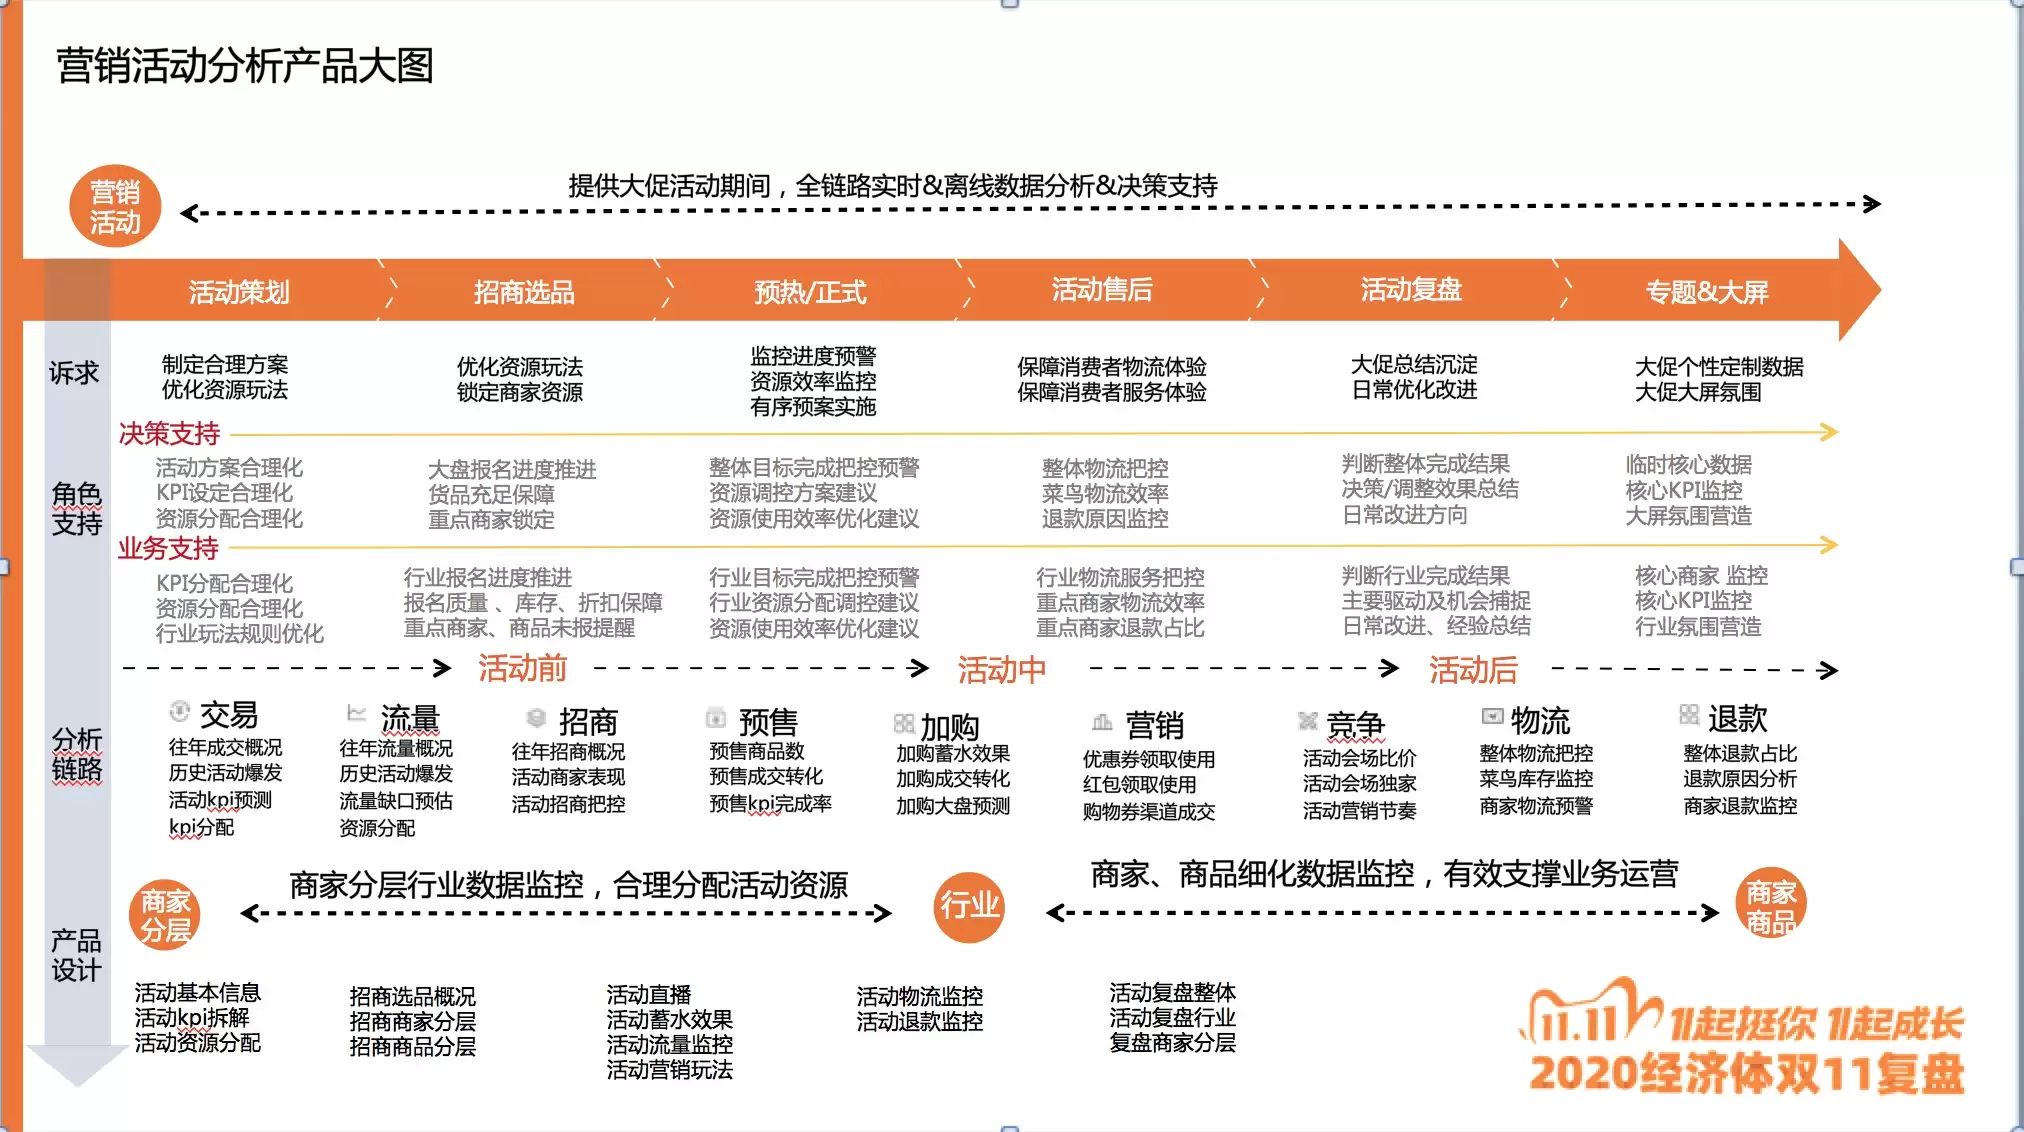
简介: 本篇将重点介绍Hologres在阿里巴巴淘宝营销活动分析场景的最佳实践,揭秘Flink+Hologres流批一体首次落地阿里双11营销分析大屏背后的技术考验。 概要:刚刚结束的2020天猫双11中,MaxCompute交互式分析(下称Hologres)+实时计算Flink搭建的云原生实时数仓
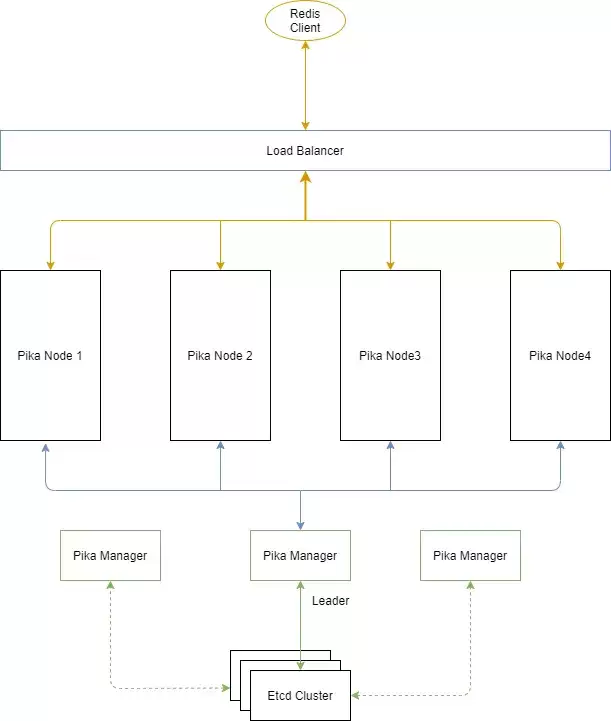
背景Pika是一款可持久化的大容量redis存储服务,它在string、hash、list、zset、set等方面,与redis绝大部分接口兼容(兼容详情可查看相关文档)。它能解决redis因存储数据量巨大而面临的内存不足这一容量瓶颈问题。用户迁移到pika服务时,无需对代码做任何修改。其兼容性和稳
自从2009年入职百度以来,已经经历了11年了,我自己从一线研发工程师开始,也逐步成长成为了带领复杂技术方向的技术负责人。10年多的工作历程,让我有幸经历了大范围的技术演变,特别是云计算和云原生技术从朦胧到普及,对工程师和架构师的要求也发生了不少变化。趁着自己入职11周年的日子,结合我自己在百度的
导读:曾经看上去很美、一直被观望的 Serverless,现已逐渐进入落地的阶段。今年的"十一出行节",高德在核心业务规模化落地 Serverless,由 Serverless 支撑的业务在流量高峰期的表现十分优秀。传统应用也能带来同样的体验,那么 Serverless 的差异化价值又是什么呢?本文
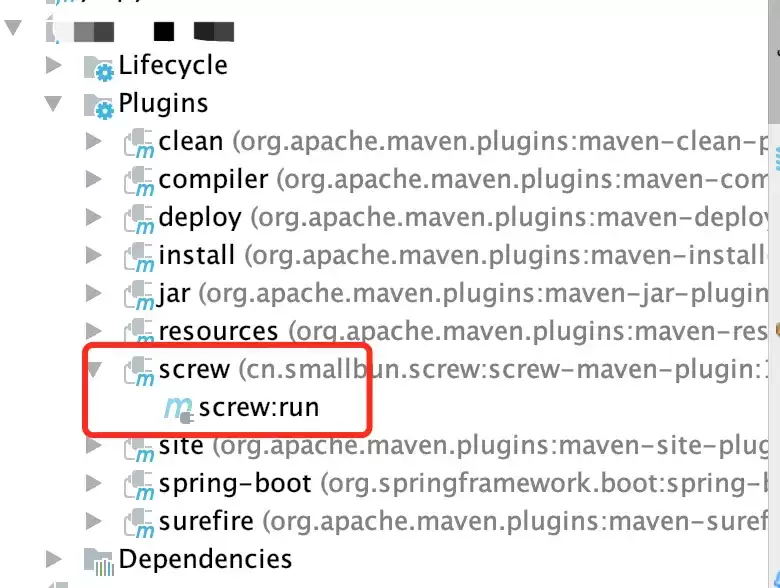
在企业级开发过程中,编写数据库表结构文档是一项常见的工作。我从业多年,也待过几家企业,发现数据库表结构文档的状态普遍不太理想:要么根本没有,要么有也是手写的。在后期运维开发时,还需要手动将变更维护到文档中,这是一件非常繁琐的事情。如果忘记了一次维护,就会给以后的工作带来很多麻烦,给自己和后来的同事都
长久以来,我们致力于做到三件事: 实践指南、减少模板代码和简化任务流程,我们希望帮助开发者们集中精力专注在真正需要考虑的逻辑中去。Jetpack 为此而生,它所包含的库、工具和指南,可以帮助您更轻松地编写高质量的应用。Jetpack 和 AndroidX 有什么关系呢? Jetpack 中所有库都使
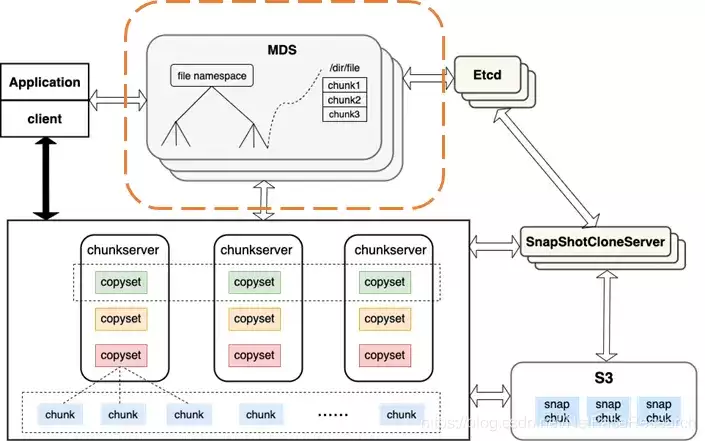
Curve简介Curve是网易数帆于今年7月份开源的一个高性能、高可用、高可靠的分布式存储系统,主打高性能、低延迟。Curve设计可以作为多种存储场景的底层存储:例如块存储,对象存储,云原生数据库,EC等。当前Curve已实现高性能块存储,并且基于这⼀场景对接了OpenStack 和 Kuberne
原文:https://hackernoon.com/cold-starts-in-aws-lambda-f9e3432adbf0作者:Serhat Can译者:donghui关于AWS Lambda中的冷启动,有不少相关的博客文章。我正在进行一些研究,希望在此列出一些优质文章以及关键要点,以便大家能
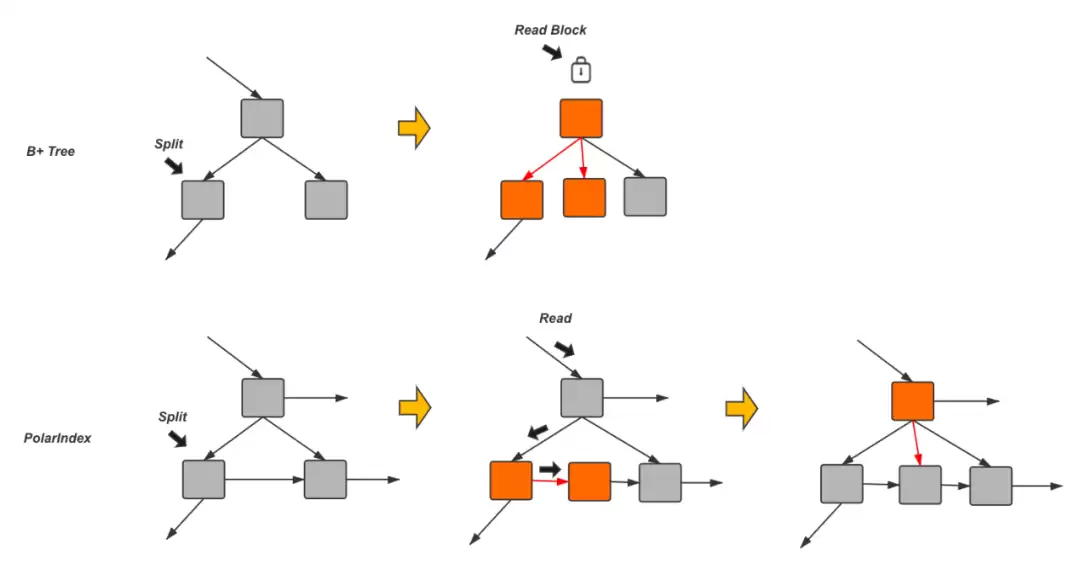
2020年是云原生数据库PolarDB全面支撑天猫双十一的第二年,天猫交易、买家、卖家以及物流等系统在双十一期间基于PolarDB为亿万客户提供了顺滑的体验。同时,PolarDB还刷新了去年由自己创造的数据库处理峰值(TPS)纪录,今年TPS峰值高达1.4亿次/秒,较去年提升了60%。PolarDB
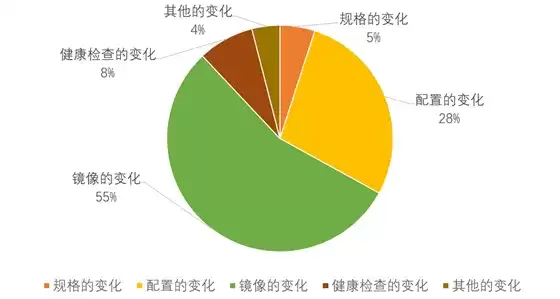
1. 对于可变基础设施的思考1.1 kubernetes中的可变与不可变基础设施在云原生逐渐盛行的现在,不可变基础设施的理念已经逐渐深入人心。不可变基础设施最早是由Chad Fowler于2013年提出的,其核心思想为任何基础设施的实例一旦创建之后变成为只读状态,如需要修改和升级,则使用新的实例进行
一年一度的 “双11” 大促中,交易额每年都在刷新,承接这些交易商品的快递包裹的数量也在成倍增长。这些快速的增长对物流系统带来了巨大的挑战,让物流管理更加敏捷来应对 “双11” 成为了必须解决的问题。申通是目前国内最大的物流公司之一,为了解决 “双11” 的技术挑战,申通在物流场景引入 IOT、大数
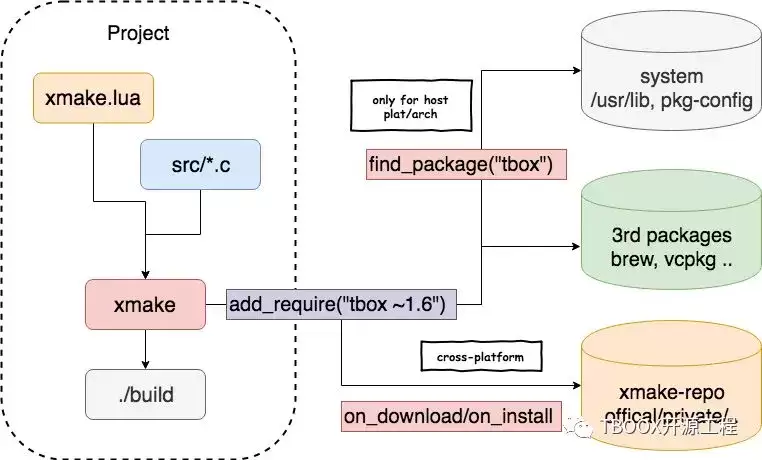
xrepo 是一个基于 Xmake 的跨平台 C/C++ 包管理器。项目源码官方文档xrepo虽基于xmake的运行时,但却是个独立完整的包管理程序。与vcpkg/homebrew这类包管理器相比,xrepo能为更多平台和架构提供C/C++包。并且还支持多版本语义选择,另外它还是一个去中心化的分布式


火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



